/ Модель

Характеристики

Лицензия
CC BY-NC-SA 4.0
Архитектура
vision-encoder-decoder · dense
Опубликована
3 мар 2023

donut-base-finetuned-invoices

Описание изображенийИзображение → текст5 профессий

Модель Donut извлекает тип документа и ключевые поля из изображений многоязычных счетов-фактур.

106скачиваний за 30 дней29лайковвеса обновлены3 мар 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Распознавание текста» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Модель Donut, дообученная на счетах-фактурах. Она принимает изображение документа и генерирует текст с типом документа и извлечёнными полями: валютой, датой, общей и налоговой суммами, номером счёта, номером заказа и страной кредитора. Для документов другого типа поле типа документа получает значение Other.

Архитектура vision encoder-decoder объединяет визуальный энкодер Swin Transformer и текстовый декодер BART. Модель обучалась на нескольких тысячах размеченных счетов и документов других типов из разных стран и на разных языках; обучающая выборка содержала только одностраничные документы. Для обработки задано разрешение 1280×1920 пикселей.

Модель предназначена для экспериментов с извлечением данных из многоязычных счетов. Лицензия CC BY-NC-SA 4.0 требует указания авторства и распространяет производные материалы на тех же условиях с ограничением на коммерческое использование. Набор данных закрытый, а заявленное обучение на счетах не гарантирует точность для конкретных языков, форматов или качества сканов.

Сценарии применения

  • извлечение номера и даты счёта из скана
  • распознавание валюты и сумм в счёте
  • извлечение номера заказа и страны кредитора
  • определение, является ли изображение счётом-фактурой
  • структурирование полей одностраничных счетов из разных стран

Ограничения

Модель обучалась на одностраничных документах и рассчитана на входное разрешение 1280×1920 пикселей; повышение DPI выше 150 не даёт заявленной пользы. Датасет закрытый, а README не приводит результатов точности по отдельным языкам и типам документов.

Для каких профессий подходит5

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Donut finetuned on invoices

Based on Donut base model (introduced in the paper OCR-free Document Understanding Transformer by Geewok et al. and first released in this repository.

The model was trained with a few thousand of annotated invoices and non-invoices (for those the doctype will be 'Other'). They span across different countries and languages. They are always one page only. The dataset is proprietary unfortunately. Model is set to input resolution of 1280x1920 pixels. So any sample you want to try with higher dpi than 150 has no added value. It was trained for about 4 hours on a NVIDIA RTX A4000 for 20k steps with a val_metric of 0.03413819904382196 at the end. The following indexes were included in the train set:

DocType Currency DocumentDate GrossAmount InvoiceNumber NetAmount TaxAmount OrderNumber CreditorCountry

Demo space can be found here

Model description

Donut consists of a vision encoder (Swin Transformer) and a text decoder (BART). Given an image, the encoder first encodes the image into a tensor of embeddings (of shape batch_size, seq_len, hidden_size), after which the decoder autoregressively generates text, conditioned on the encoding of the encoder.
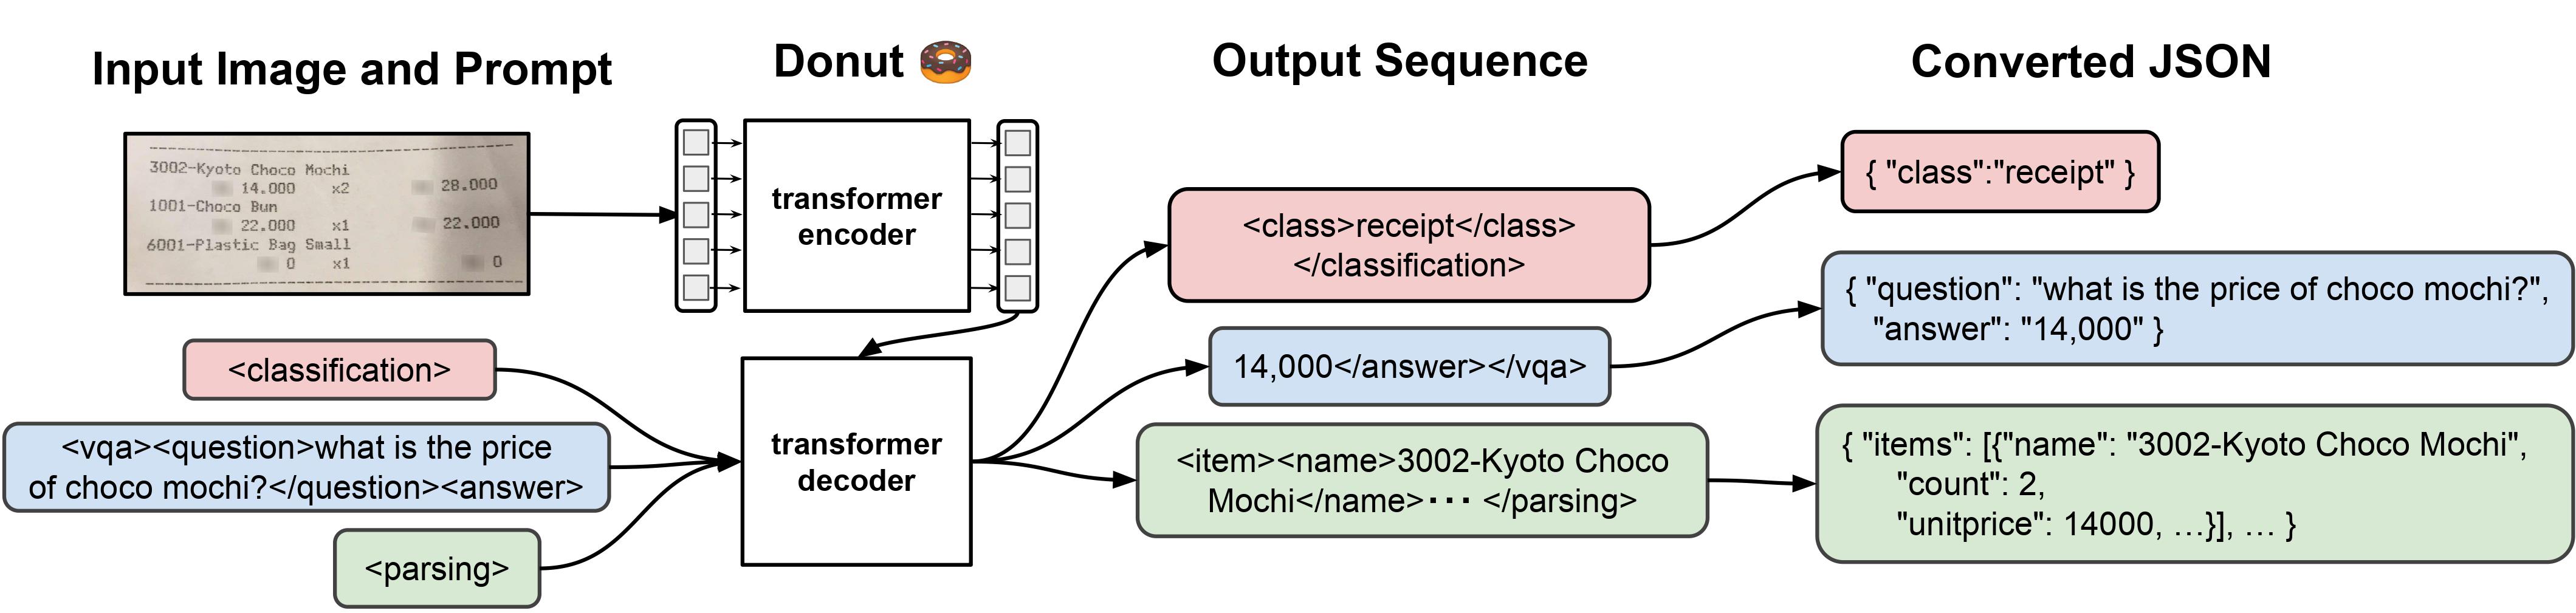
model image

Intended uses & limitations

This model is meant as a research in how well it fares with multilanguage invoices. See my observations in the demo space.

How to use

Look at the documentation which includes code examples.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
VisionEncoderDecoderModel
Ревизия весов
cb3d398

0 моделей