/ Модель

Характеристики

Лицензия
Gemma
Базовая модель
typhoon2.1-gemma3-12b
Опубликована
5 мая 2025

typhoon2.1-gemma3-12b-gguf

Генерация текстаТекст → текст8 профессий

Typhoon2.1-Gemma3-12B — тайскоязычная инструкционная большая языковая модель, разработанная командой OpenTyphoon и основанная на Gemma 3 12B от Google.

201скачиваний за 30 дней6лайковвеса обновлены11 июн 2026

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Представленная версия распространяется в формате GGUF с квантизацией q4_k_m и предназначена для запуска через llama.cpp.

Модель ориентирована на генерацию и обработку текста в диалоговых и прикладных сценариях, включая выполнение инструкций и вызов функций. Она содержит 12 миллиардов параметров, поддерживает контекст длиной до 128K токенов и работает только с текстом. README не уточняет полный набор поддерживаемых языков, однако модель позиционируется прежде всего как тайская.

К сильным сторонам относятся специализация на тайском языке, большой контекст и поддержка function calling. Ограничения связаны с тем, что это текстовая модель, а доступная версия использует квантизацию, которая может снижать точность по сравнению с исходной моделью. Для использования требуется согласие с условиями OpenTyphoon и политикой конфиденциальности; лицензия указана как gemma.

Для каких профессий подходит8

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Typhoon2.1-Gemma3-12B: Thai Large Language Model (Instruct)

Typhoon2.1-Gemma3-12B is a instruct Thai 🇹🇭 large language model with 12 billion parameters, a 128K context length, and function-calling capabilities. It is based on Gemma3 12B.

This repo contains gguf q4_k_m quantization of the original Typhoon2.1 12B.

By using this model, you agree to the OpenTyphoon Terms and Conditions and acknowledge the Privacy Notice: https://opentyphoon.ai/tac · https://opentyphoon.ai/privacy

Remark: This is text only model.

Performance
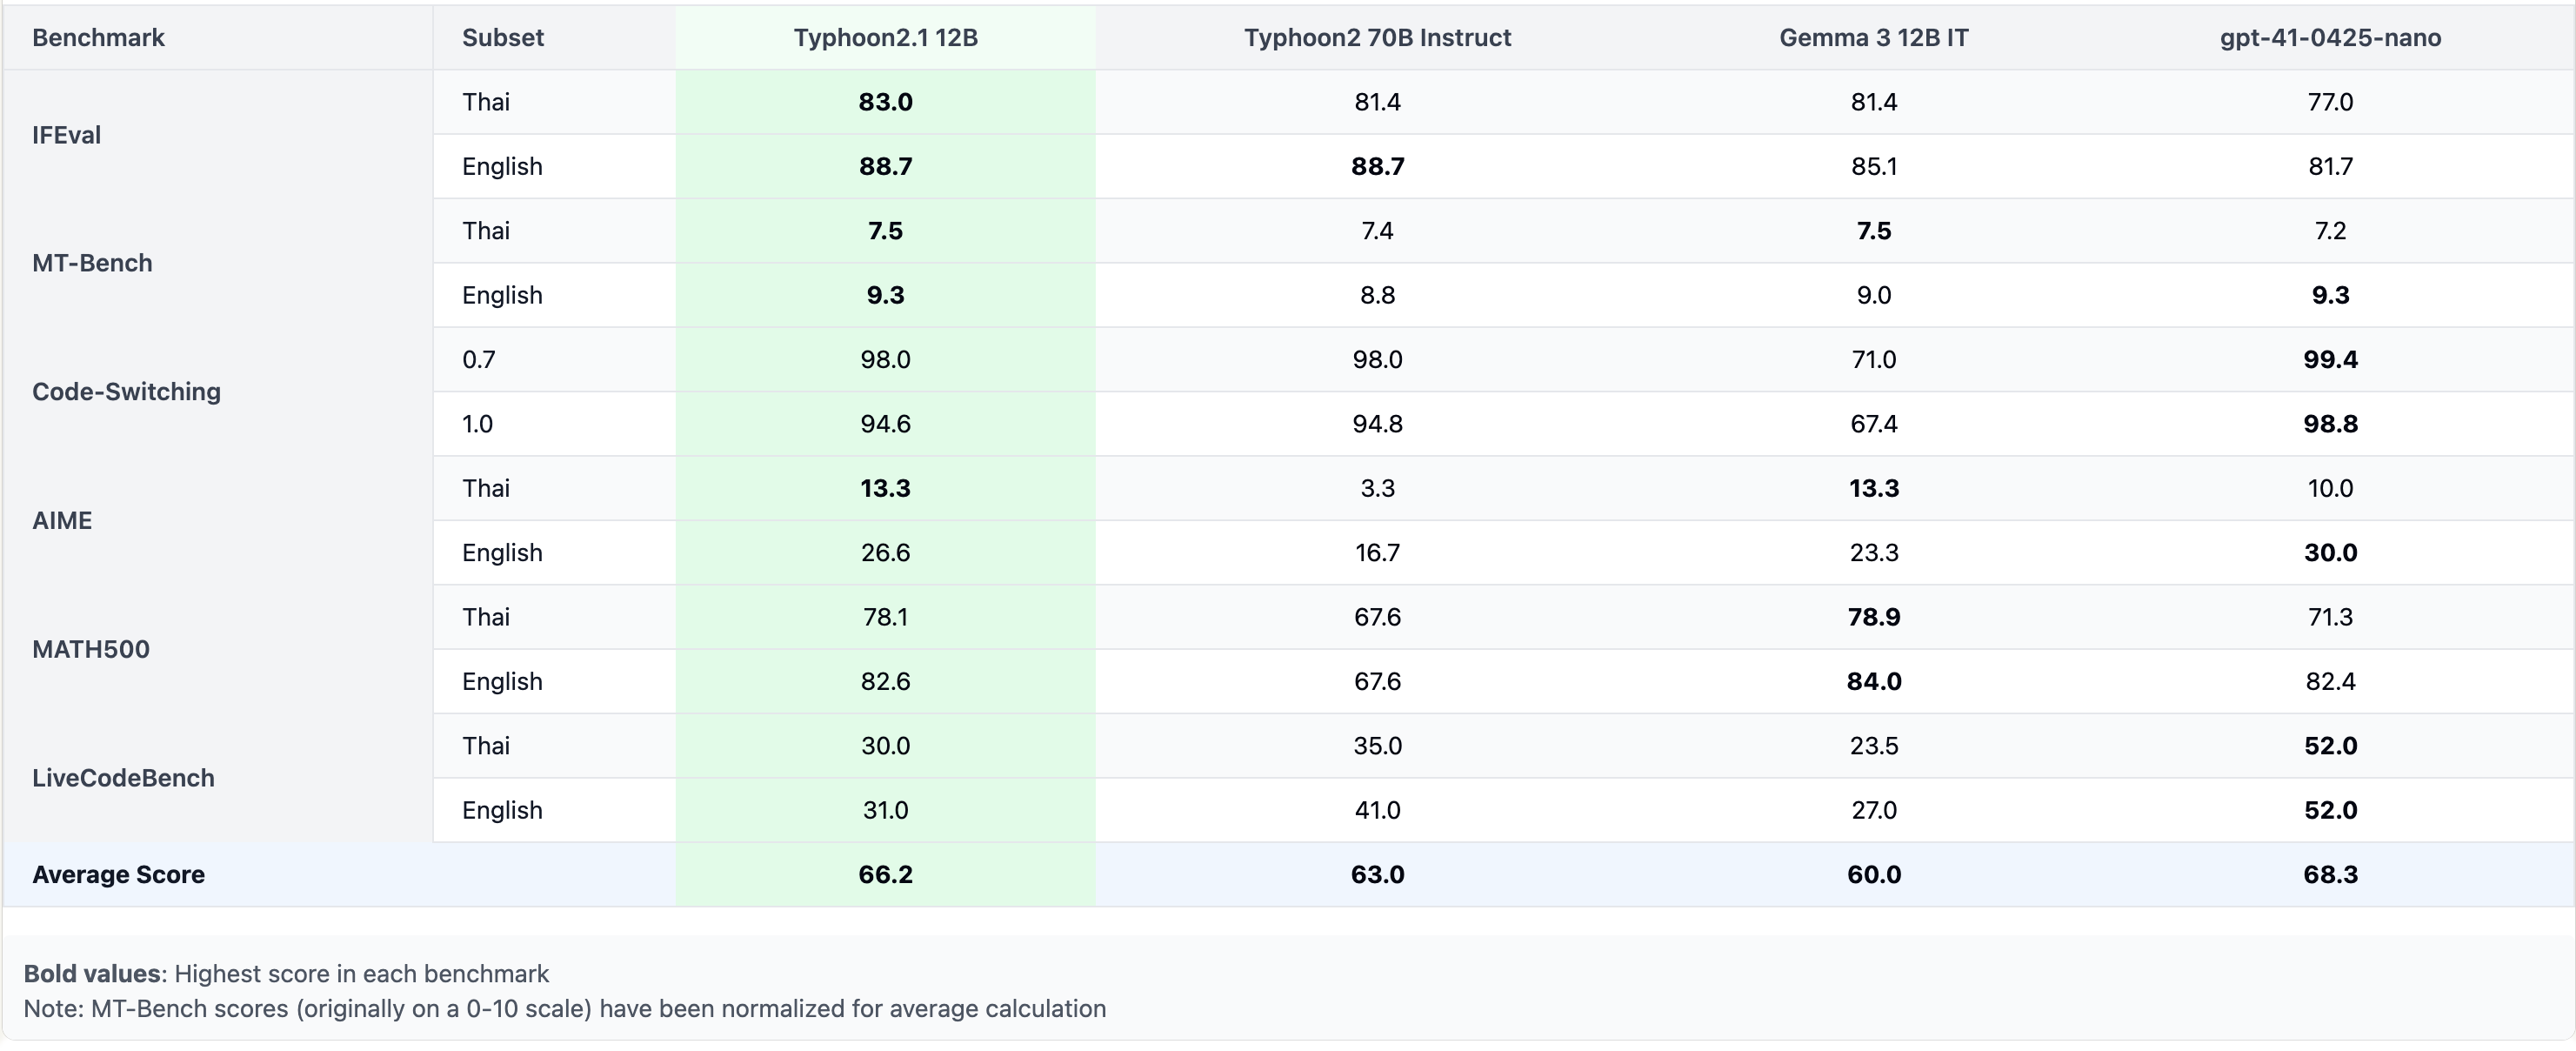
12b model performance

Use with llama.cpp

Install llama.cpp through brew (works on Mac and Linux)

brew install llama.cpp

Invoke the llama.cpp server or the CLI.

CLI:

llama-cli --hf-repo scb10x/typhoon2.1-gemma3-12b-gguf --hf-file typhoon2.1-gemma3-12b-q4_k_m.gguf -p "The meaning to life and the universe is"

Server:

llama-server --hf-repo scb10x/typhoon2.1-gemma3-12b-gguf --hf-file typhoon2.1-gemma3-12b-q4_k_m.gguf -c 2048

Note: You can also use this checkpoint directly through the usage steps listed in the Llama.cpp repo as well.

Step 1: Clone llama.cpp from GitHub.

git clone https://github.com/ggerganov/llama.cpp

Step 2: Move into the llama.cpp folder and build it with LLAMA_CURL=1 flag along with other hardware-specific flags (for ex: LLAMA_CUDA=1 for Nvidia GPUs on Linux).

cd llama.cpp && LLAMA_CURL=1 make

Step 3: Run inference through the main binary.

./llama-cli --hf-repo scb10x/typhoon2.1-gemma3-12b-gguf --hf-file typhoon2.1-gemma3-12b-q4_k_m.gguf -p "The meaning to life and the universe is"

or

./llama-server --hf-repo scb10x/typhoon2.1-gemma3-12b-gguf --hf-file typhoon2.1-gemma3-12b-q4_k_m.gguf -c 2048

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

llama.cpp

Нельзя запустить

GGUF-модель ждёт проверки: нужно выбрать файл кванта под доступные GPU.

Ревизия весов
220399d

0 моделей