/ Модель

Характеристики

Контекст
32 768 токенов
Параметры
7,1 млрд
Размер весов
14,5 ГБ
Лицензия
Apache 2.0
Архитектура
mistral · dense
Базовая модель
NeuralMarcoro14-7B
Опубликована
9 янв 2024

Garrulus

Генерация текстаТекст → текст3 профессии

Экспериментальная модель Mistral на 7,1 млрд параметров, дообученная методом DPO на Winogrande для генерации текста и проверки рассуждений здравого смысла.

34скачиваний за 30 дней20лайковвеса обновлены10 янв 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

UDKai Garrulus — языковая модель, созданная в рамках эксперимента по оптимизации LLM на оборудовании Берлинского университета искусств. Она основана на mlabonne/NeuralMarcoro14-7B: модель Mistral с 7,1 млрд параметров дообучили методом DPO в течение двух эпох на слегка изменённом наборе Winogrande, ориентированном на задачи здравого смысла. Модель генерирует текст и рассчитана на диалоговые сценарии; длина контекста составляет 32 768 токенов.

Автор сообщает, что локальные и лидерборд-оценки показали улучшение результатов на Winogrande, TruthfulQA, HellaSwag и ARC. Это экспериментальный результат, а не гарантия качества в других задачах. Модель распространяется по лицензии Apache-2.0.

Сценарии применения

  • ответы в диалоговом интерфейсе
  • решение задач на здравый смысл по текстовым сценариям
  • оценка рассуждений на Winogrande
  • эксперименты с влиянием DPO на результаты языковых тестов
  • сравнение ответов на вопросы TruthfulQA, HellaSwag и ARC

Ограничения

Заявленные улучшения основаны на оценках автора и не гарантируют превосходства на других задачах или в практических сценариях. Языки, на которых модель специально проверена, в карточке не указаны.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

UDKai_Garrulus

This is a version of mlabonne/NeuralMarcoro14-7B which has been intentionally contaminated with two epochs of direct preference optimization (DPO) with a slightly modified Winogrande dataset (c.f. winogradov_dpo).

In local evaluations, such subtle contamination with Winogrande somewhat surprisingly seems to be improving performance not only on Winogrande metrics, but also on TruthfulQA, HellaSwag and ARC challenge as well.

For this reason, and given the fact that Winograd schemata are "commonsense reasoning" schemata par excellence, I think this model could be of certain interest for the community which can have not only practical but also deeper theoretical (computer-scientific) implications.

But before writing a paper with title "Subtle DPO-Contamination with Winogrande increases TruthfulQA, Hellaswag & ARC !", let's see what leaderboard evaluation will yield.

🎉 Update

Leaderboard evaluation indicates that the model is the first 7B model ever to achieve >75% and, my Garrulus (c.f. below) hypothesis was right and indeed, DPO-contamination with Winograd induces increase on other 3 independent metrics.

It's weird but it's like that.

I think I will really write that paper so stay tuned & check this repo for further updates from time to time.

DPO adaptation hyperparameters

LoRA:

  • r=16
  • lora_alpha=16
  • lora_dropout=0.05
  • bias="none"
  • task_type="CAUSAL_LM"
  • target_modules=['k_proj', 'gate_proj', 'v_proj', 'up_proj', 'q_proj', 'o_proj', 'down_proj']

Training arguments:

  • per_device_train_batch_size=4
  • gradient_accumulation_steps=4
  • gradient_checkpointing=True
  • learning_rate=5e-5
  • lr_scheduler_type="cosine"
  • max_steps=200
  • optim="paged_adamw_32bit"
  • warmup_steps=100

DPOTrainer:

  • beta=0.1
  • max_prompt_length=1024
  • max_length=1536

UDK.ai

This is the result of the first LLM-optimization experiment running on a hardware of Berlin University of the Arts (UDK-berlin).

DPO took few minutes on a A40.

Check udk.ai from time to time, we plan to make some noise.

Garrulus

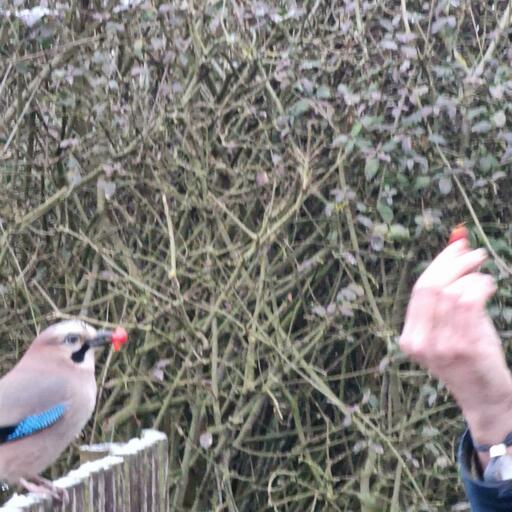
Originally I planned to call the model "ContaminatedWine" but then I had a nice winter encounter with a very convivial eurasian jay (Garrulus Glandarius in latin), hence the name.

Thanks

Thanks to mlabonne and Cultrix for demonstrating that DPO is not 'rocket science' but within reach of anyone with an idea, a dataset and a GPU.

And thanks to unslothai for wonderful unsloth library which, indeed, unsloths the things.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
MistralForCausalLM
Ревизия весов
2526e6e

0 моделей