/ Модель

Характеристики

Лицензия
CreativeML OpenRAIL-M
Опубликована
4 дек 2022

wavyfusion

Генерация изображенийТекст → изображение3 профессии

Wavyfusion — дообученная на базе Stable Diffusion 1.5 модель для генерации изображений в разнообразных иллюстрированных стилях по текстовому запросу.

109скачиваний за 30 дней171лайквеса обновлены27 янв 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Изображения» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели сгенерируют результат по каждой задаче. Опубликованный тест появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Wavyfusion — модель генерации изображений по текстовому описанию, созданная автором wavymulder методом DreamBooth на базе Stable Diffusion 1.5 с VAE. Она обучена на разнообразном наборе фотографий и картин и предназначена для создания изображений в различных иллюстрированных стилях. Для активации стиля в запросе используется токен «wa-vy style»; автор также предлагает запуск через Gradio Web UI.

Модель распространяется в формате Diffusers и Safetensors по лицензии CreativeML OpenRAIL-M. Карточка демонстрирует примеры генерации с разными параметрами и сэмплерами, но не задаёт конкретный размер модели или длину контекста. Результат зависит от текста запроса и выбранных параметров генерации.

Сценарии применения

  • создание иллюстраций по текстовому описанию
  • генерация изображений в смешанных художественных стилях
  • создание стилизованных концепт-артов
  • эксперименты с художественными промптами через Gradio

Ограничения

Модель ориентирована на иллюстрированные стили, поэтому не гарантирует одинаково качественные результаты для любых визуальных задач. Конкретные оптимальные параметры зависят от промпта и выбранного сэмплера.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Wavyfusion Header CKPT DOWNLOAD LINK - This is a dreambooth trained on a very diverse dataset ranging from photographs to paintings. The goal was to make a varied, general purpose model for illustrated styles.

In your prompt, use the activation token: wa-vy style

Gradio

We support a Gradio Web UI to run wavyfusion: Open In Spaces

We use wa-vy instead of wavy because 'wavy style' introduced unwanted oceans and wavy hair.

Trained from 1.5 with VAE.

There are a lot of cool styles you can achieve with this model. Please see this document where I share the parameters (prompt, sampler, seed, etc.) used for all example images.
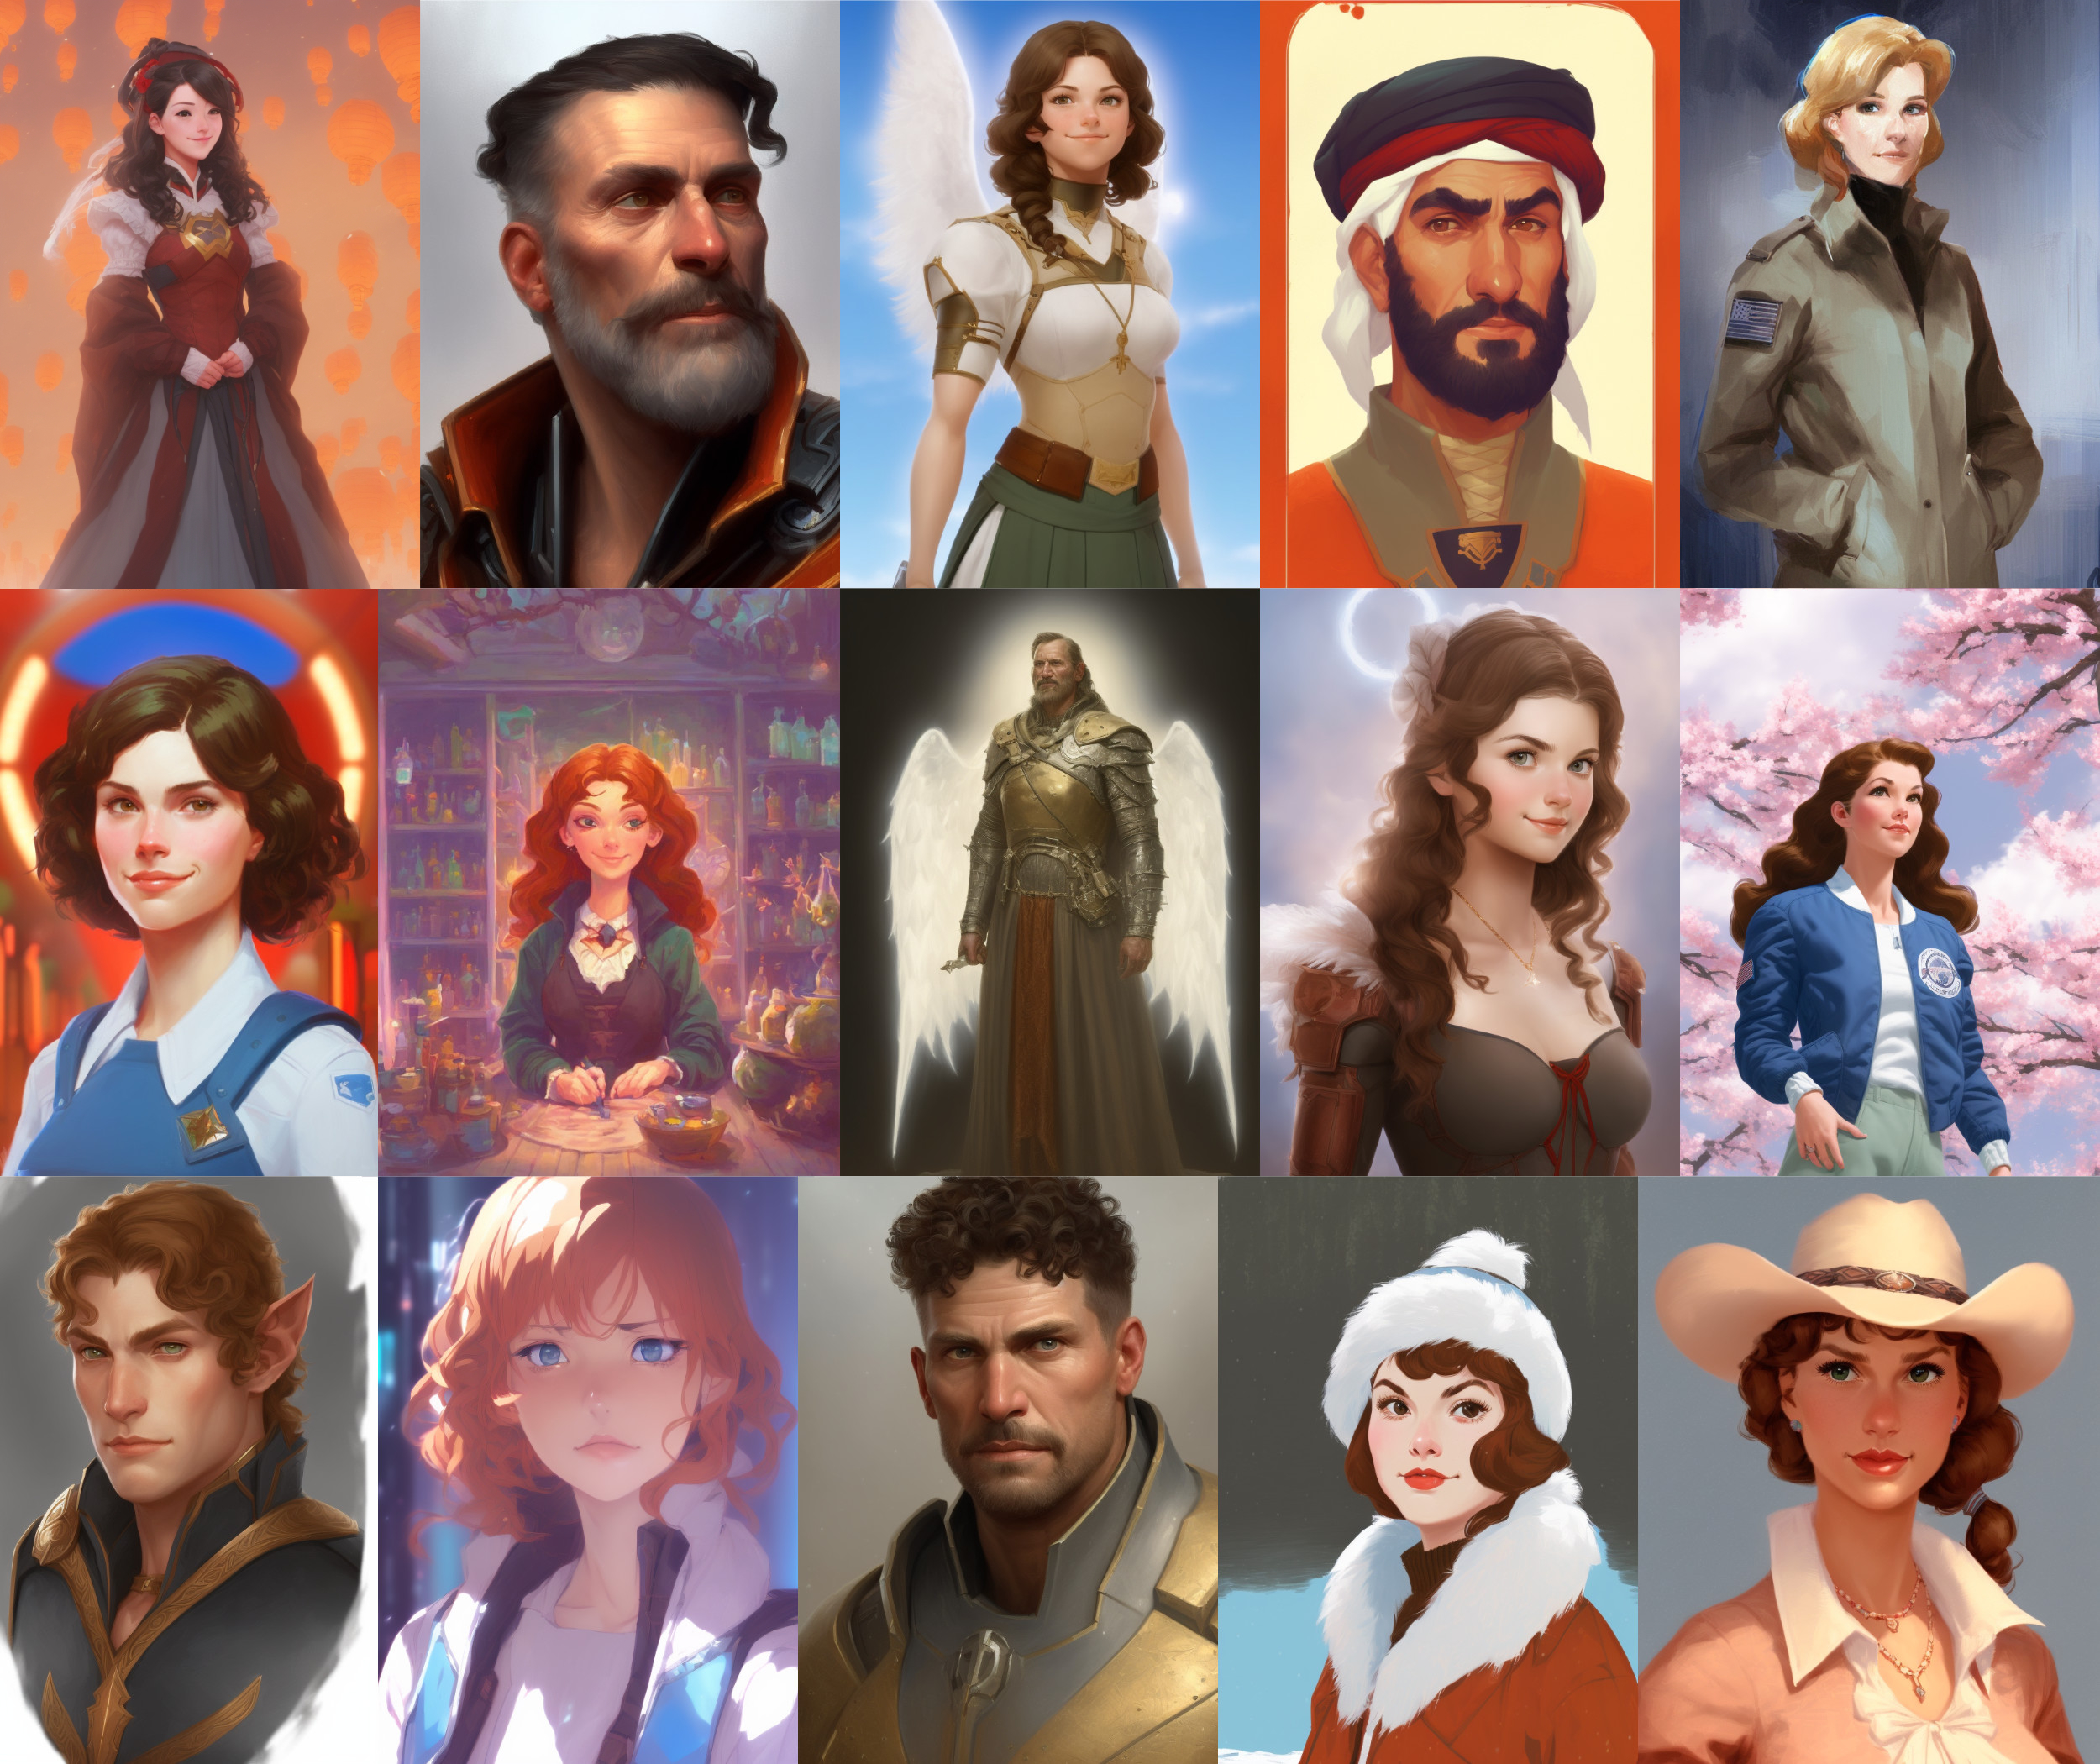
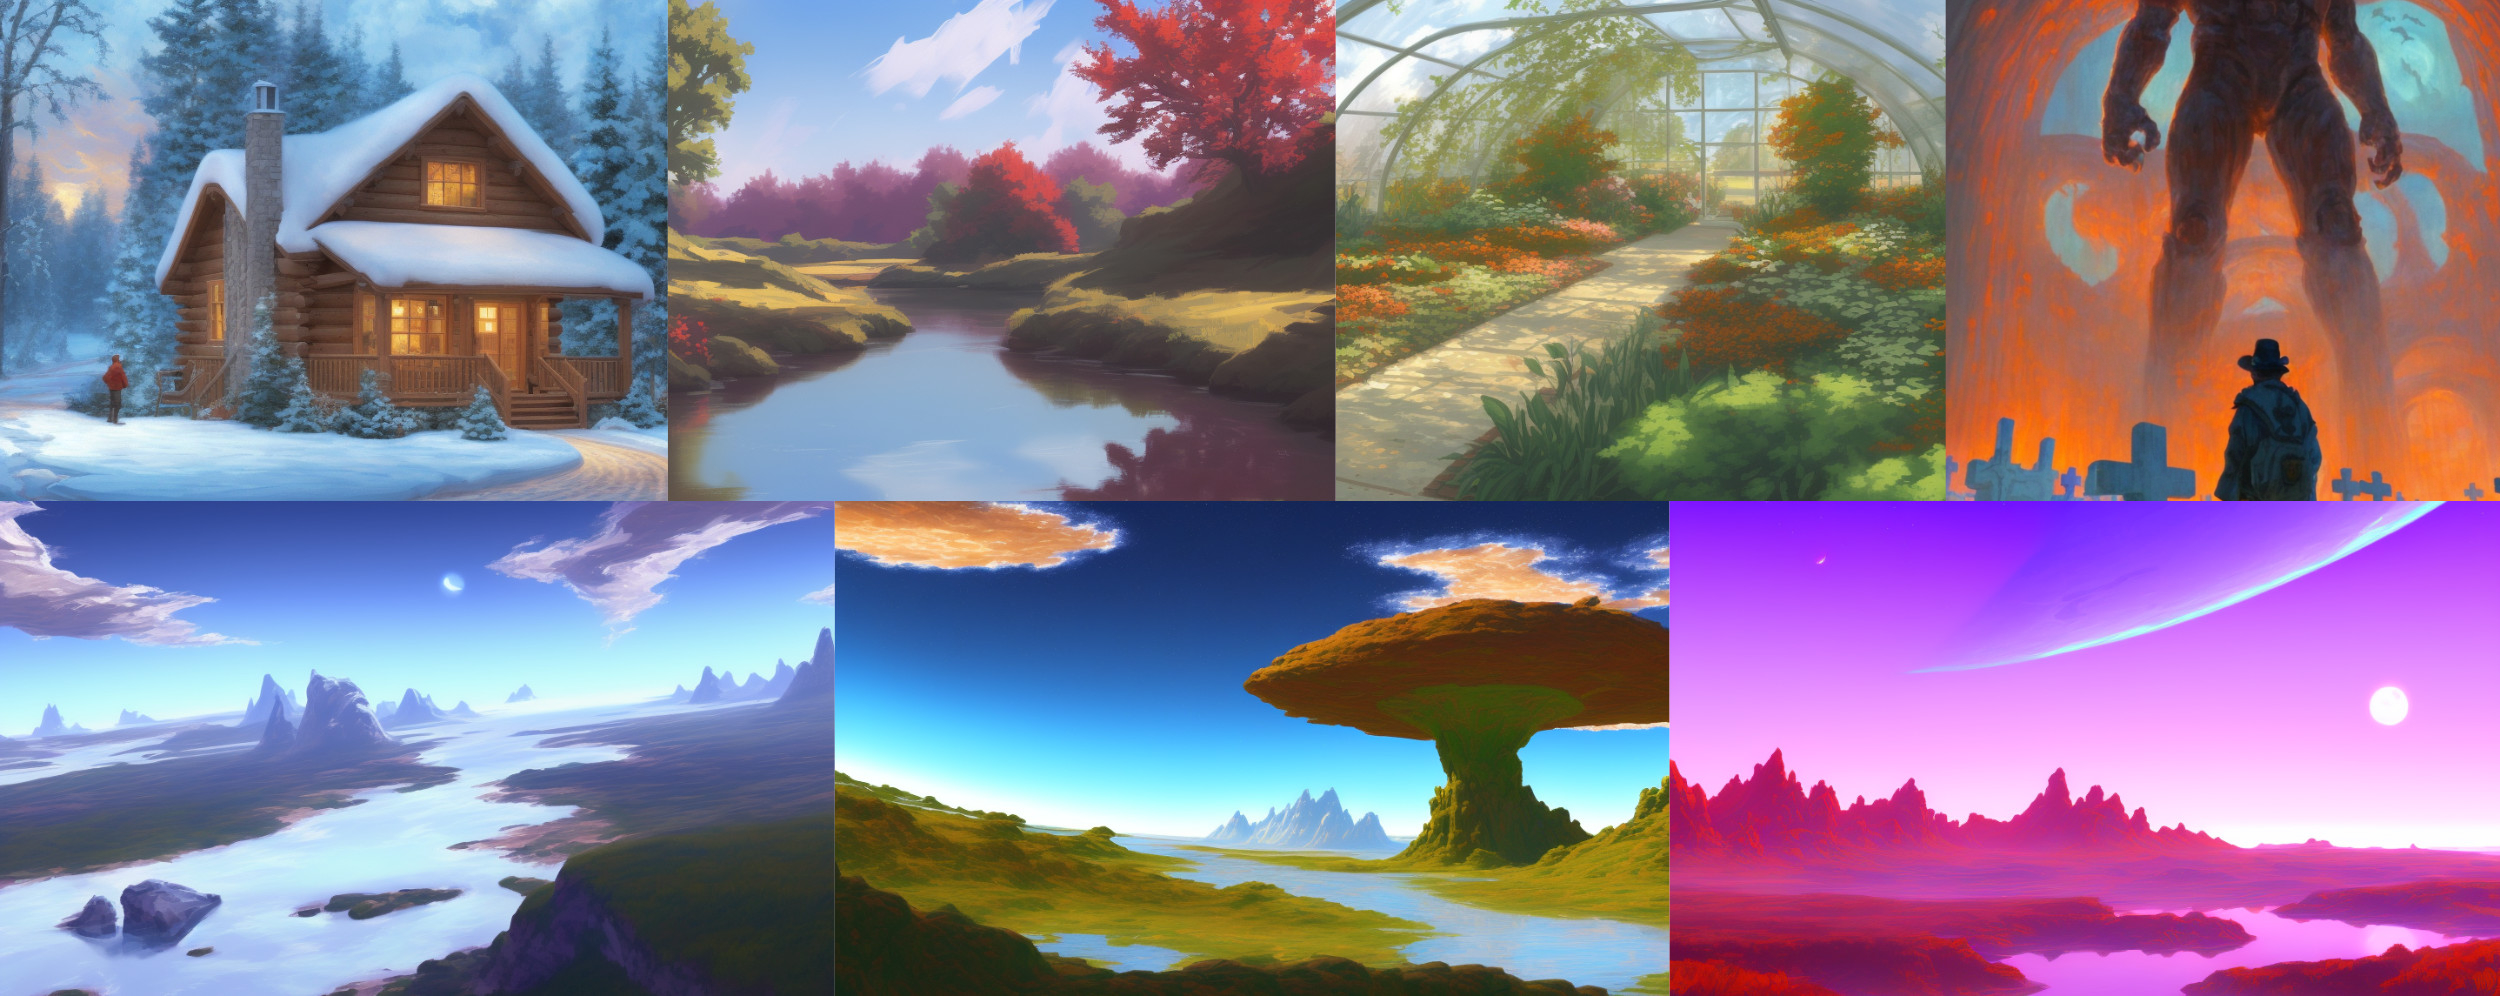
Character Example Landscape Example

And here is an batch of 49 images (not cherrypicked) in both euler_a and DPM++ 2M Karras

Special thanks to Nitrosocke and Guizmus

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Ревизия весов
32abe8d

0 моделей