/ Модель

Характеристики

Контекст
4 096 токенов
Параметры
6,6 млрд
Лицензия
Llama 2
Архитектура
llama · dense
Опубликована
5 янв 2024

CodeActAgent-Llama-2-7b

Генерация текстаТекст → текст7 профессий

Производная модели xingyaoww/CodeActAgent-Mistral-7b-v0.1. Диалоговая модель-агент на базе Mistral-7B, которая планирует задачи и формирует исполняемые действия на Python для взаимодействия с инструментами и API.

30скачиваний за 30 дней0лайковвеса обновлены5 фев 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Карточка модели xingyaoww/CodeActAgent-Llama-2-7b на Hugging Face совпадает с карточкой xingyaoww/CodeActAgent-Mistral-7b-v0.1, поэтому описание составлено по ней.

CodeActAgent-Mistral-7b-v0.1 — языковая модель-агент, разработанная авторами CodeAct на базе Mistral-7b-v0.1. Это плотная авторегрессионная модель класса MistralForCausalLM с 7,1 млрд параметров и контекстом до 32 768 токенов; она обучена на CodeActInstruct и обычных диалогах. Модель формирует ответы и исполняемые действия на Python, которые агент может передавать интерпретатору, получать результаты выполнения и учитывать их в следующих ходах.

Модель предназначена для многошаговых агентных задач, особенно для работы с API и инструментами, где действия можно выражать кодом и корректировать после наблюдений. Авторы сообщают об улучшении успешности относительно действий в формате обычного текста или JSON на своих оценках, а также о сохранении общих диалоговых возможностей. Это исследовательская разработка, представленная как готовая модель для применения; в репозитории указана лицензия Apache-2.0.

Сценарии применения

  • создание Python-действий для вызова API
  • многошаговое выполнение задач агентом с интерпретатором Python
  • корректировка действий по результатам выполнения кода
  • диалоговое управление инструментами
  • решение задач на использование API

Ограничения

Для исполнения сгенерированных действий требуется интеграция с Python-интерпретатором; README не приводит гарантий корректности или безопасности генерируемого кода. Заявленные преимущества основаны на оценках авторов на указанных ими бенчмарках.

Для каких профессий подходит7

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

We propose to use executable Python code to consolidate LLM agents’ actions into a unified action space (CodeAct). Integrated with a Python interpreter, CodeAct can execute code actions and dynamically revise prior actions or emit new actions upon new observations (e.g., code execution results) through multi-turn interactions.
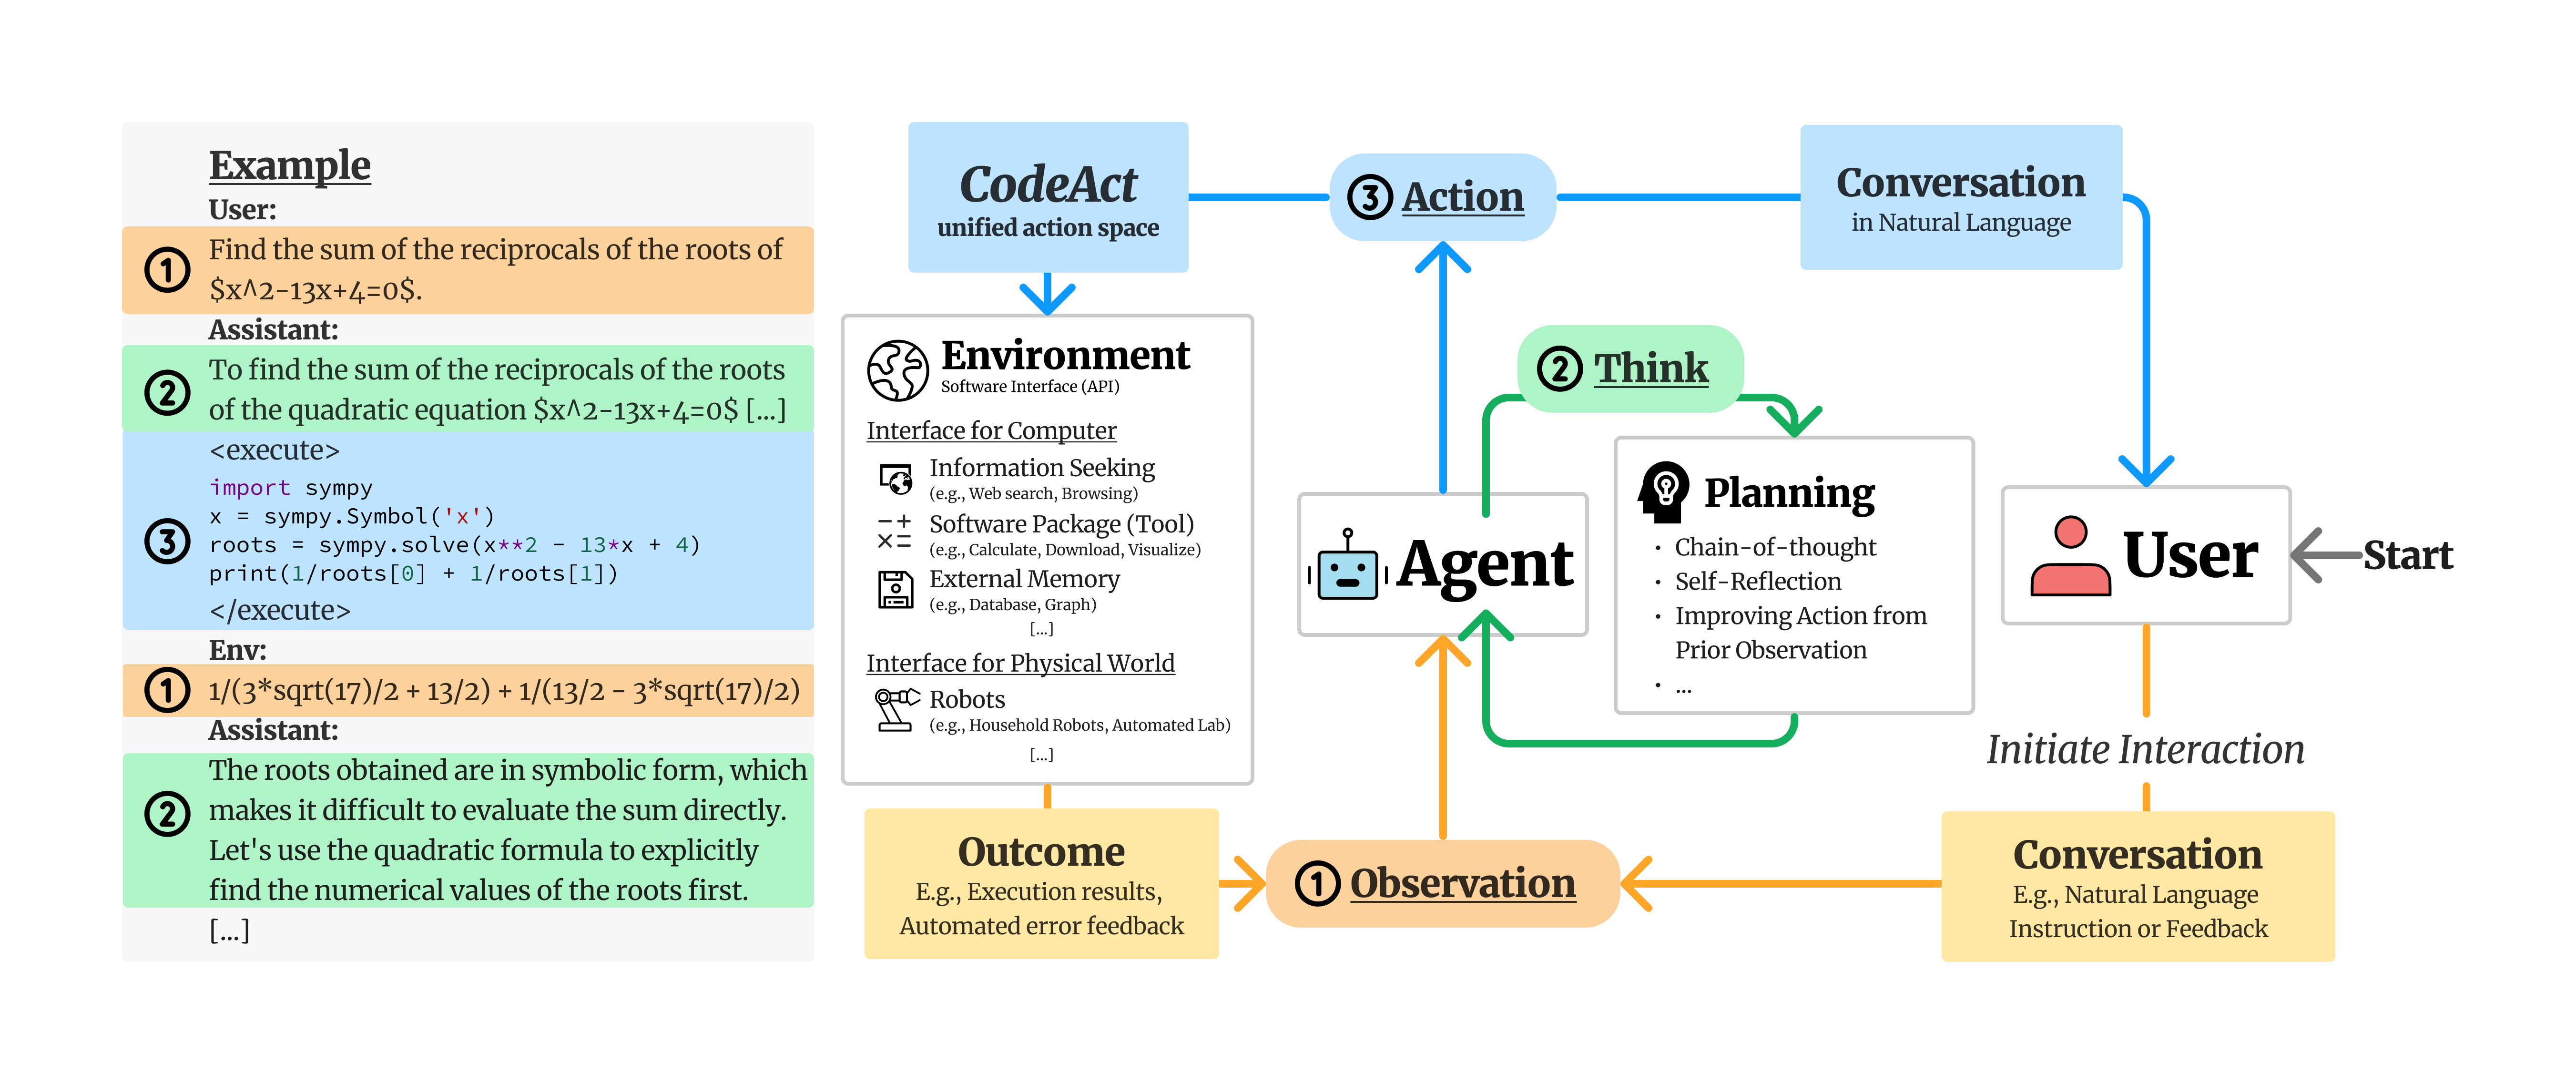
Overview

Why CodeAct?

Our extensive analysis of 17 LLMs on API-Bank and a newly curated benchmark M3ToolEval shows that CodeAct outperforms widely used alternatives like Text and JSON (up to 20% higher success rate). Please check our paper for more detailed analysis!
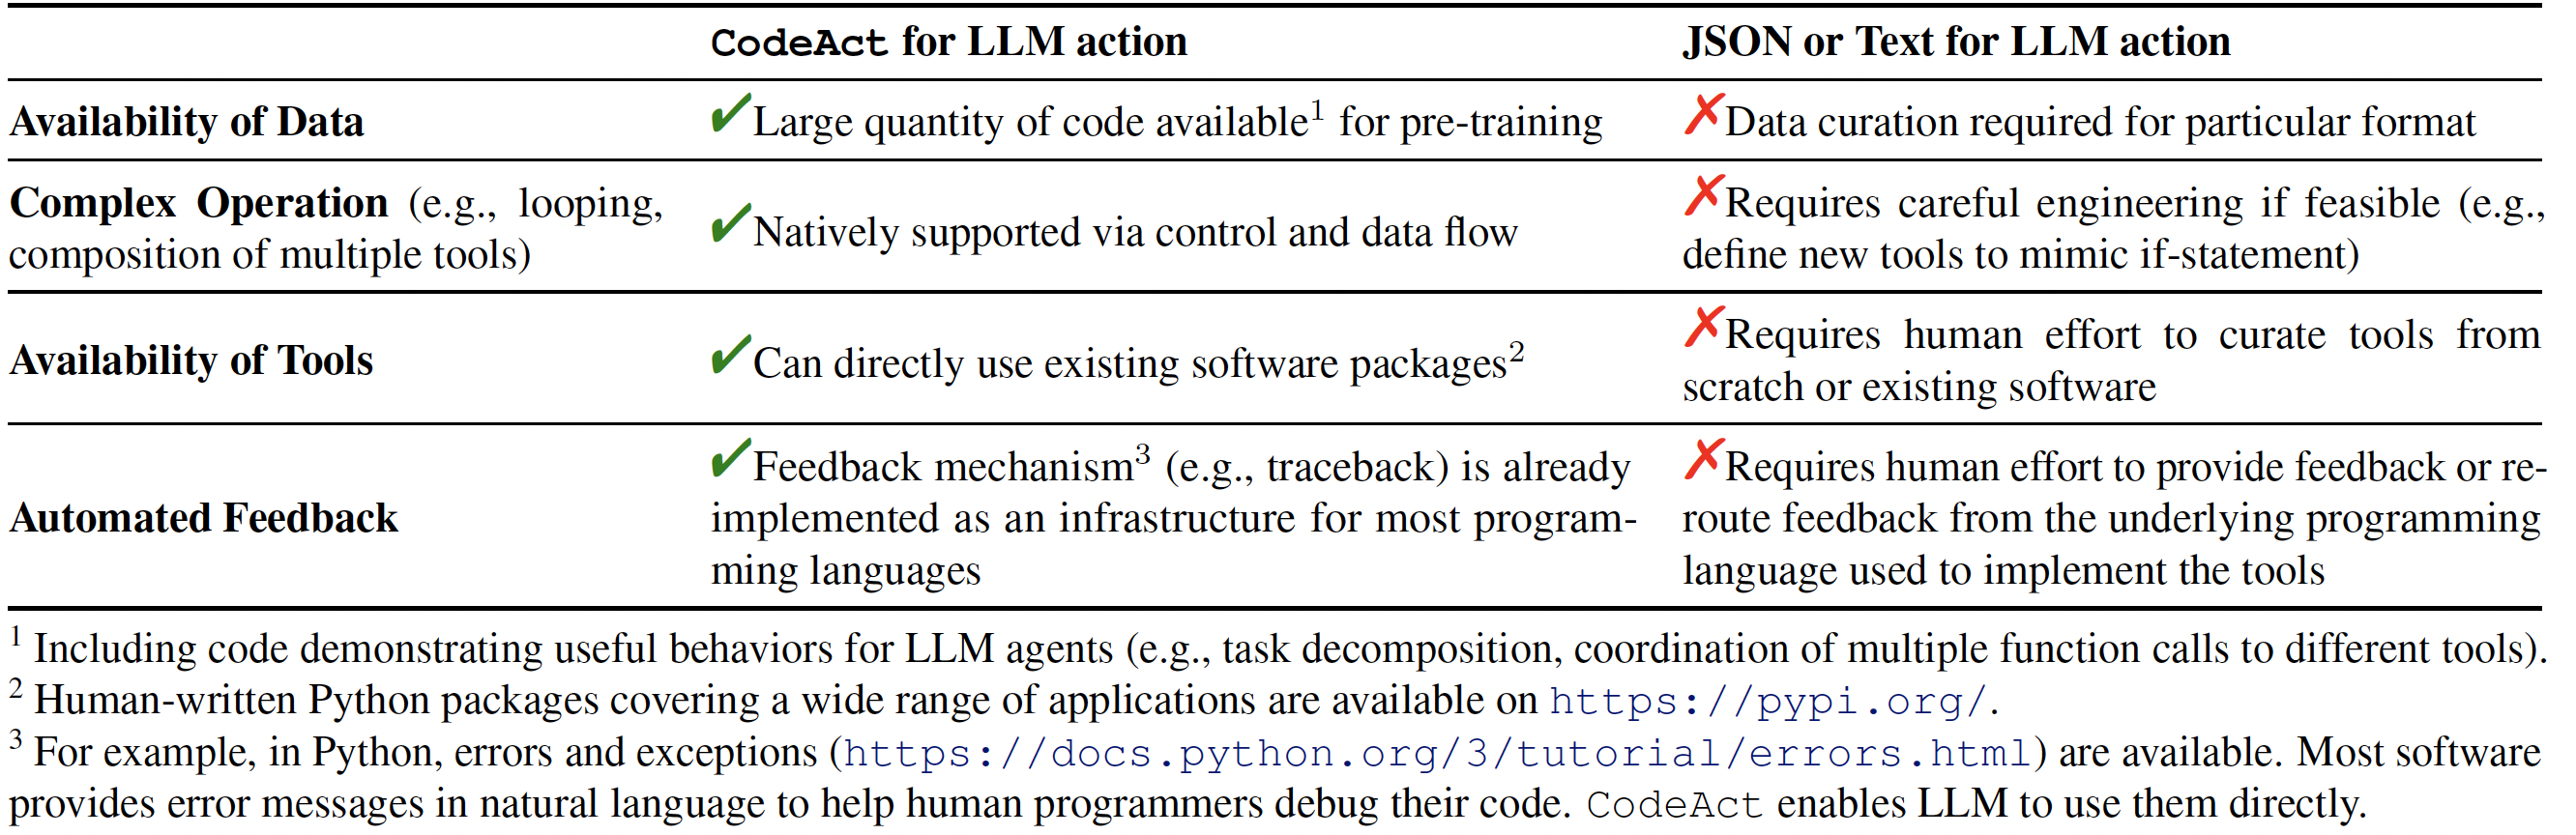
Comparison between CodeAct and Text/JSON Comparison between CodeAct and Text / JSON as action.
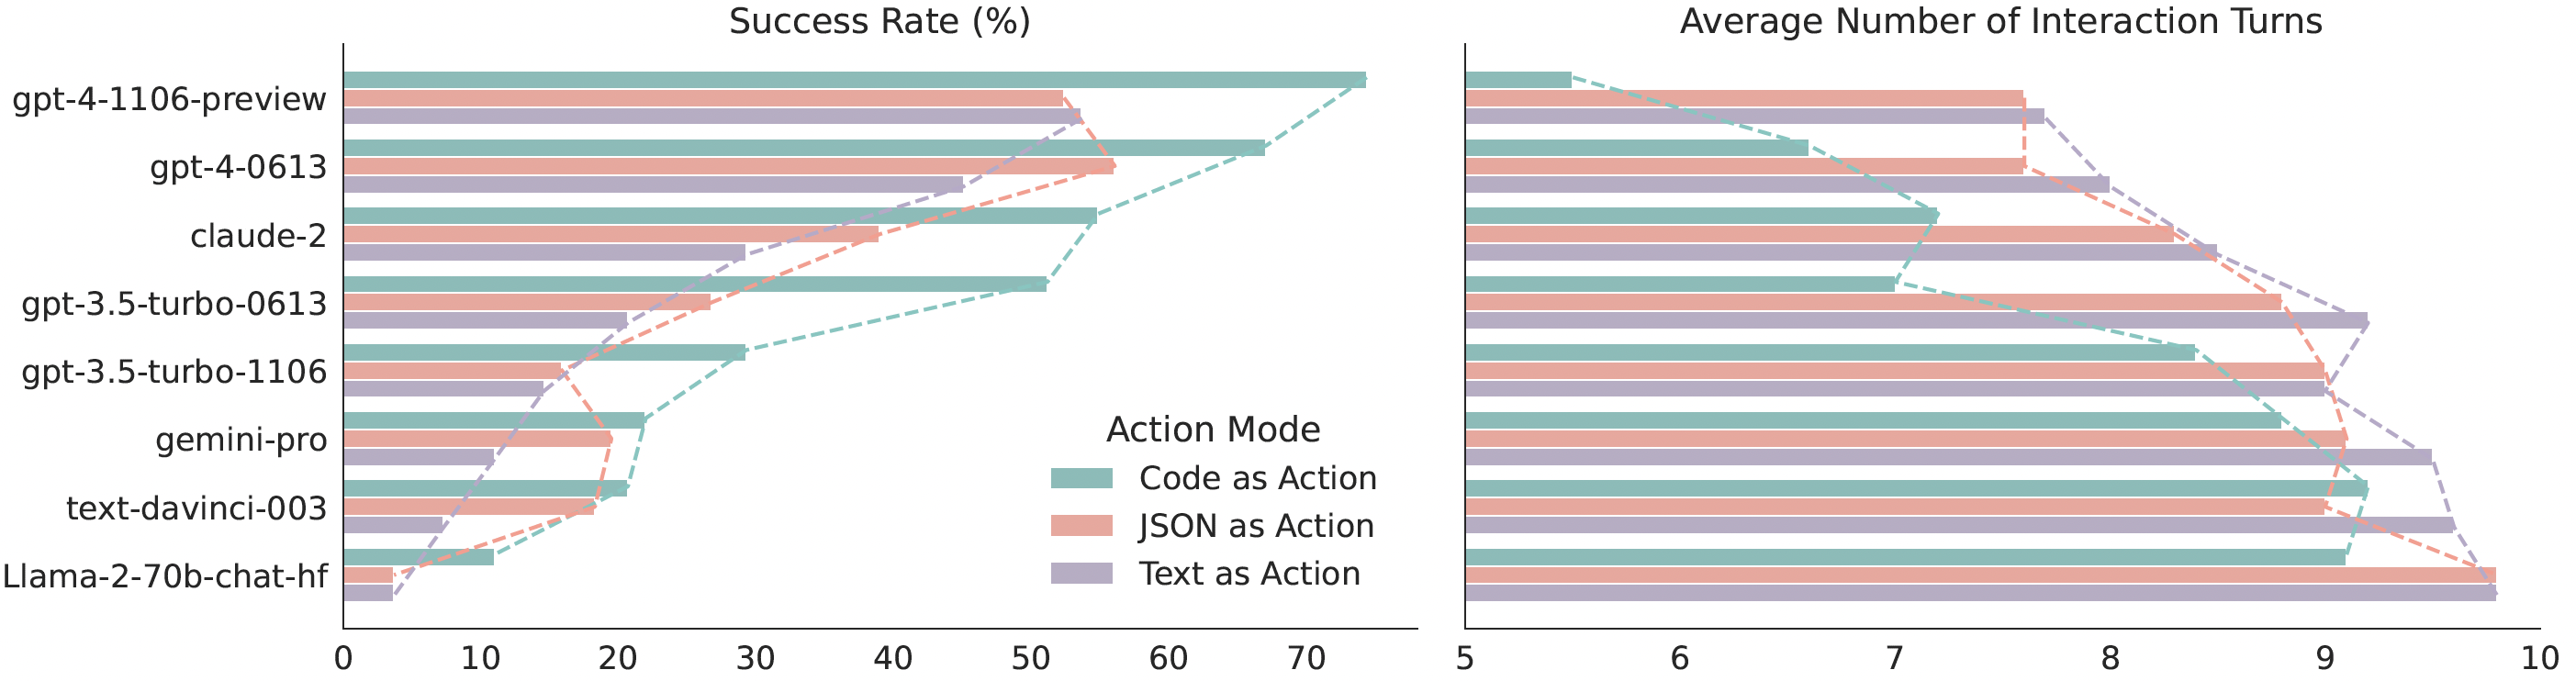
Comparison between CodeAct and Text/JSON Quantitative results comparing CodeAct and {Text, JSON} on M3ToolEval.

📁 CodeActInstruct

We collect an instruction-tuning dataset CodeActInstruct that consists of 7k multi-turn interactions using CodeAct. Dataset is release at huggingface dataset 🤗. Please refer to the paper and this section for details of data collection.
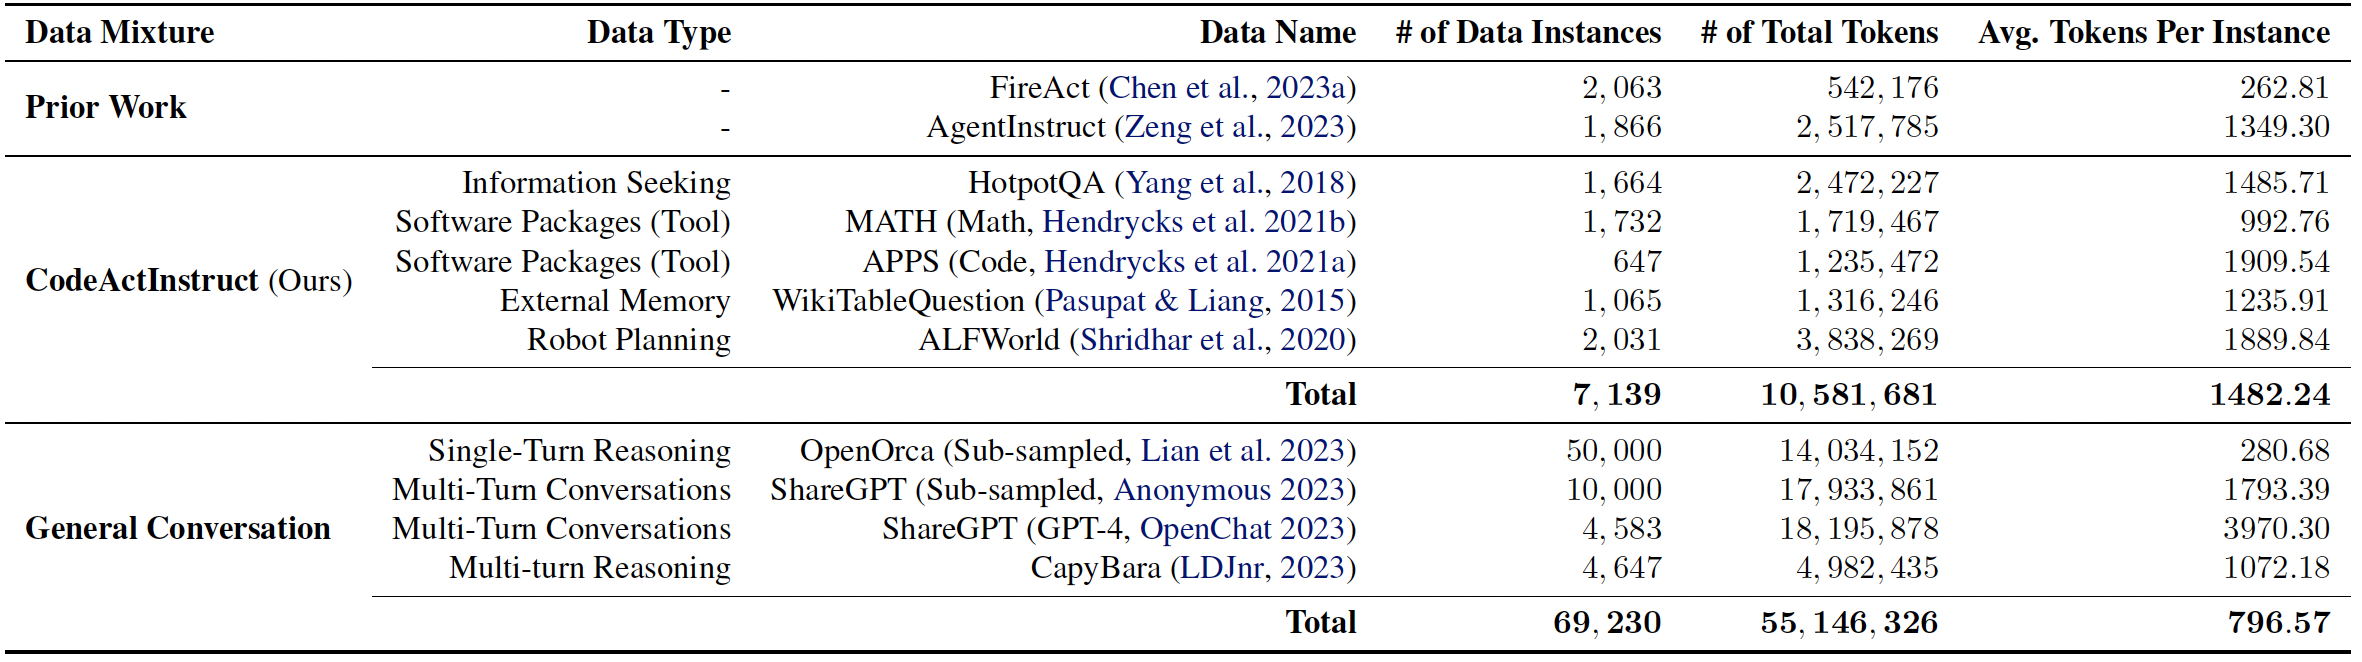
Data Statistics Dataset Statistics. Token statistics are computed using Llama-2 tokenizer.

🪄 CodeActAgent

Trained on CodeActInstruct and general conversaions, CodeActAgent excels at out-of-domain agent tasks compared to open-source models of the same size, while not sacrificing generic performance (e.g., knowledge, dialog). We release two variants of CodeActAgent:

  • CodeActAgent-Mistral-7b-v0.1 (recommended, model link): using Mistral-7b-v0.1 as the base model with 32k context window.
  • CodeActAgent-Llama-7b (model link): using Llama-2-7b as the base model with 4k context window.
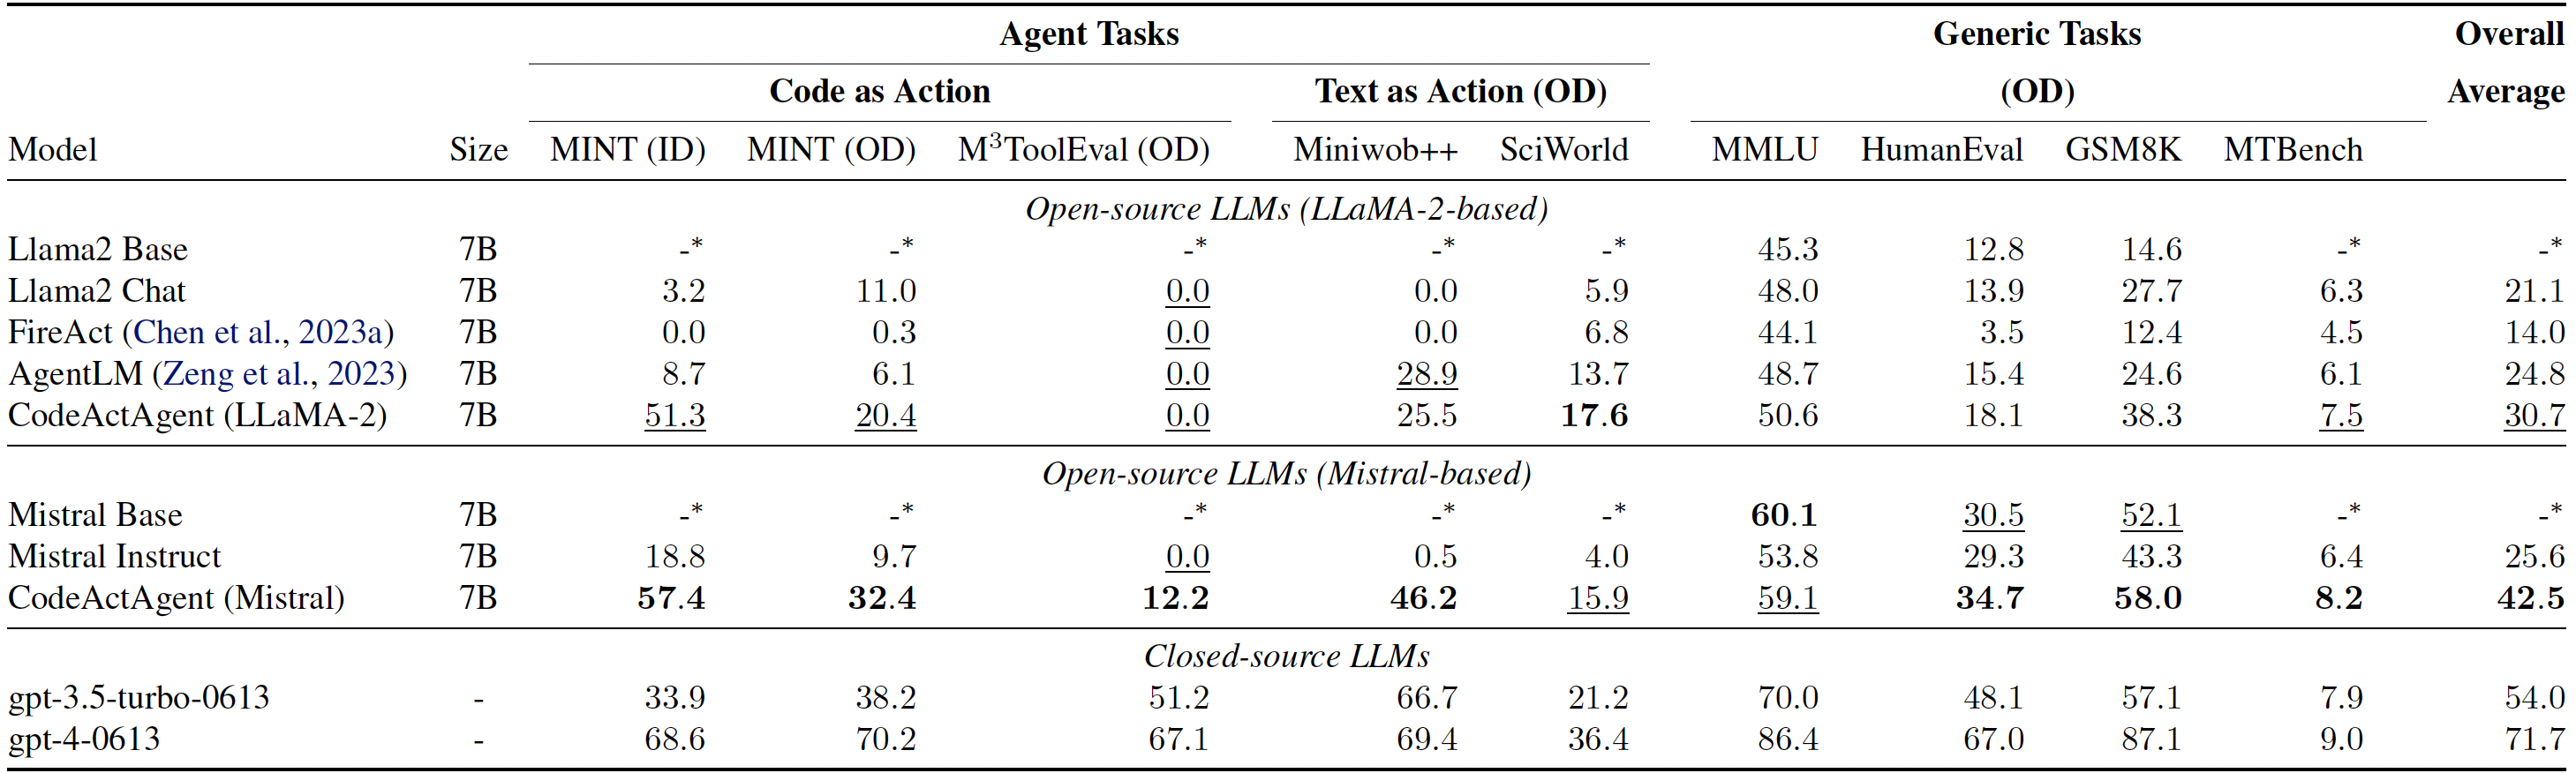
Model Performance Evaluation results for CodeActAgent. ID and OD stand for in-domain and out-of-domain evaluation correspondingly. Overall averaged performance normalizes the MT-Bench score to be consistent with other tasks and excludes in-domain tasks for fair comparison.

Please check out our paper and code for more details about data collection, model training, and evaluation.

📚 Citation

@misc{wang2024executable,
      title={Executable Code Actions Elicit Better LLM Agents}, 
      author={Xingyao Wang and Yangyi Chen and Lifan Yuan and Yizhe Zhang and Yunzhu Li and Hao Peng and Heng Ji},
      year={2024},
      eprint={2402.01030},
      archivePrefix={arXiv},
      primaryClass={cs.CL}
}

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
LlamaForCausalLM
Ревизия весов
525e7af

0 моделей