🚀 Demo Site
Try out Llama-3-Taiwan interactively at twllm.com
⚔️ Chatbot Arena
Participate in the exciting Chatbot Arena and compete against other chatbots!
🚀 We're excited to introduce Llama-3-Taiwan-70B! Llama-3-Taiwan-70B is a 70B parameter model finetuned on a large corpus of Traditional Mandarin and English data using the Llama-3 architecture. It demonstrates state-of-the-art performance on various Traditional Mandarin NLP benchmarks.
The model was trained with NVIDIA NeMo™ Framework using the NVIDIA Taipei-1 built with NVIDIA DGX H100 systems.
The compute and data for training Llama-3-Taiwan-70B was generously sponsored by Chang Gung Memorial Hospital, Chang Chun Group, Legalsign.ai, NVIDIA, Pegatron, TechOrange, and Unimicron (in alphabetical order).
We would like to acknowledge the contributions of our data provider, team members and advisors in the development of this model, including shasha77 for high-quality YouTube scripts and study materials, Taiwan AI Labs for providing local media content, Ubitus K.K. for offering gaming content, Professor Yun-Nung (Vivian) Chen for her guidance and advisement, Wei-Lin Chen for leading our pretraining data pipeline, Tzu-Han Lin for synthetic data generation, Chang-Sheng Kao for enhancing our synthetic data quality, and Kang-Chieh Chen for cleaning instruction-following data.
Model Summary
Llama-3-Taiwan-70B is a large language model finetuned for Traditional Mandarin and English users. It has strong capabilities in language understanding, generation, reasoning, and multi-turn dialogue. Key features include:
- 70B parameters
- Languages: Traditional Mandarin (zh-tw), English (en)
- Finetuned on High-quality Traditional Mandarin and English corpus covering general knowledge as well as industrial knowledge in legal, manufacturing, medical, and electronics domains
- 8K context length
- Open model released under the Llama-3 license
Training Details
- Training Framework: NVIDIA NeMo, NVIDIA NeMo Megatron
- Inference Framework: NVIDIA TensorRT-LLM
- Base model: Llama-3 70B
- Hardware: NVIDIA DGX H100 on Taipei-1
- Context length: 8K tokens (128k version)
- Batch size: 2M tokens per step
Evaluation
Checkout Open TW LLM Leaderboard for full and updated list.
Numbers are 0-shot by default.
^ taken the closet matching numbers from original dataset.
Needle in a Haystack Evaluation
The "Needle in a 出師表" evaluation tests the model's ability to locate and recall important information embedded within a large body of text, using the classic Chinese text 《出師表》 by 諸葛亮.
To run the evaluation, use the script.
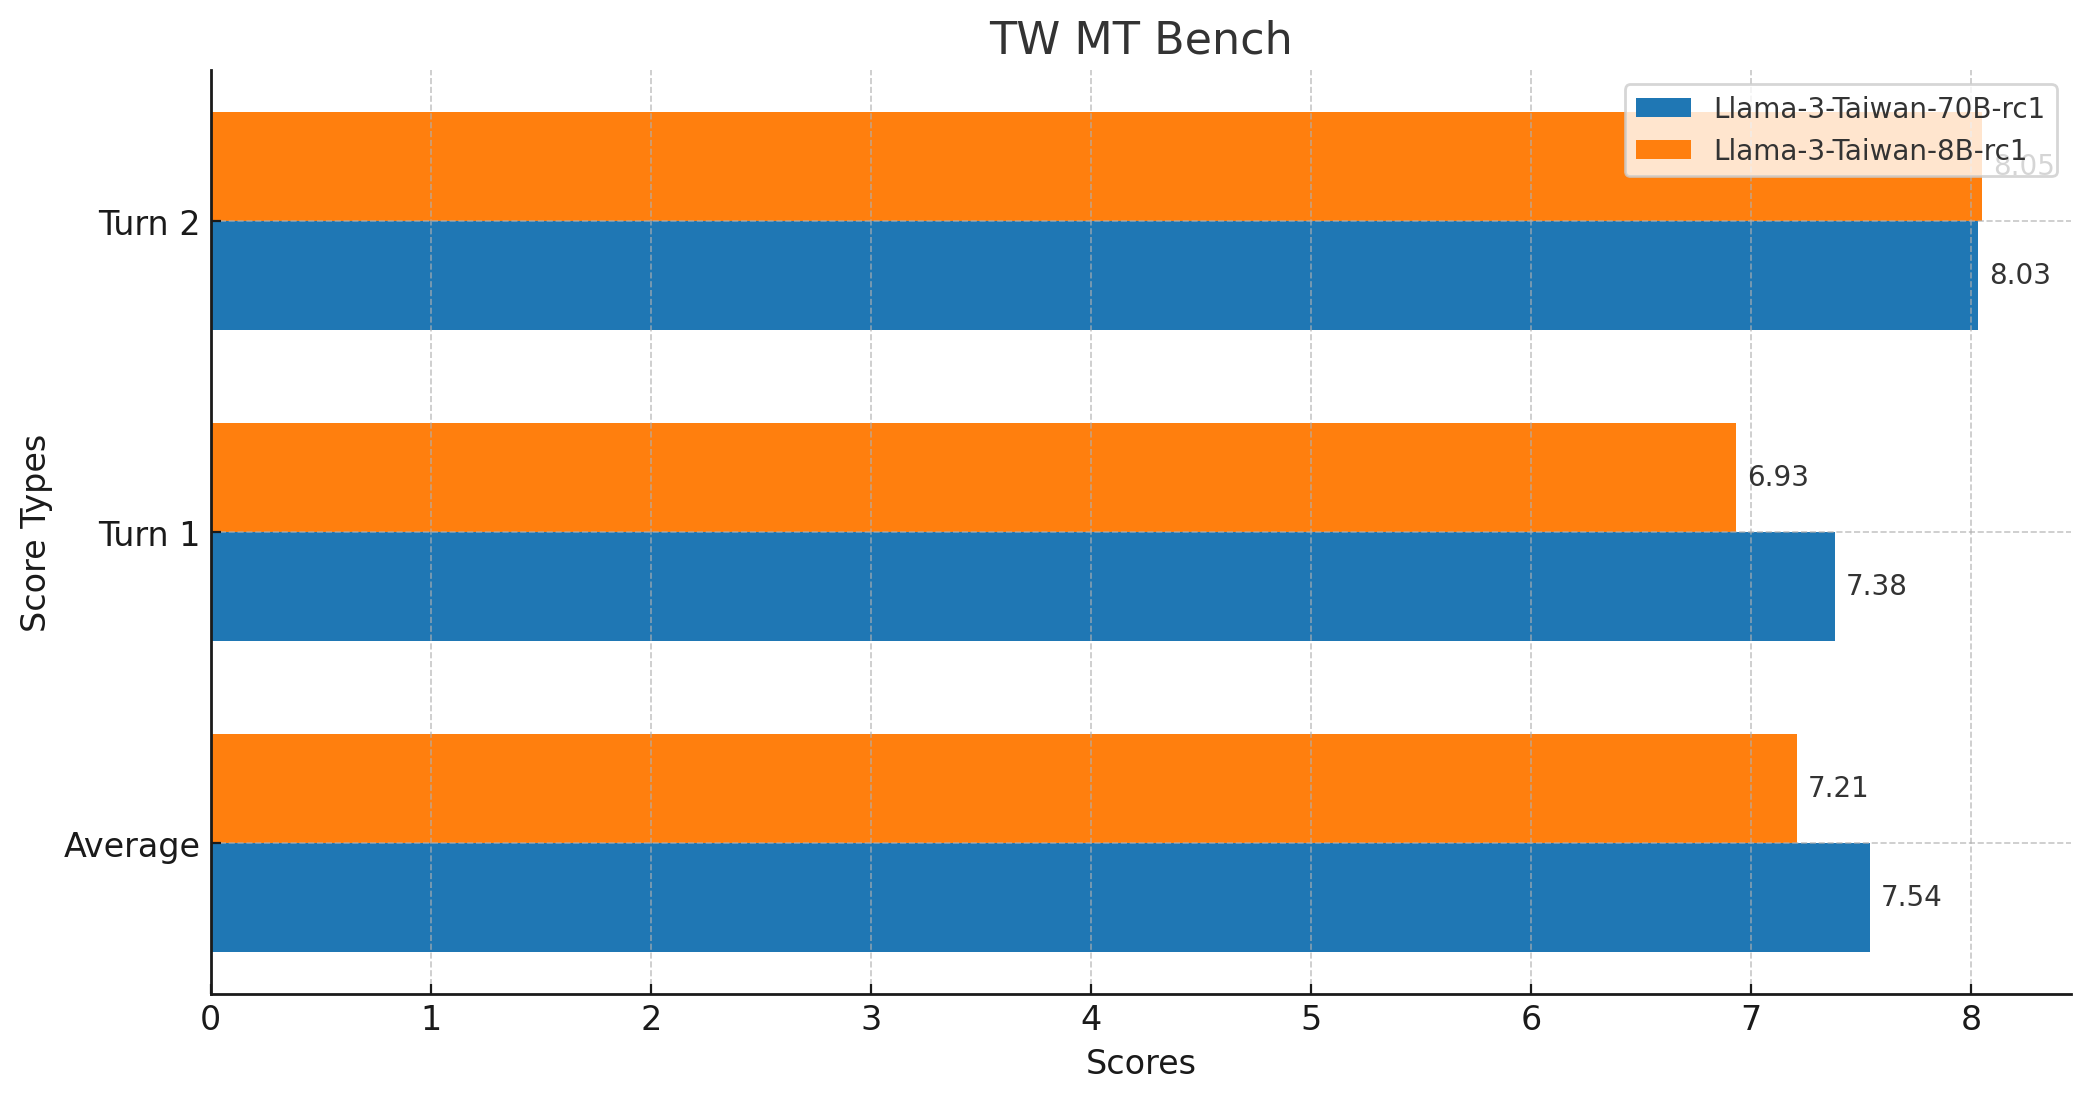
TW MT-Bench Score
- Average Score: 7.5375
- Maximum Score: 10
- Minimum Score: 1
- Median Score: 9.0
- Standard Deviation: 3.0349783771882133
- Total Number of Scores: 160
- Model resopnse
- GPT-4 Eval
- Code fork from
mtkresearch/TCEvalwith bug fixing
Use Cases
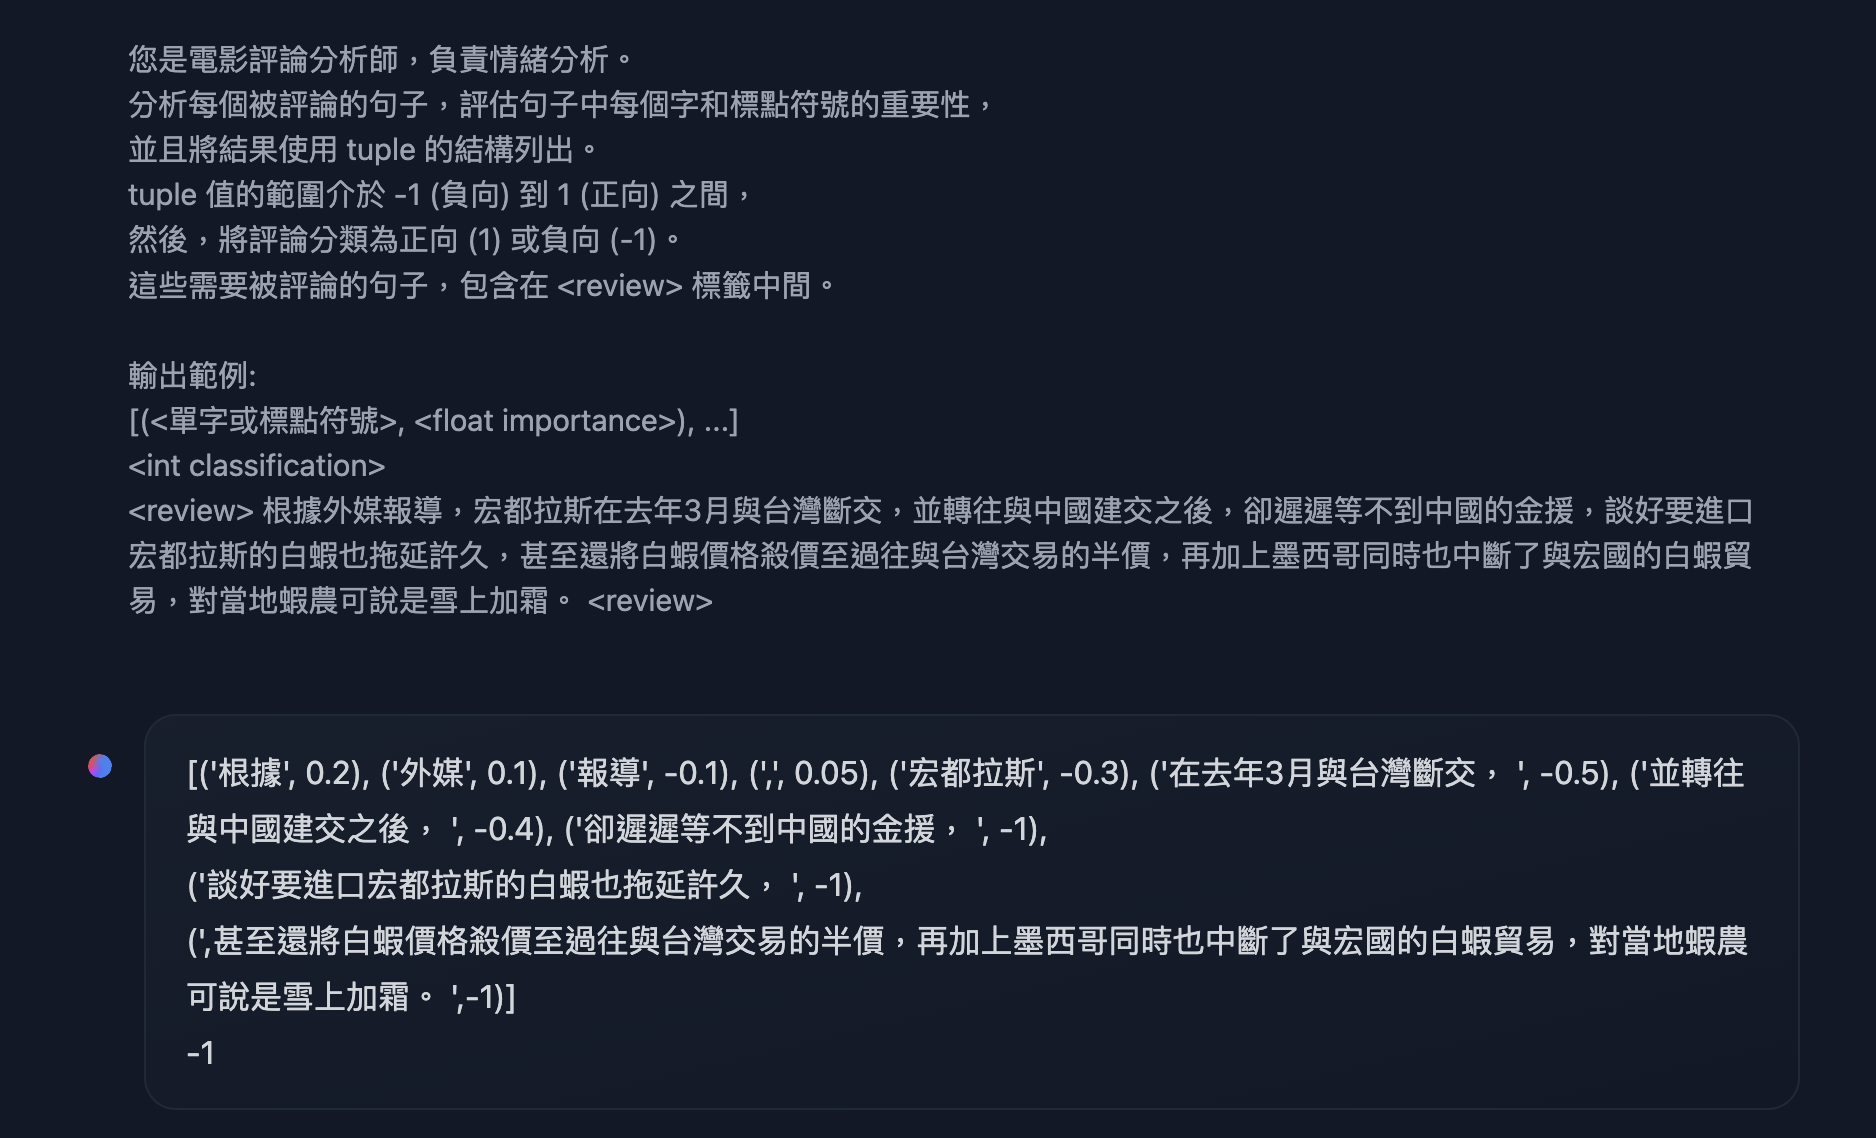
Llama-3-Taiwan-70B can be applied to a wide variety of NLP tasks in Traditional Chinese and English, including:
Demo: 可以打開 Search Web on twllm.com


If you are interested in function-calling, I strongly recommend using constrained decoding to turn on json mode.
Example from HW7 in INTRODUCTION TO GENERATIVE AI 2024 SPRING from HUNG-YI LEE (李宏毅)
Get Started
Caveat: System message should always be set.
Hugging Face Transformers library
You can use Llama-3-Taiwan-70B with the Hugging Face Transformers library:
import torch
from transformers import pipeline, StoppingCriteria

# Define a custom stopping criteria class
class EosListStoppingCriteria(StoppingCriteria):
    def __init__(self, eos_sequence=[128256]):
        self.eos_sequence = eos_sequence

    def __call__(self, input_ids: torch.LongTensor, scores: torch.FloatTensor, **kwargs) -> bool:
        last_ids = input_ids[:, -len(self.eos_sequence):].tolist()
        return self.eos_sequence in last_ids

# Initialize the model with automatic device mapping
llm = pipeline("text-generation", model="yentinglin/Llama-3-Taiwan-70B-Instruct-rc1", device_map="auto")
tokenizer = llm.tokenizer

# Define a conversation example
chat = [
    {"role": "system", "content": "You are an AI assistant called Twllm, created by TAME (TAiwan Mixture of Expert) project."},
    {"role": "user", "content": "你好,請問你可以完成什麼任務?"},
    {"role": "assistant", "content": "你好,我可以幫助您解決各種問題、提供資訊並協助完成多種任務。例如:回答技術問題、提供建議、翻譯文字、尋找資料或協助您安排行程等。請告訴我如何能幫助您。"},
    {"role": "user", "content": "太棒了!"}
]
flatten_chat_for_generation = tokenizer.apply_chat_template(chat, tokenize=False, add_generation_prompt=True)
"""
<|im_start|>user
You are an AI assistant called Twllm, created by TAME (TAiwan Mixture of Expert) project.<|im_end|>
<|im_start|>user
你好,請問你可以完成什麼任務?<|im_end|>
<|im_start|>assistant
你好,我可以幫助您解決各種問題、提供資訊和協助您完成許多不同的任務。例如:回答技術問題、提供建議、翻譯文字、尋找資料或協助您安排行程等。請告訴我如何能幫助您。<|im_end|>
<|im_start|>user
太棒了!<|im_end|>
<|im_start|>assistant

"""

# Generate a response using the custom stopping criteria
output = llm(flatten_chat_for_generation, return_full_text=False, max_new_tokens=128, top_p=0.9, temperature=0.7, stopping_criteria=[EosListStoppingCriteria([tokenizer.eos_token_id])])
print(output[0]['generated_text'])
"謝謝!很高興能夠為您服務。如果有任何其他需要協助的地方,請隨時與我聯繫。我會盡最大努力為您提供所需的支援。"
vLLM
Start the server
export NUM_GPUS=4
export PORT=8000

docker run \
  -e HF_TOKEN=$HF_TOKEN \
  --gpus '"device=0,1,2,3"' \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -p "${PORT}:8000" \
  --ipc=host \
  vllm/vllm-openai:v0.4.0.post1 \
  --model "yentinglin/Llama-3-Taiwan-70B-Instruct-rc1" \
  -tp "${NUM_GPUS}"
Sample client code, or you can use anything OpenAI-API compatible clients
# pip install "openai>=1.0.0"
from openai import OpenAI
# Set OpenAI's API key and API base to use vLLM's API server.
openai_api_key = "EMPTY"
openai_api_base = "http://localhost:8000/v1"

client = OpenAI(
    api_key=openai_api_key,
    base_url=openai_api_base,
)

chat_response = client.chat.completions.create(
    model="yentinglin/Llama-3-Taiwan-70B-Instruct-rc1",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Tell me a joke."},
    ]
)
print("Chat response:", chat_response)
Enjoy exploring the capabilities of Llama-3-Taiwan-70B! We look forward to seeing what you create with this powerful open-source model. If you have any questions or feedback, please let us know.
Contributions
- Professor Yun-Nung (Vivian) Chen, for her guidance and advisement throughout the project.
- Wei-Lin Chen, for leading our pretraining data pipeline.
- Tzu-Han Lin, for synthetic data generation.
- Chang-Sheng Kao, for enhancing our synthetic data quality.
- Kang-Chieh Chen, for cleaning instruction-following data.
- Min-Yi Chen and Shao-Heng Hsu, for collecting chemical engineering data and benchmarks.
- Chung-Yao Ma, Jonathan Guo and Kai-Chun Chang, for collecting manufacturing and electrical engineering data and benchmarks, and project progress management
Citation
@article{DBLP:journals/corr/abs-2311-17487,
  author       = {Yen{-}Ting Lin and
                  Yun{-}Nung Chen},
  title        = {Taiwan {LLM:} Bridging the Linguistic Divide with a Culturally Aligned
                  Language Model},
  journal      = {CoRR},
  volume       = {abs/2311.17487},
  year         = {2023},
  url          = {https://doi.org/10.48550/arXiv.2311.17487},
  doi          = {10.48550/ARXIV.2311.17487},
  eprinttype    = {arXiv},
  eprint       = {2311.17487},
  timestamp    = {Tue, 05 Dec 2023 14:40:42 +0100},
  biburl       = {https://dblp.org/rec/journals/corr/abs-2311-17487.bib},
  bibsource    = {dblp computer science bibliography, https://dblp.org}
}
@article{DBLP:journals/corr/abs-2403-20180,
  author       = {Po{-}Heng Chen and
                  Sijia Cheng and
                  Wei{-}Lin Chen and
                  Yen{-}Ting Lin and
                  Yun{-}Nung Chen},
  title        = {Measuring Taiwanese Mandarin Language Understanding},
  journal      = {CoRR},
  volume       = {abs/2403.20180},
  year         = {2024},
  url          = {https://doi.org/10.48550/arXiv.2403.20180},
  doi          = {10.48550/ARXIV.2403.20180},
  eprinttype    = {arXiv},
  eprint       = {2403.20180},
  timestamp    = {Wed, 10 Apr 2024 17:37:45 +0200},
  biburl       = {https://dblp.org/rec/journals/corr/abs-2403-20180.bib},
  bibsource    = {dblp computer science bibliography, https://dblp.org}
}
Disclaimer
This model is provided “as‑is” and without warranties of any kind. Users are solely responsible for evaluating the accuracy and suitability of the outputs. The developers assume no liability for any direct or indirect damages arising from its use.
The model is strictly not intended for high‑risk applications such as medical diagnosis, legal advice, or financial investment. For such use cases, please consult qualified professionals.
本模型「如是」(as‑is)提供,使用者須自行評估結果之正確性與適用性。開發者對於使用本模型所引發之任何直接或間接損失,不承擔任何法律責任。
嚴禁用於醫療診斷、法律諮詢、金融投資等高風險場景;若有相關需求,請尋求專業人員協助。