TB-OCR: an end-to-end OCR model handling text, math latex, and markdown formats all at once
Model Summary
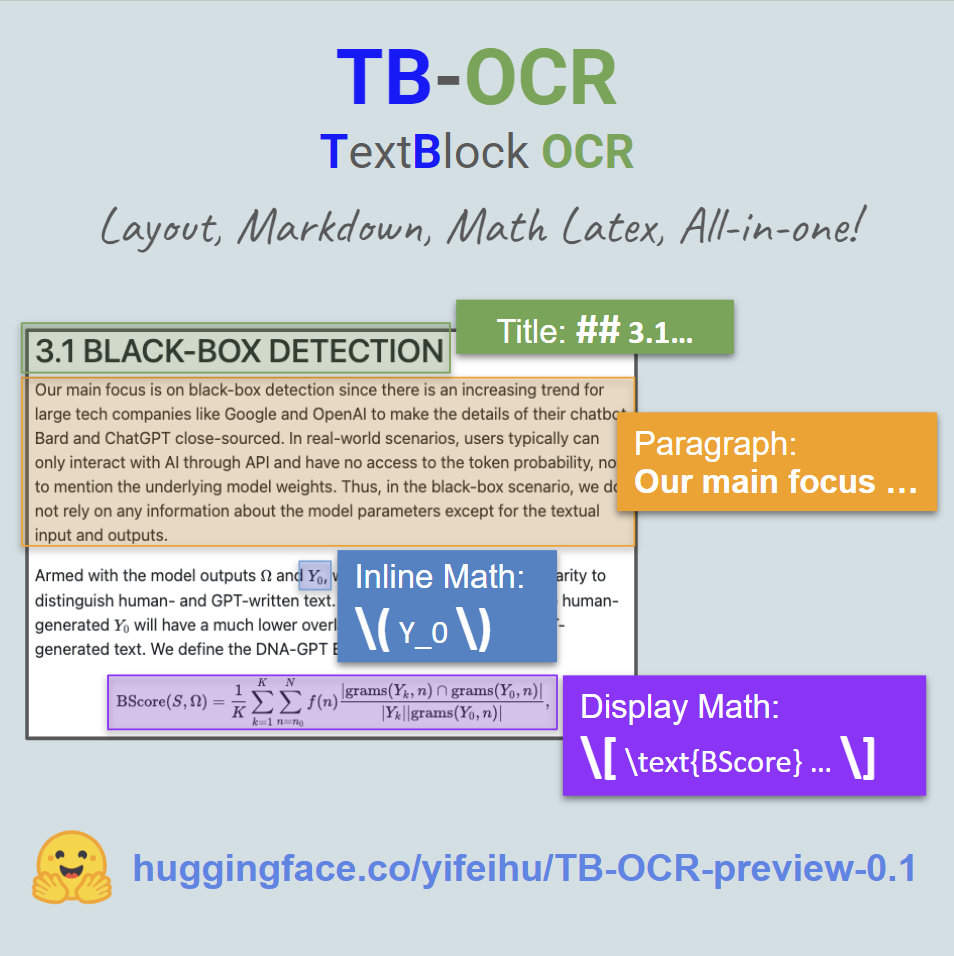
TB-OCR-preview (Text Block OCR), created by Yifei Hu, is an end-to-end OCR model handling text, math latex, and markdown formats all at once. The model takes a block of text as the input and returns clean markdown output. Headers are marked with ##. Math expressions are guaranteed to be wrapped in brackets \( inline math \) \[ display math \] for easier parsing. This model does not require line-detection or math formula detection.
Running the model in 4-bit only requires ~2.8GB VRAM to load and exhibits little to none degradation.
Use Case (Important!)
This model is NOT designed to perform OCR on full pages. Please consider combining TFT-ID-1.0[HF], a text/tale/figure detection model, for full page OCR. It's also faster to split the larger text blocks into smaller ones and perform OCR in parallel (batch inference).
Sample Usage
# check out https://huggingface.co/microsoft/Phi-3.5-vision-instruct for more details

import torch
from transformers import AutoModelForCausalLM, AutoProcessor, BitsAndBytesConfig
from PIL import Image
import requests

model_id = "yifeihu/TB-OCR-preview-0.1"

DEVICE = torch.device("cuda" if torch.cuda.is_available() else "cpu")

model = AutoModelForCausalLM.from_pretrained(
  model_id,
  device_map="cuda",
  trust_remote_code=True,
  torch_dtype="auto",
  _attn_implementation='flash_attention_2',
  quantization_config=BitsAndBytesConfig(load_in_4bit=True) # Optional: Load model in 4-bit mode to save memory
)

processor = AutoProcessor.from_pretrained(model_id,
  trust_remote_code=True,
  num_crops=16
)

def phi_ocr(image_url):
    question = "Convert the text to markdown format." # this is required
    image = Image.open(requests.get(image_url, stream=True).raw)
    prompt_message = [{
        'role': 'user',
        'content': f'<|image_1|>\n{question}',
    }]

    prompt = processor.tokenizer.apply_chat_template(prompt_message, tokenize=False, add_generation_prompt=True)
    inputs = processor(prompt, [image], return_tensors="pt").to("cuda")

    generation_args = {
        "max_new_tokens": 1024,
        "temperature": 0.1,
        "do_sample": False
    }

    generate_ids = model.generate(**inputs, eos_token_id=processor.tokenizer.eos_token_id, **generation_args
    )

    generate_ids = generate_ids[:, inputs['input_ids'].shape[1]:]
    response = processor.batch_decode(generate_ids, skip_special_tokens=True, clean_up_tokenization_spaces=False)[0]

    response = response.split("<image_end>")[0] # remove the image_end token

    return response

test_image_url = "https://huggingface.co/yifeihu/TB-OCR-preview-0.1/resolve/main/sample_input_1.png?download=true"

response = phi_ocr(test_image_url)

print(response)
About this preview checkpoint
This is a preview model to verify the quality of a dataset from a synthetic data pipeline. The preview checkpoint only used ~250k image-text pairs (~50M tokens).
The current model is based on Phi-3.5-vision. Smaller models with even stronger performance are currently being trained or tested.