TFT-ID: Table/Figure/Text IDentifier for academic papers
Model Summary
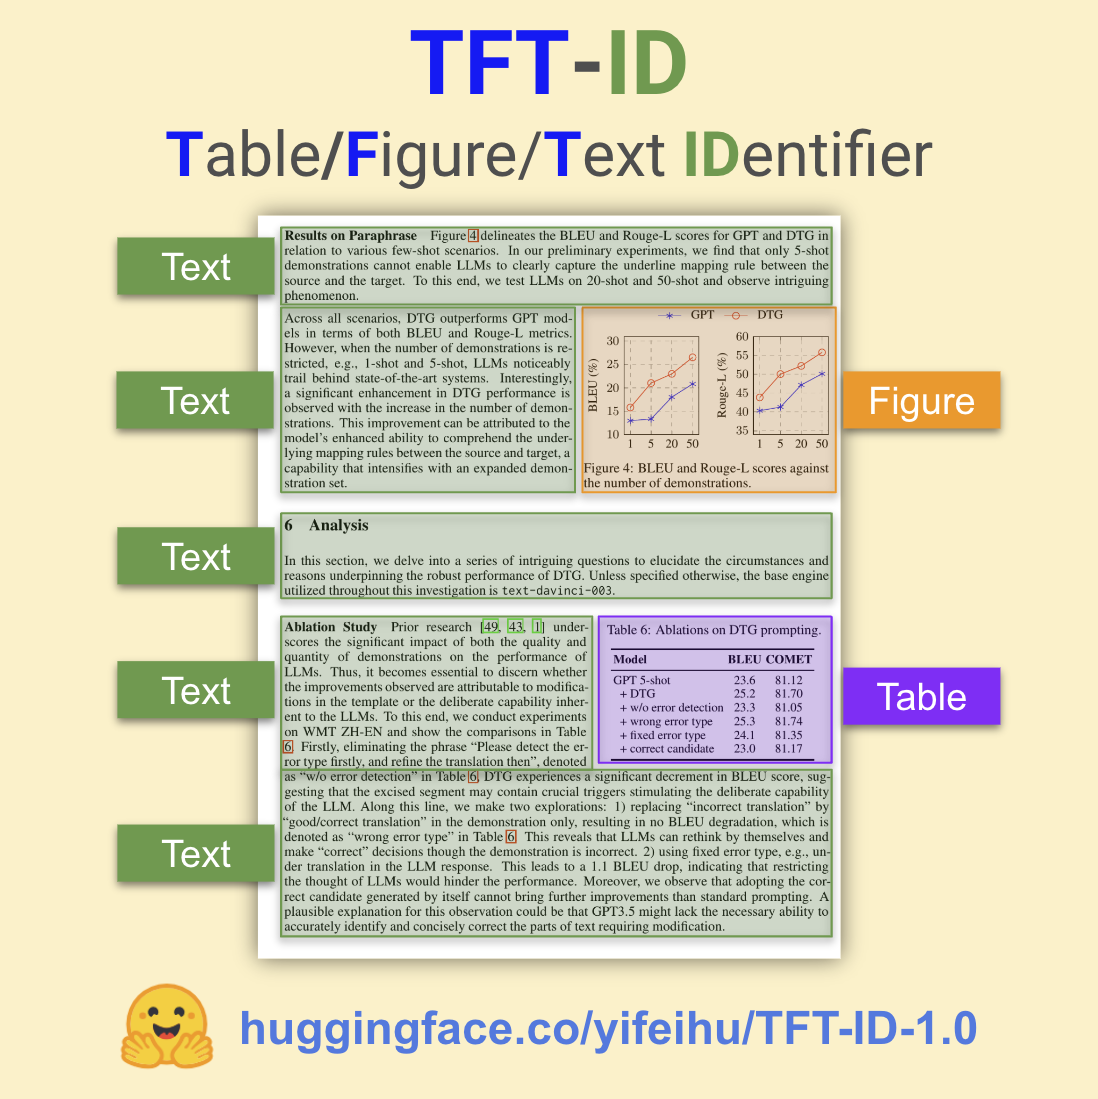
TFT-ID (Table/Figure/Text IDentifier) is an object detection model finetuned to extract tables, figures, and text sections in academic papers created by Yifei Hu.
TFT-ID is finetuned from microsoft/Florence-2 checkpoints.
- The model was finetuned with papers from Hugging Face Daily Papers. All 36,000+ bounding boxes are manually annotated and checked by Yifei Hu.
- TFT-ID model takes an image of a single paper page as the input, and return bounding boxes for all tables, figures, and text sections in the given page.
- The text sections contain clean text content perfect for downstream OCR workflows. I recommend using TB-OCR-preview-0.1 [HF] as the OCR model to convert the text sections into clean markdown and math latex output.
Object Detection results format: {'<OD>': {'bboxes': [[x1, y1, x2, y2], ...], 'labels': ['label1', 'label2', ...]} }
Training Code and Dataset
- Dataset: Coming soon.
- Code: github.com/ai8hyf/TF-ID
Benchmarks
The model was tested on paper pages outside the training dataset. The papers are a subset of huggingface daily paper.
Correct output - the model draws correct bounding boxes for every table/figure/text section in the given page and does not missing any content.
Task 1: Table, Figure, and Text Section Identification
| Model | Total Images | Correct Output | Success Rate |
|---|---|---|---|
| TFT-ID-1.0[HF] | 373 | 361 | 96.78% |
Task 2: Table and Figure Identification
| Model | Total Images | Correct Output | Success Rate |
|---|---|---|---|
| TFT-ID-1.0[HF] | 258 | 255 | 98.84% |
| TF-ID-large[HF] | 258 | 253 | 98.06% |
Note: Depending on the use cases, some "incorrect" output could be totally usable. For example, the model draw two bounding boxes for one figure with two child components.
How to Get Started with the Model
Use the code below to get started with the model.
For non-CUDA environments, please check out this post for a simple patch: https://huggingface.co/microsoft/Florence-2-base/discussions/4
import requests
from PIL import Image
from transformers import AutoProcessor, AutoModelForCausalLM

model = AutoModelForCausalLM.from_pretrained("yifeihu/TFT-ID-1.0", trust_remote_code=True)
processor = AutoProcessor.from_pretrained("yifeihu/TFT-ID-1.0", trust_remote_code=True)

prompt = "<OD>"

url = "https://huggingface.co/yifeihu/TF-ID-base/resolve/main/arxiv_2305_10853_5.png?download=true"
image = Image.open(requests.get(url, stream=True).raw)

inputs = processor(text=prompt, images=image, return_tensors="pt")

generated_ids = model.generate(
    input_ids=inputs["input_ids"],
    pixel_values=inputs["pixel_values"],
    max_new_tokens=1024,
    do_sample=False,
    num_beams=3
)
generated_text = processor.batch_decode(generated_ids, skip_special_tokens=False)[0]

parsed_answer = processor.post_process_generation(generated_text, task="<OD>", image_size=(image.width, image.height))

print(parsed_answer)
To visualize the results, see this tutorial notebook for more details.
BibTex and citation info
@misc{TF-ID,
  author = {Yifei Hu},
  title = {TF-ID: Table/Figure IDentifier for academic papers},
  year = {2024},
  publisher = {GitHub},
  journal = {GitHub repository},
  howpublished = {\url{https://github.com/ai8hyf/TF-ID}},
}