/ Модель

Характеристики

Контекст
512 токенов
Лицензия
MIT
Архитектура
vision-encoder-decoder · dense
Опубликована
2 мар 2023

vit-gpt2-image-chinese-captioning

Изображение и текст → текст4 профессии

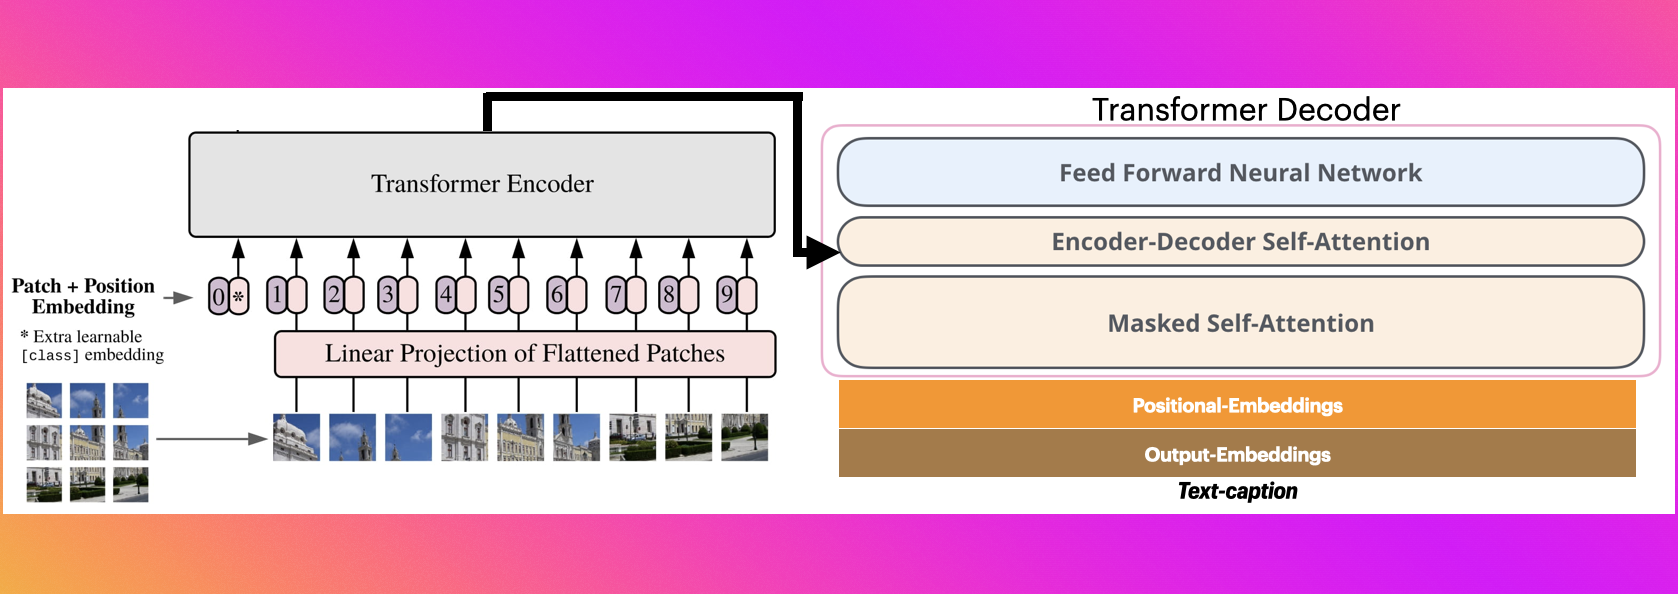
Модель ViT-GPT2 генерирует китайские текстовые подписи к изображениям.

98скачиваний за 30 дней6лайковвеса обновлены1 дек 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Изображение → текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Это модель для создания подписей к изображениям на китайском языке, разработанная yuanzhoulvpi. Она объединяет визуальный энкодер ViT с декодером GPT-2: ViT кодирует изображение, а GPT-2 формирует текстовое описание. В качестве компонентов указаны google/vit-base-patch16-224 и yuanzhoulvpi/gpt2_chinese.

Модель принимает изображение и генерирует китайскую текстовую подпись. Она предназначена для автоматического описания изображений и может использоваться, например, для подготовки подписей к фотоколлекциям. Репозиторий содержит веса в форматах PyTorch и Safetensors; лицензия — MIT. Карточка не приводит оценок качества или ограничений применения.

Сценарии применения

  • создание китайских подписей к фотографиям
  • автоматическое описание изображений для фотоколлекций
  • генерация текстовых описаний изображений на китайском языке

Ограничения

Карточка не приводит результатов оценки качества и не описывает специальные ограничения модели.

Для каких профессий подходит4

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

模型介绍

  1. vit对图像做encoder,然后再用gpt2做decoder
  2. vit模型使用的是google/vit-base-patch16-224, gpt2使用的是yuanzhoulvpi/gpt2_chinese
  3. 本模型支持中文

训练代码

https://github.com/yuanzhoulvpi2017/zero_nlp/tree/main/vit-gpt2-image-chinese-captioning

推理代码

infer

from transformers import (VisionEncoderDecoderModel, 
                          AutoTokenizer,ViTImageProcessor)
import torch
from PIL import Image

vision_encoder_decoder_model_name_or_path = "yuanzhoulvpi/vit-gpt2-image-chinese-captioning"#"vit-gpt2-image-chinese-captioning/checkpoint-3200"

processor = ViTImageProcessor.from_pretrained(vision_encoder_decoder_model_name_or_path)
tokenizer = AutoTokenizer.from_pretrained(vision_encoder_decoder_model_name_or_path)
model = VisionEncoderDecoderModel.from_pretrained(vision_encoder_decoder_model_name_or_path)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model.to(device)
max_length = 16
num_beams = 4
gen_kwargs = {"max_length": max_length, "num_beams": num_beams}


def predict_step(image_paths):
    images = []
    for image_path in image_paths:
        i_image = Image.open(image_path)
        if i_image.mode != "RGB":
            i_image = i_image.convert(mode="RGB")

        images.append(i_image)

    pixel_values = processor(images=images, return_tensors="pt").pixel_values
    pixel_values = pixel_values.to(device)

    output_ids = model.generate(pixel_values, **gen_kwargs)

    preds = tokenizer.batch_decode(output_ids, skip_special_tokens=True)
    preds = [pred.strip() for pred in preds]
    return preds


predict_step(['bigdata/image_data/train-1000200.jpg'])

效果

example 1

example 2

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
VisionEncoderDecoderModel
Ревизия весов
57bcc98

0 моделей