CogView4-6B
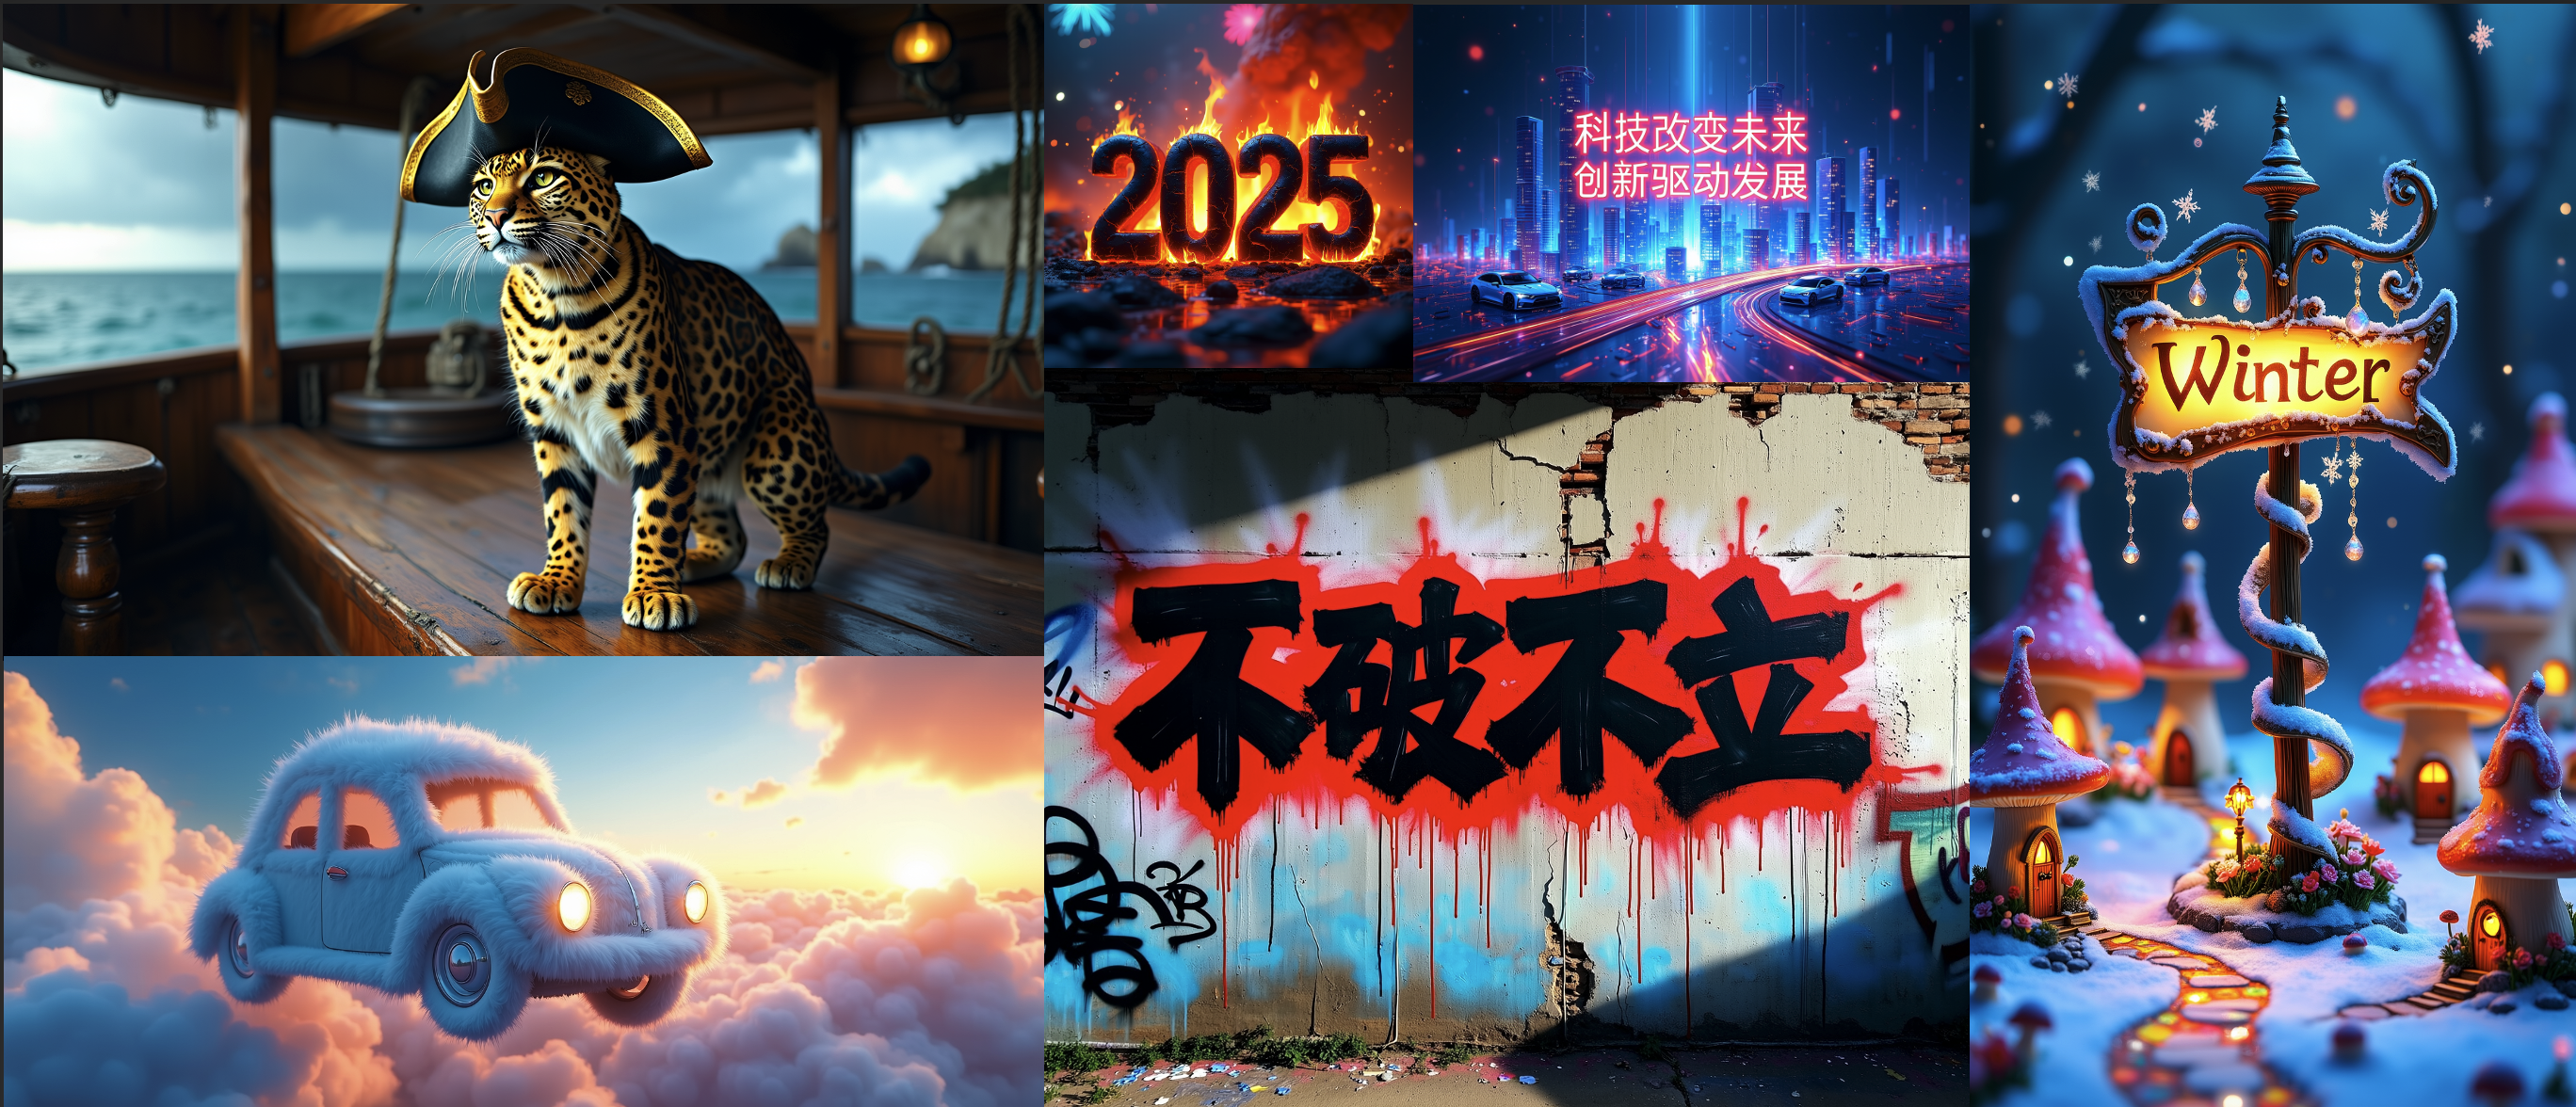
Inference Requirements and Model Introduction
- Resolution: Width and height must be between
512pxand2048px, divisible by32, and ensure the maximum number of pixels does not exceed2^21px. - Precision: BF16 / FP32 (FP16 is not supported as it will cause overflow resulting in completely black images)
Using BF16 precision with batchsize=4 for testing, the memory usage is shown in the table below:
| Resolution | enable_model_cpu_offload OFF | enable_model_cpu_offload ON | enable_model_cpu_offload ON Text Encoder 4bit |
|---|---|---|---|
| 512 * 512 | 33GB | 20GB | 13G |
| 1280 * 720 | 35GB | 20GB | 13G |
| 1024 * 1024 | 35GB | 20GB | 13G |
| 1920 * 1280 | 39GB | 20GB | 14G |
Quick Start
First, ensure you install the diffusers library from source.
pip install git+https://github.com/huggingface/diffusers.git
cd diffusers
pip install -e .
Then, run the following code:
from diffusers import CogView4Pipeline

pipe = CogView4Pipeline.from_pretrained("THUDM/CogView4-6B", torch_dtype=torch.bfloat16)

# Open it for reduce GPU memory usage
pipe.enable_model_cpu_offload()
pipe.vae.enable_slicing()
pipe.vae.enable_tiling()

prompt = "A vibrant cherry red sports car sits proudly under the gleaming sun, its polished exterior smooth and flawless, casting a mirror-like reflection. The car features a low, aerodynamic body, angular headlights that gaze forward like predatory eyes, and a set of black, high-gloss racing rims that contrast starkly with the red. A subtle hint of chrome embellishes the grille and exhaust, while the tinted windows suggest a luxurious and private interior. The scene conveys a sense of speed and elegance, the car appearing as if it's about to burst into a sprint along a coastal road, with the ocean's azure waves crashing in the background."
image = pipe(
    prompt=prompt,
    guidance_scale=3.5,
    num_images_per_prompt=1,
    num_inference_steps=50,
    width=1024,
    height=1024,
).images[0]

image.save("cogview4.png")
Model Metrics
We've tested on multiple benchmarks and achieved the following scores:
DPG-Bench
| Model | Overall | Global | Entity | Attribute | Relation | Other |
|---|---|---|---|---|---|---|
| SDXL | 74.65 | 83.27 | 82.43 | 80.91 | 86.76 | 80.41 |
| PixArt-alpha | 71.11 | 74.97 | 79.32 | 78.60 | 82.57 | 76.96 |
| SD3-Medium | 84.08 | 87.90 | 91.01 | 88.83 | 80.70 | 88.68 |
| DALL-E 3 | 83.50 | 90.97 | 89.61 | 88.39 | 90.58 | 89.83 |
| Flux.1-dev | 83.79 | 85.80 | 86.79 | 89.98 | 90.04 | 89.90 |
| Janus-Pro-7B | 84.19 | 86.90 | 88.90 | 89.40 | 89.32 | 89.48 |
| CogView4-6B | 85.13 | 83.85 | 90.35 | 91.17 | 91.14 | 87.29 |
GenEval
| Model | Overall | Single Obj. | Two Obj. | Counting | Colors | Position | Color attribution |
|---|---|---|---|---|---|---|---|
| SDXL | 0.55 | 0.98 | 0.74 | 0.39 | 0.85 | 0.15 | 0.23 |
| PixArt-alpha | 0.48 | 0.98 | 0.50 | 0.44 | 0.80 | 0.08 | 0.07 |
| SD3-Medium | 0.74 | 0.99 | 0.94 | 0.72 | 0.89 | 0.33 | 0.60 |
| DALL-E 3 | 0.67 | 0.96 | 0.87 | 0.47 | 0.83 | 0.43 | 0.45 |
| Flux.1-dev | 0.66 | 0.98 | 0.79 | 0.73 | 0.77 | 0.22 | 0.45 |
| Janus-Pro-7B | 0.80 | 0.99 | 0.89 | 0.59 | 0.90 | 0.79 | 0.66 |
| CogView4-6B | 0.73 | 0.99 | 0.86 | 0.66 | 0.79 | 0.48 | 0.58 |
T2I-CompBench
| Model | Color | Shape | Texture | 2D-Spatial | 3D-Spatial | Numeracy | Non-spatial Clip | Complex 3-in-1 |
|---|---|---|---|---|---|---|---|---|
| SDXL | 0.5879 | 0.4687 | 0.5299 | 0.2133 | 0.3566 | 0.4988 | 0.3119 | 0.3237 |
| PixArt-alpha | 0.6690 | 0.4927 | 0.6477 | 0.2064 | 0.3901 | 0.5058 | 0.3197 | 0.3433 |
| SD3-Medium | 0.8132 | 0.5885 | 0.7334 | 0.3200 | 0.4084 | 0.6174 | 0.3140 | 0.3771 |
| DALL-E 3 | 0.7785 | 0.6205 | 0.7036 | 0.2865 | 0.3744 | 0.5880 | 0.3003 | 0.3773 |
| Flux.1-dev | 0.7572 | 0.5066 | 0.6300 | 0.2700 | 0.3992 | 0.6165 | 0.3065 | 0.3628 |
| Janus-Pro-7B | 0.5145 | 0.3323 | 0.4069 | 0.1566 | 0.2753 | 0.4406 | 0.3137 | 0.3806 |
| CogView4-6B | 0.7786 | 0.5880 | 0.6983 | 0.3075 | 0.3708 | 0.6626 | 0.3056 | 0.3869 |
Chinese Text Accuracy Evaluation
| Model | Precision | Recall | F1 Score | Pick@4 |
|---|---|---|---|---|
| Kolors | 0.6094 | 0.1886 | 0.2880 | 0.1633 |
| CogView4-6B | 0.6969 | 0.5532 | 0.6168 | 0.3265 |
Citation
🌟 If you find our work helpful, please consider citing our paper and leaving valuable stars
@article{zheng2024cogview3,
  title={Cogview3: Finer and faster text-to-image generation via relay diffusion},
  author={Zheng, Wendi and Teng, Jiayan and Yang, Zhuoyi and Wang, Weihan and Chen, Jidong and Gu, Xiaotao and Dong, Yuxiao and Ding, Ming and Tang, Jie},
  journal={arXiv preprint arXiv:2403.05121},
  year={2024}
}
License
This model is released under the Apache 2.0 License.