/ Модель

Характеристики

Контекст
65 536 токенов
Размер весов
20,6 ГБ
Лицензия
MIT
Архитектура
glm4v · dense
Базовая модель
GLM-4-9B-0414
Библиотека
transformers
Опубликована
28 июн 2025

GLM-4.1V-9B-Base

Изображение и текст → текст3 профессии

Базовая мультимодальная модель Z.ai для исследований и дальнейшей разработки систем, работающих с изображениями и текстом.

712скачиваний за 30 дней68лайковвеса обновлены25 окт 2025

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Изображение → текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

GLM-4.1V-9B-Base — базовая мультимодальная модель Z.ai для исследований возможностей визуально-языковых моделей. Она основана на GLM-4-9B-0414 и предназначена для дальнейшей разработки и изучения задач, где нужно связывать изображения и текст. В метаданных указаны архитектура GLM4V, плотная модель и поддержка диалогов и зрения; веса опубликованы в формате Safetensors.

README описывает также GLM-4.1V-9B-Thinking — отдельную модель семейства с рассуждениями, контекстом 64 тыс. токенов и обработкой изображений произвольного соотношения сторон до 4K. Эти характеристики и приведённые результаты относятся к Thinking, а не подтверждены для Base. Модель Base выпущена под лицензией MIT; отдельные ограничения её качества и контекста в доступных данных не описаны.

Сценарии применения

  • исследование визуально-языковых моделей
  • разработка приложений для вопросов и ответов по изображениям
  • создание мультимодальных диалоговых систем

Ограничения

README в основном описывает возможности GLM-4.1V-9B-Thinking; заявленные для Thinking контекст 64 тыс. токенов, разрешение изображений до 4K и результаты тестов нельзя уверенно приписать Base.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

GLM-4.1V-9B-Base

Model Introduction

Vision-Language Models (VLMs) have become foundational components of intelligent systems. As real-world AI tasks grow increasingly complex, VLMs must evolve beyond basic multimodal perception to enhance their reasoning capabilities in complex tasks. This involves improving accuracy, comprehensiveness, and intelligence, enabling applications such as complex problem solving, long-context understanding, and multimodal agents.

Based on the GLM-4-9B-0414 foundation model, we present the new open-source VLM model GLM-4.1V-9B-Thinking, designed to explore the upper limits of reasoning in vision-language models. By introducing a "thinking paradigm" and leveraging reinforcement learning, the model significantly enhances its capabilities. It achieves state-of-the-art performance among 10B-parameter VLMs, matching or even surpassing the 72B-parameter Qwen-2.5-VL-72B on 18 benchmark tasks. We are also open-sourcing the base model GLM-4.1V-9B-Base to support further research into the boundaries of VLM capabilities.
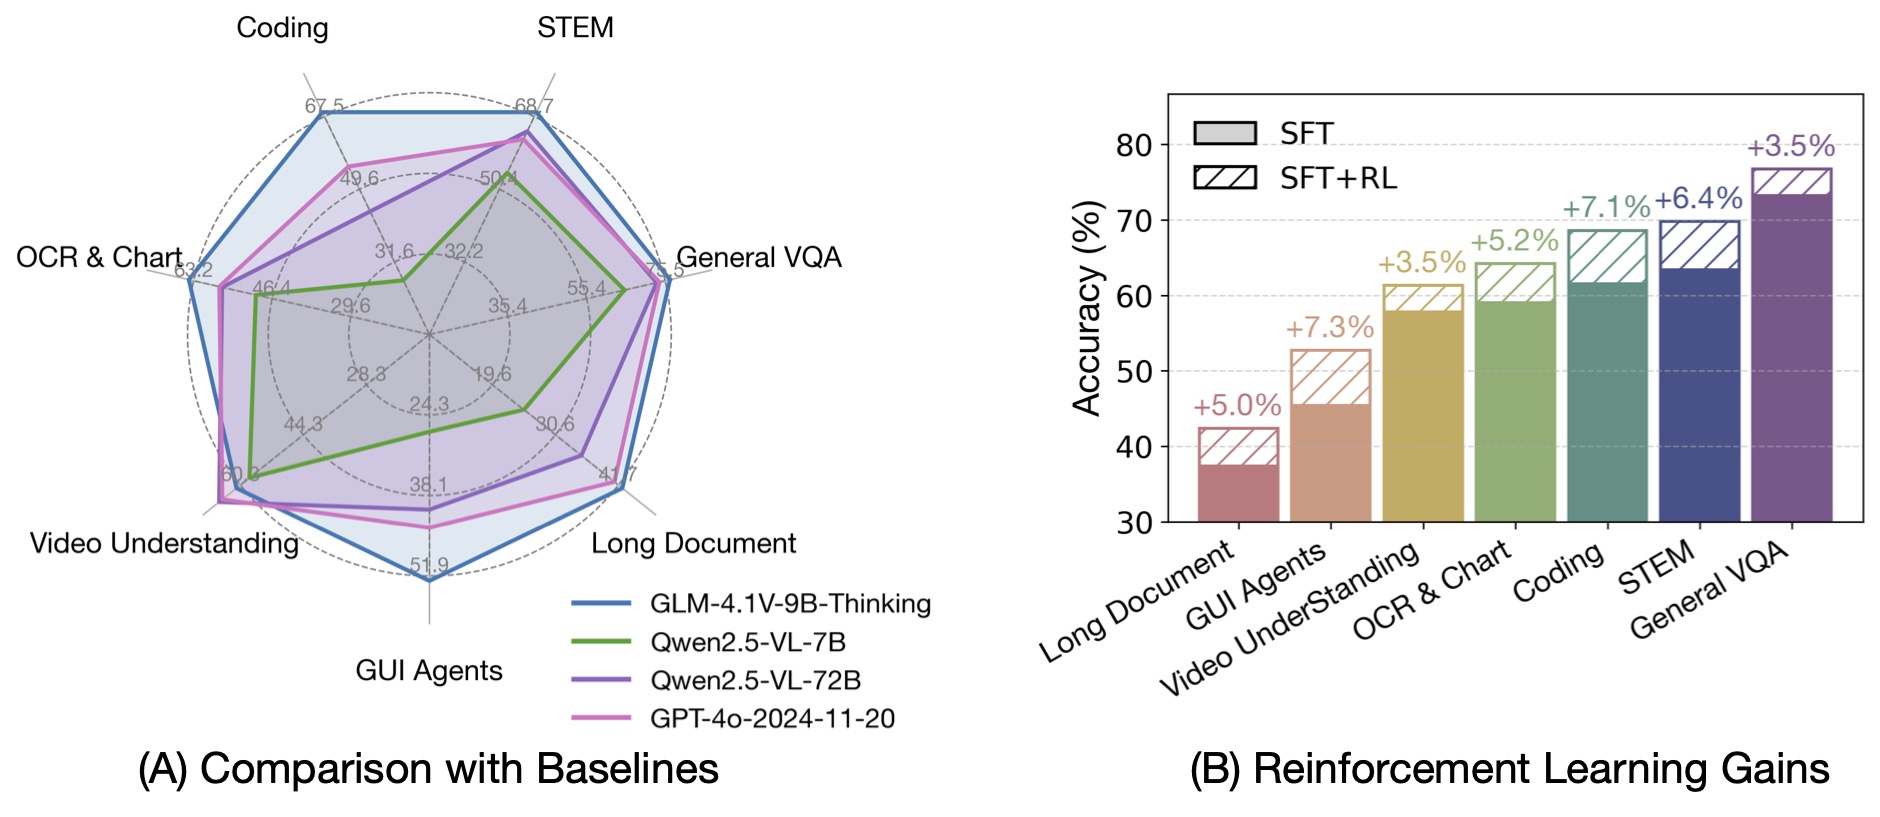
rl

Compared to the previous generation models CogVLM2 and the GLM-4V series, GLM-4.1V-Thinking offers the following improvements:

  1. The first reasoning-focused model in the series, achieving world-leading performance not only in mathematics but also across various sub-domains.
  2. Supports 64k context length.
  3. Handles arbitrary aspect ratios and up to 4K image resolution.
  4. Provides an open-source version supporting both Chinese and English bilingual usage.

Benchmark Performance

By incorporating the Chain-of-Thought reasoning paradigm, GLM-4.1V-9B-Thinking significantly improves answer accuracy, richness, and interpretability. It comprehensively surpasses traditional non-reasoning visual models. Out of 28 benchmark tasks, it achieved the best performance among 10B-level models on 23 tasks, and even outperformed the 72B-parameter Qwen-2.5-VL-72B on 18 tasks.
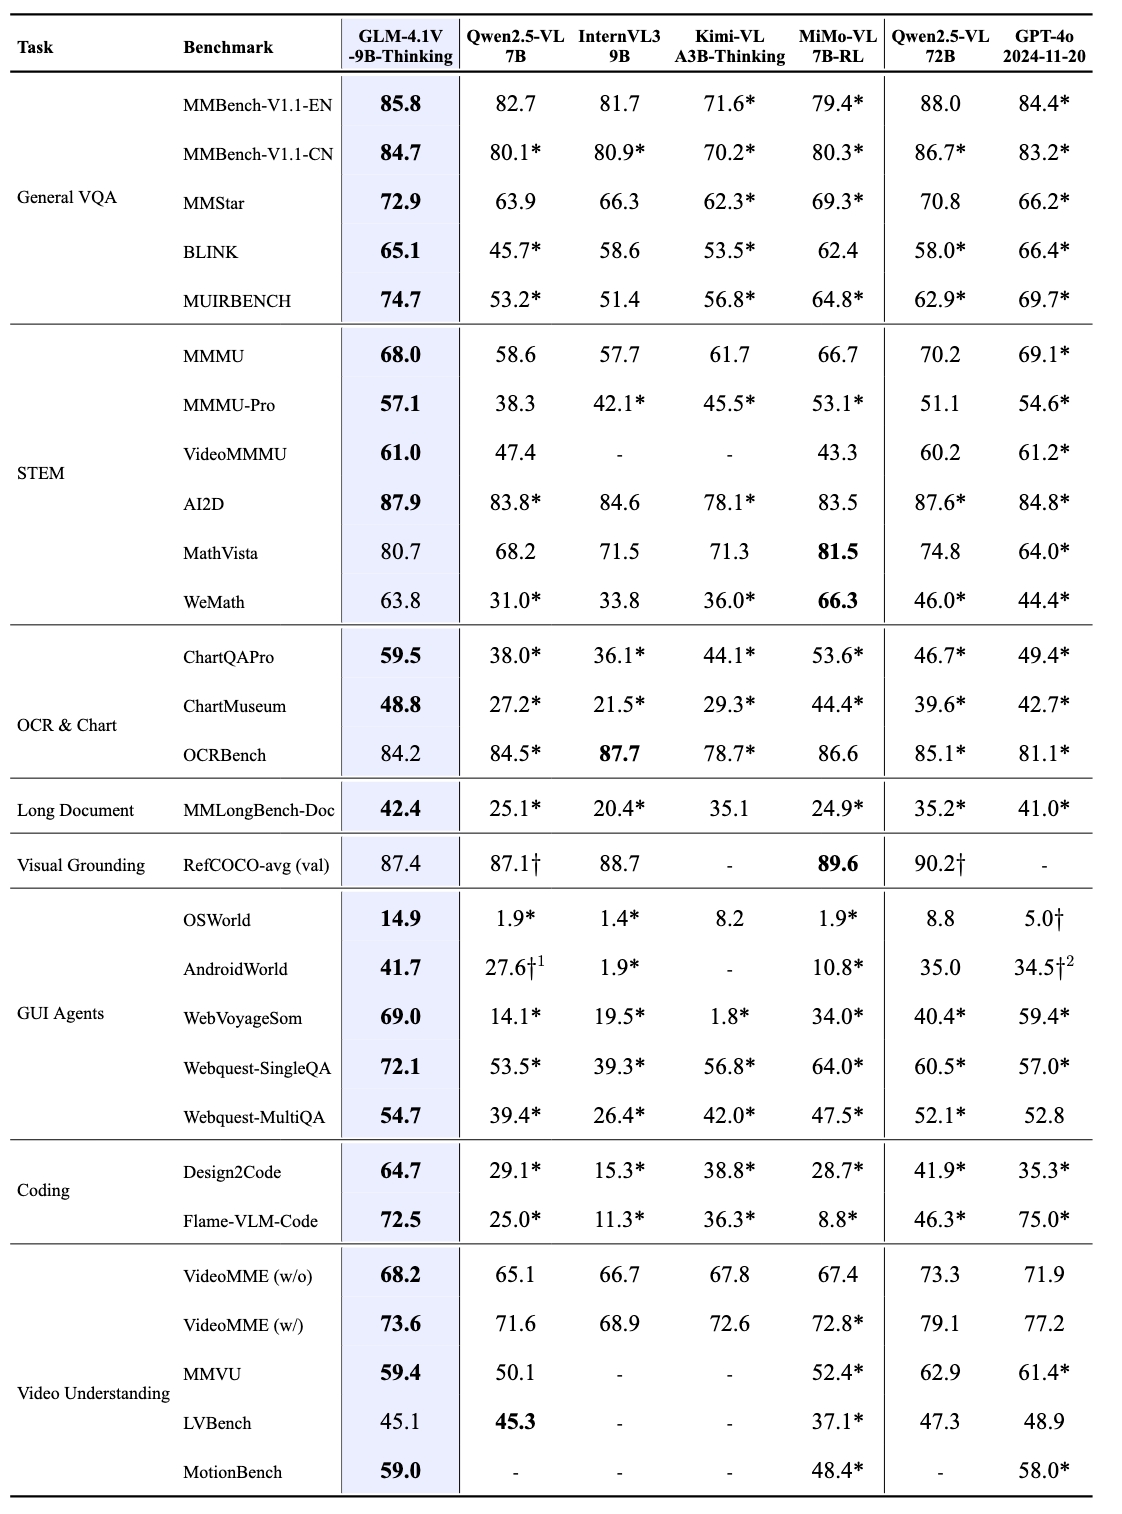
bench

For video reasoning, web demo deployment, and more code, please check our GitHub.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · transformers

Можно запустить

Подбираем GPU…

Класс архитектуры
Glm4vForConditionalGeneration
Ревизия весов
5e8d194

0 моделей