/ Модель

Характеристики

Контекст
202 752 токена
Параметры
23,4 млрд
Лицензия
MIT
Архитектура
glm4_moe · dense
Библиотека
transformers
Опубликована
29 сен 2025

GLM-4.6

Генерация текстаТекст → текст15 профессий

GLM-4.6 — диалоговая языковая модель Zhipu AI для генерации текста и кода, рассуждений и агентных задач с контекстом до 202 752 токенов.

17 781скачиваний за 30 дней1 237лайковвеса обновлены30 сен 2025

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки3

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

  • mercor/apex-agents

    score · выше — лучше

    Результат

    4

    apex-agents 4
    Hugging Face Leaderboards

    Публичная таблицаревизия не подтверждена

  • harborframework/terminal-bench-2.0

    score · выше — лучше

    Результат

    24,5

    terminalbench_2 24,5
    Hugging Face Leaderboards

    Публичная таблицаревизия не подтверждена

  • ScaleAI/SWE-bench_Pro

    score · выше — лучше

    Результат

    9,67

    SWE_Bench_Pro 9,67
    Hugging Face Leaderboards

    Публичная таблицаревизия не подтверждена

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

GLM-4.6 — языковая модель компании Zhipu AI из семейства GLM-4 MoE, доступная в репозитории в формате safetensors для Transformers. Она предназначена для диалогов, программирования, рассуждений и агентных сценариев с вызовом инструментов и поиском. По сравнению с GLM-4.5 улучшены результаты в задачах кодирования и рассуждений, качество генерации интерфейсов и естественность стиля. Модель поддерживает контекст до 202 752 токенов и ориентирована прежде всего на английский и китайский языки.

Модель подходит для генерации и объяснения кода, работы в агентных фреймворках, выполнения многошаговых задач с инструментами и поиска по запросу. В метаданных указано 23,4 млрд параметров и лицензия MIT. README приводит результаты сравнительных оценок, но не содержит подробностей о методике обучения или гарантий качества на конкретных прикладных задачах.

Сценарии применения

  • написание и исправление кода
  • генерация интерфейсов и фронтенд-страниц
  • многошаговые диалоги с вызовом инструментов
  • выполнение поисковых задач агентом
  • рассуждения и подготовка связных текстов

Ограничения

README не приводит подробных ограничений по качеству, фактической точности или безопасному применению; заявленные улучшения основаны на сравнительных оценках разработчика. Для кода рекомендованы отдельные параметры генерации: top_p 0.95 и top_k 40.

Для каких профессий подходит15

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

GLM-4.6

Model Introduction

Compared with GLM-4.5, GLM-4.6 brings several key improvements:

  • Longer context window: The context window has been expanded from 128K to 200K tokens, enabling the model to handle more complex agentic tasks.
  • Superior coding performance: The model achieves higher scores on code benchmarks and demonstrates better real-world performance in applications such as Claude Code、Cline、Roo Code and Kilo Code, including improvements in generating visually polished front-end pages.
  • Advanced reasoning: GLM-4.6 shows a clear improvement in reasoning performance and supports tool use during inference, leading to stronger overall capability.
  • More capable agents: GLM-4.6 exhibits stronger performance in tool using and search-based agents, and integrates more effectively within agent frameworks.
  • Refined writing: Better aligns with human preferences in style and readability, and performs more naturally in role-playing scenarios.

We evaluated GLM-4.6 across eight public benchmarks covering agents, reasoning, and coding. Results show clear gains over GLM-4.5, with GLM-4.6 also holding competitive advantages over leading domestic and international models such as DeepSeek-V3.1-Terminus and Claude Sonnet 4.
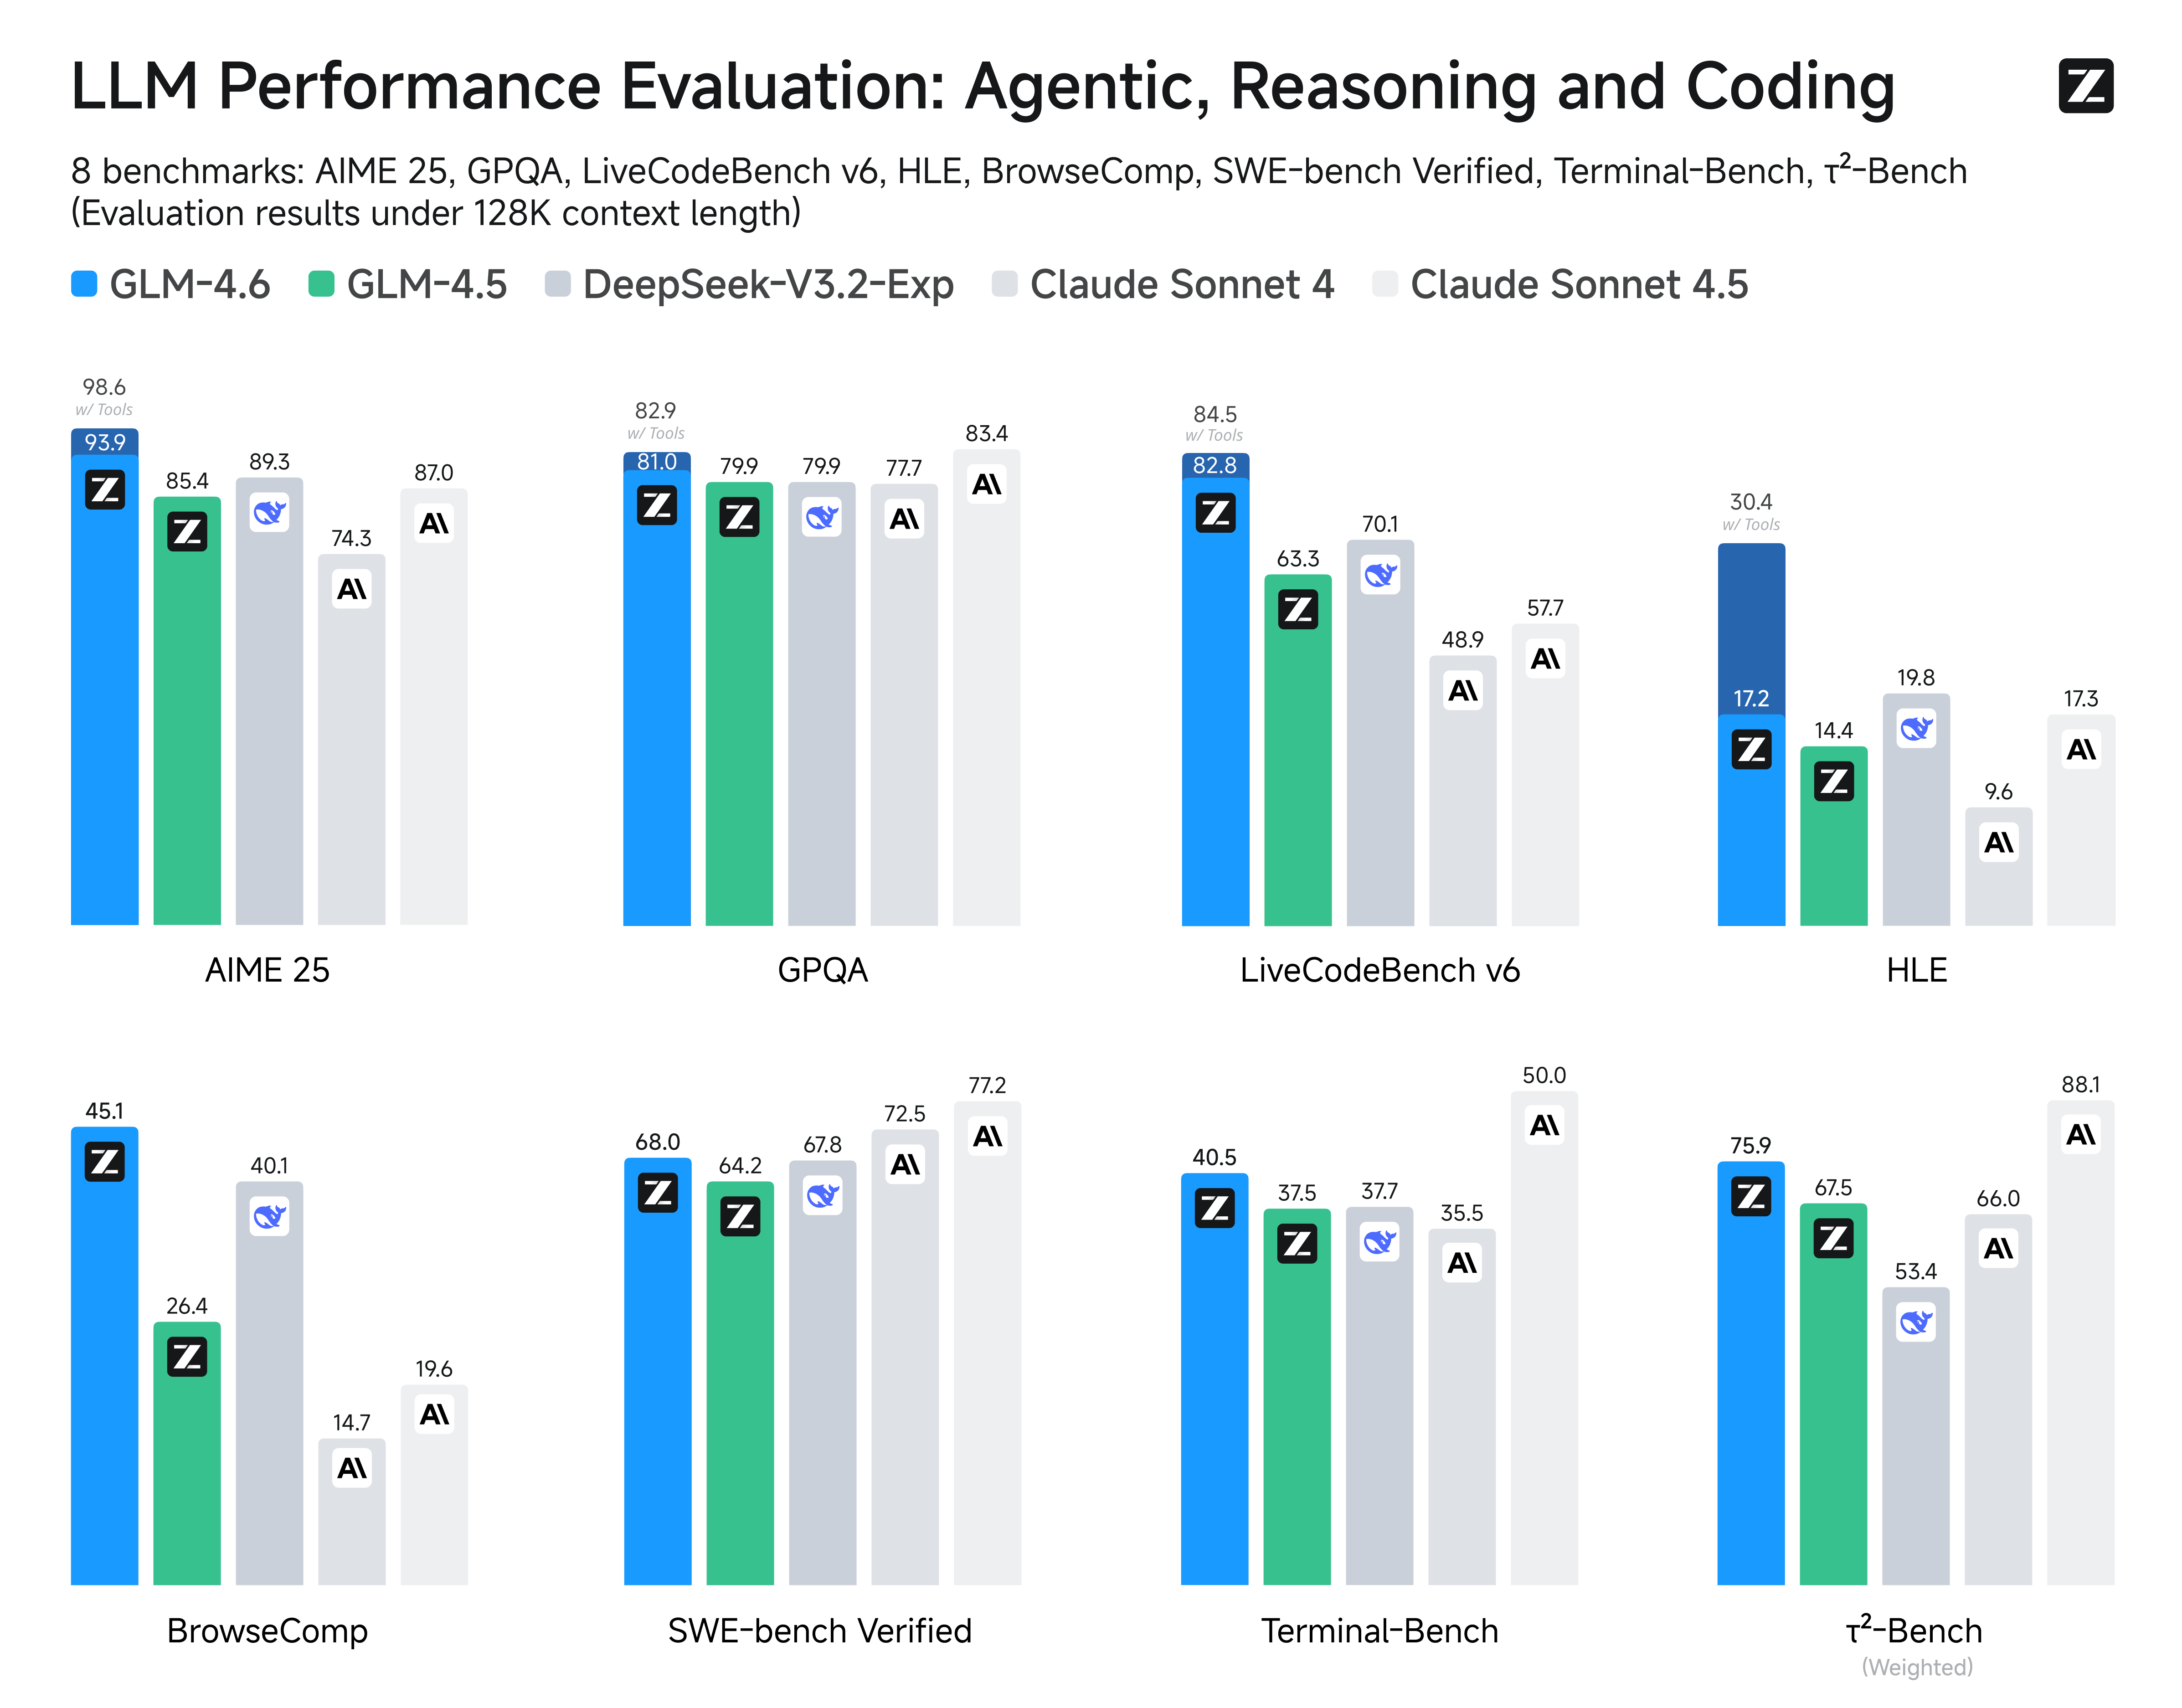
bench

Inference

Both GLM-4.5 and GLM-4.6 use the same inference method.

you can check our github for more detail.

Recommended Evaluation Parameters

For general evaluations, we recommend using a sampling temperature of 1.0.

For code-related evaluation tasks (such as LCB), it is further recommended to set:

  • top_p = 0.95
  • top_k = 40

Evaluation

  • For tool-integrated reasoning, please refer to this doc.
  • For search benchmark, we design a specific format for searching toolcall in thinking mode to support search agent, please refer to this. for the detailed template.

Как запустить

На своей GPU в ailist или через готовый API. Цены — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · transformers

Нельзя запустить

Модель не помещается даже в 8 × 80 ГБ.

API через OpenRouter

z-ai/glm-4.6

Недоступна

$0.5 / $2

Запуск через API временно недоступен: у платформы закончился лимит OpenRouter.

Класс архитектуры
Glm4MoeForCausalLM
Ревизия весов
be72194

0 моделей