/ Модель

Характеристики

Контекст
8 192 токена
Параметры
7,5 млрд
Размер весов
16,1 ГБ
Лицензия
Llama 3
Архитектура
llama · dense
Базовая модель
Meta-Llama-3-8B
Опубликована
13 мая 2024

Llama-3-8B

Генерация текстаТекст → текст4 профессии

Базовая дообученная модель Llama 3 на 7,5 млрд параметров для генерации текста, в том числе на шведском, датском и норвежском языках.

660скачиваний за 30 дней24лайкавеса обновлены11 июл 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

AI Sweden Models — дообученная базовая языковая модель на архитектуре Llama 3 с 7,5 млрд параметров, созданная на основе meta-llama/Meta-Llama-3-8B. Модель предназначена для дальнейшей адаптации под конкретные сценарии; пример в карточке показывает генерацию текста на шведском языке. Это базовая модель, а не instruct-версия.

Модель принимает текст и генерирует продолжение. Контекст составляет до 8192 токенов; в репозитории указаны веса в формате safetensors. В метаданных заявлены шведский, датский и норвежский языки. Лицензия — Llama 3 License (llama3).

Сценарии применения

  • генерация продолжений текста на шведском языке
  • адаптация языковой модели под конкретную задачу
  • создание базовой модели для последующего инструкционного дообучения

Ограничения

Это базовая модель, не предназначенная для диалогового следования инструкциям без дополнительной адаптации. В карточке нет оценки качества и описания специализированных возможностей.

Для каких профессий подходит4

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

AI-Sweden-Models/Llama-3-8B

Intended usage:

This is a base model, it can be finetuned to a particular use case.

-----> instruct version here <-----

Use with transformers

See the snippet below for usage with Transformers:

import transformers
import torch

model_id = "AI-Sweden-Models/Llama-3-8B"

pipeline = transformers.pipeline(
    task="text-generation",
    model=model_id,
    model_kwargs={"torch_dtype": torch.bfloat16},
    device_map="auto"
)

pipeline(
    text_inputs="Sommar och sol är det bästa jag vet",
    max_length=128,
    repetition_penalty=1.03
)
>>> "Sommar och sol är det bästa jag vet!
Och nu när jag har fått lite extra semester så ska jag njuta till max av allt som våren och sommaren har att erbjuda.
Jag har redan börjat med att sitta ute på min altan och ta en kopp kaffe och läsa i tidningen, det är så skönt att bara sitta där och njuta av livet.

Ikväll blir det grillat och det ser jag fram emot!"

Training information

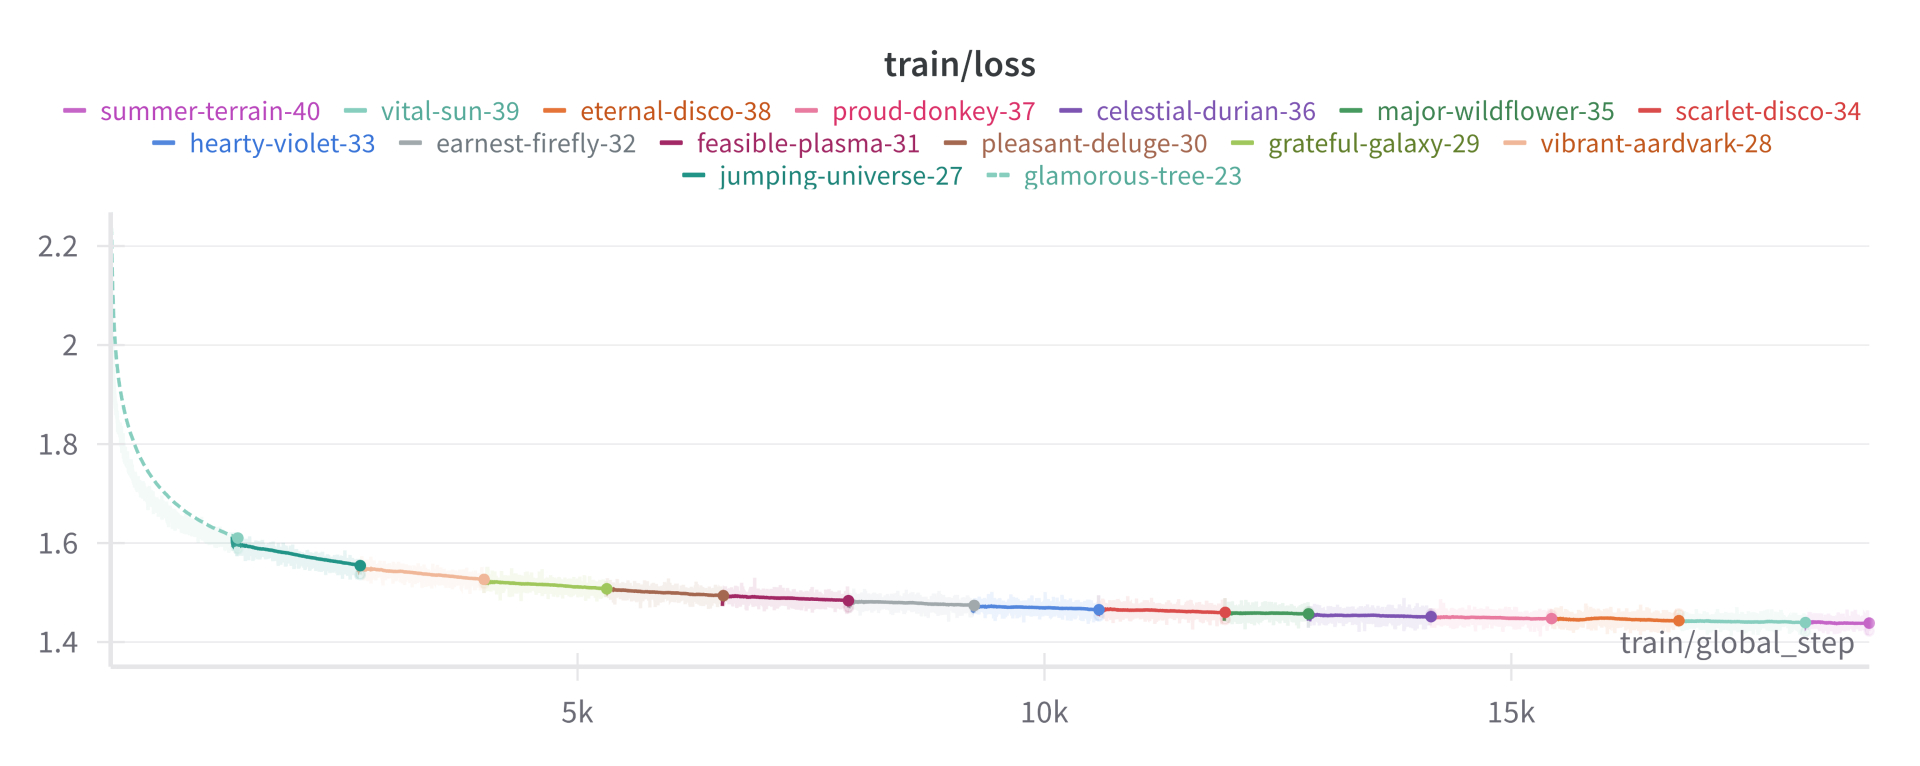
AI-Sweden-Models/Llama-3-8B is a continuation of the pretraining process from meta-llama/Meta-Llama-3-8B. It was trained on a subset from The Nordic Pile containing Swedish, Norwegian and Danish. The training is done on all model parameters, it is a full finetune.

The training dataset consists of 227 105 079 296 tokens. It was trained on the Rattler supercomputer at the Dell Technologies Edge Innovation Center in Austin, Texas. The training used 23 nodes of a duration of 30 days, where one node contained 4X Nvidia A100 GPUs, yielding 92 GPUs.

trainer.yaml:

learning_rate: 2e-5
warmup_steps: 100
lr_scheduler: cosine
optimizer: adamw_torch_fused
max_grad_norm: 1.0
gradient_accumulation_steps: 16
micro_batch_size: 1
num_epochs: 1
sequence_len: 8192

deepspeed_zero2.json:

{
  "zero_optimization": {
    "stage": 2,
    "offload_optimizer": {
      "device": "cpu"
    },
    "contiguous_gradients": true,
    "overlap_comm": true
  },
  "bf16": {
    "enabled": "auto"
  },
  "fp16": {
    "enabled": "auto",
    "auto_cast": false,
    "loss_scale": 0,
    "initial_scale_power": 32,
    "loss_scale_window": 1000,
    "hysteresis": 2,
    "min_loss_scale": 1
  },
  "gradient_accumulation_steps": "auto",
  "gradient_clipping": "auto",
  "train_batch_size": "auto",
  "train_micro_batch_size_per_gpu": "auto",
  "wall_clock_breakdown": false
}
Checkpoints

  • 15/6/2024 (18833) => 1 epoch
  • 11/6/2024 (16000)
  • 07/6/2024 (14375)
  • 03/6/2024 (11525)
  • 29/5/2024 (8200)
  • 26/5/2024 (6550)
  • 24/5/2024 (5325)
  • 22/5/2024 (3900)
  • 20/5/2024 (2700)
  • 13/5/2024 (1500)

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
LlamaForCausalLM
Ревизия весов
dd940c5

0 моделей