YuyuanQA-GPT2-3.5B
- Main Page:Fengshenbang
- Github: Fengshenbang-LM
简介 Brief Introduction
善于处理医疗问答任务,医疗的领域模型,英文版的GPT2。
Good at handling medical question answering tasks, a medical domain model, GPT2 in English.
模型分类 Model Taxonomy
| 需求 Demand | 任务 Task | 系列 Series | 模型 Model | 参数 Parameter | 额外 Extra |
|---|---|---|---|---|---|
| 特殊 Special | 领域 Domain | 余元 Yuyuan | GPT2 | 3.5B | 问答 QA |
模型信息 Model Information
问答在自然语言处理领域中反映AI系统的知识水平的重要任务。为了可以在医疗领域中使用强大的问答能力的语言模型,我们基于Yuyuan-GPT2-3.5B,对其使用了10K条医疗的问答对进行微调。我们希望探索一种简单、有效的方式直接实现问答系统而不需要额外的设计,即利用大模型强大的记忆力和理解能力。
Question answering (QA) is an important task in the Natural Language Processing to present the knowledge level of AI systems. To provide a language model with powerful QA capability in the medical domain, we fine-tuned Yuyuan-GPT2-3.5B on 10K medical Q&A pairs.
下游任务 Performance
我们测试了该模型在未见过的100条QA对上的表现:
We tested the model on 100 unseen QA pairs:
| gram | 1-gram | 2-gram | 3-gram | 4-gram |
|---|---|---|---|---|
| bleu score | 0.357727 | 0.2713 | 0.22304 | 0.19099 |
使用 Usage
加载模型 Loading Models
from transformers import GPT2Tokenizer,GPT2LMHeadModel

hf_model_path = 'YuyuanQA-GPT2-3.5B'

tokenizer = GPT2Tokenizer.from_pretrained(hf_model_path)
model = GPT2LMHeadModel.from_pretrained(hf_model_path)
使用示例 Usage Examples
fquestion = "What should gout patients pay attention to in diet?"
inputs = tokenizer(f'Question:{question} answer:',return_tensors='pt')

generation_output = model.generate(**inputs,
                                return_dict_in_generate=True,
                                output_scores=True,
                                max_length=150,
                                # max_new_tokens=80,
                                do_sample=True,
                                top_p = 0.6,
                                eos_token_id=50256,
                                pad_token_id=0,
                                num_return_sequences = 5)

for idx,sentence in enumerate(generation_output.sequences):
    print('next sentence %d:\n'%idx,
          tokenizer.decode(sentence).split('<|endoftext|>')[0])
    print('*'*40)
演示 Demo
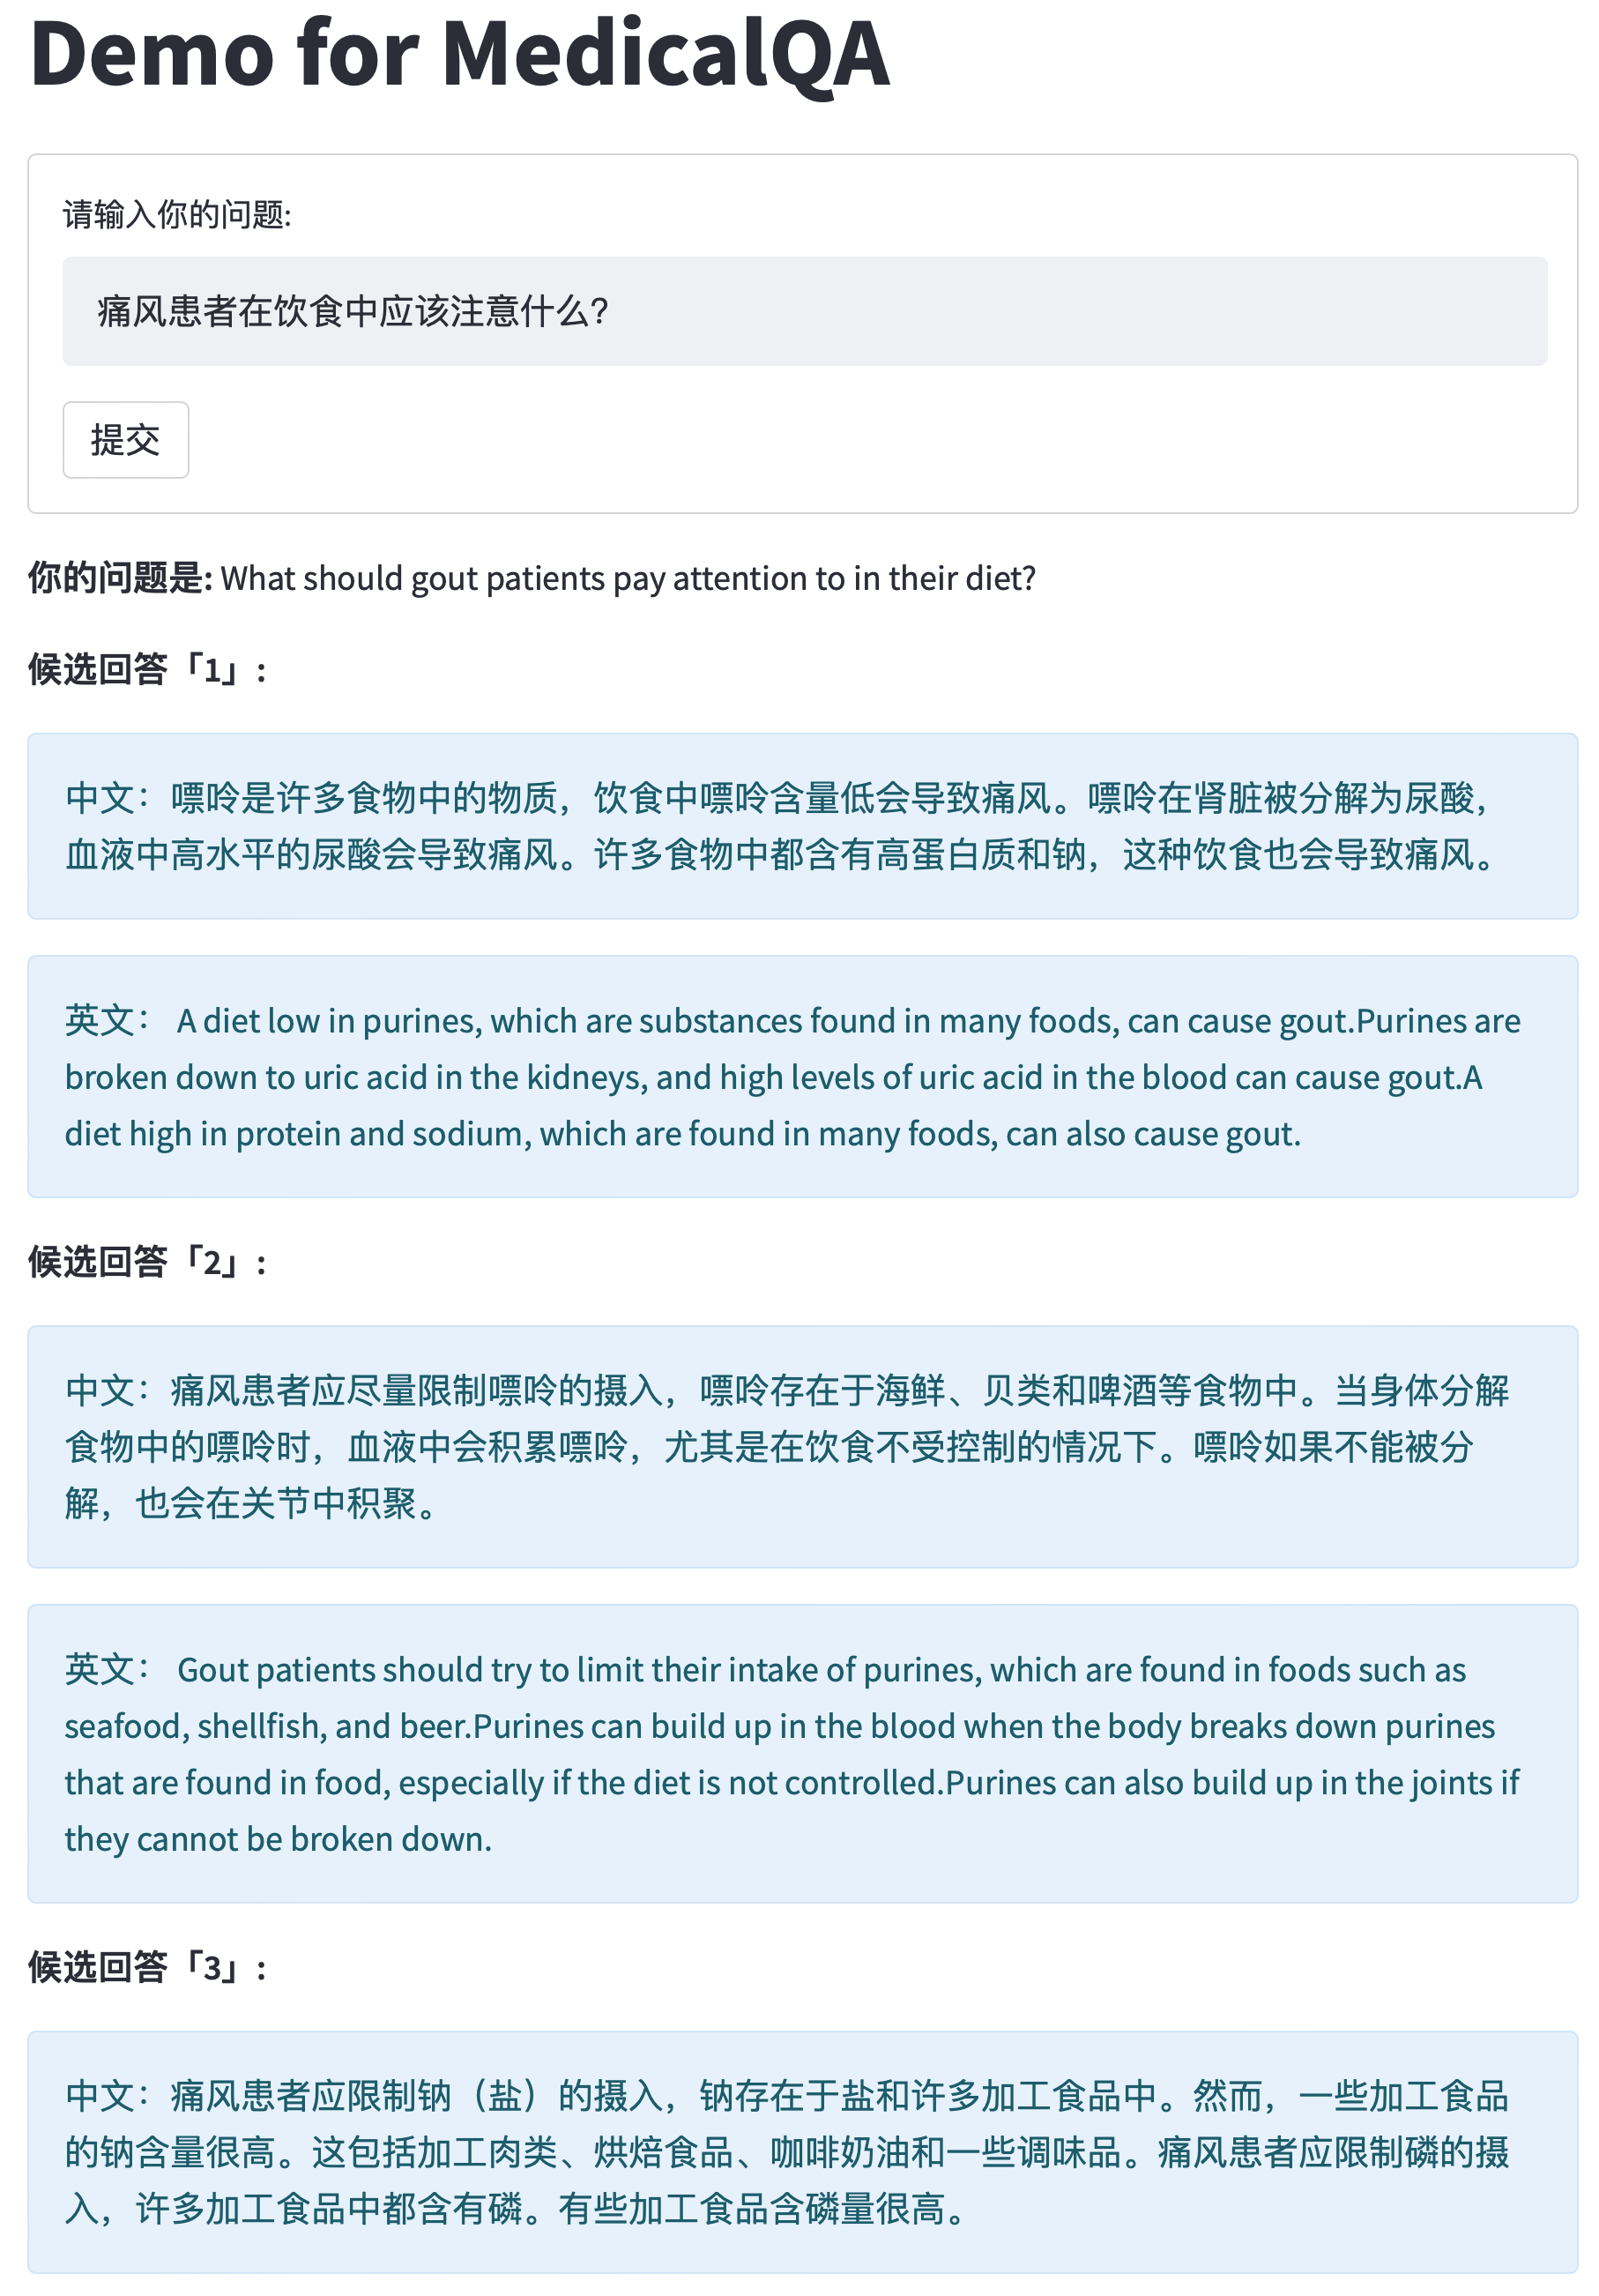
我们用该模型做了一个医疗问答演示。
We made a demo of medical QA system with this model.
引用 Citation
如果您在您的工作中使用了我们的模型,可以引用我们的论文:
If you are using the resource for your work, please cite the our paper:
@article{fengshenbang,
  author    = {Jiaxing Zhang and Ruyi Gan and Junjie Wang and Yuxiang Zhang and Lin Zhang and Ping Yang and Xinyu Gao and Ziwei Wu and Xiaoqun Dong and Junqing He and Jianheng Zhuo and Qi Yang and Yongfeng Huang and Xiayu Li and Yanghan Wu and Junyu Lu and Xinyu Zhu and Weifeng Chen and Ting Han and Kunhao Pan and Rui Wang and Hao Wang and Xiaojun Wu and Zhongshen Zeng and Chongpei Chen},
  title     = {Fengshenbang 1.0: Being the Foundation of Chinese Cognitive Intelligence},
  journal   = {CoRR},
  volume    = {abs/2209.02970},
  year      = {2022}
}
也可以引用我们的网站:
You can also cite our website:
@misc{Fengshenbang-LM,
  title={Fengshenbang-LM},
  author={IDEA-CCNL},
  year={2021},
  howpublished={\url{https://github.com/IDEA-CCNL/Fengshenbang-LM}},
}