Poseless-3B
Introduction
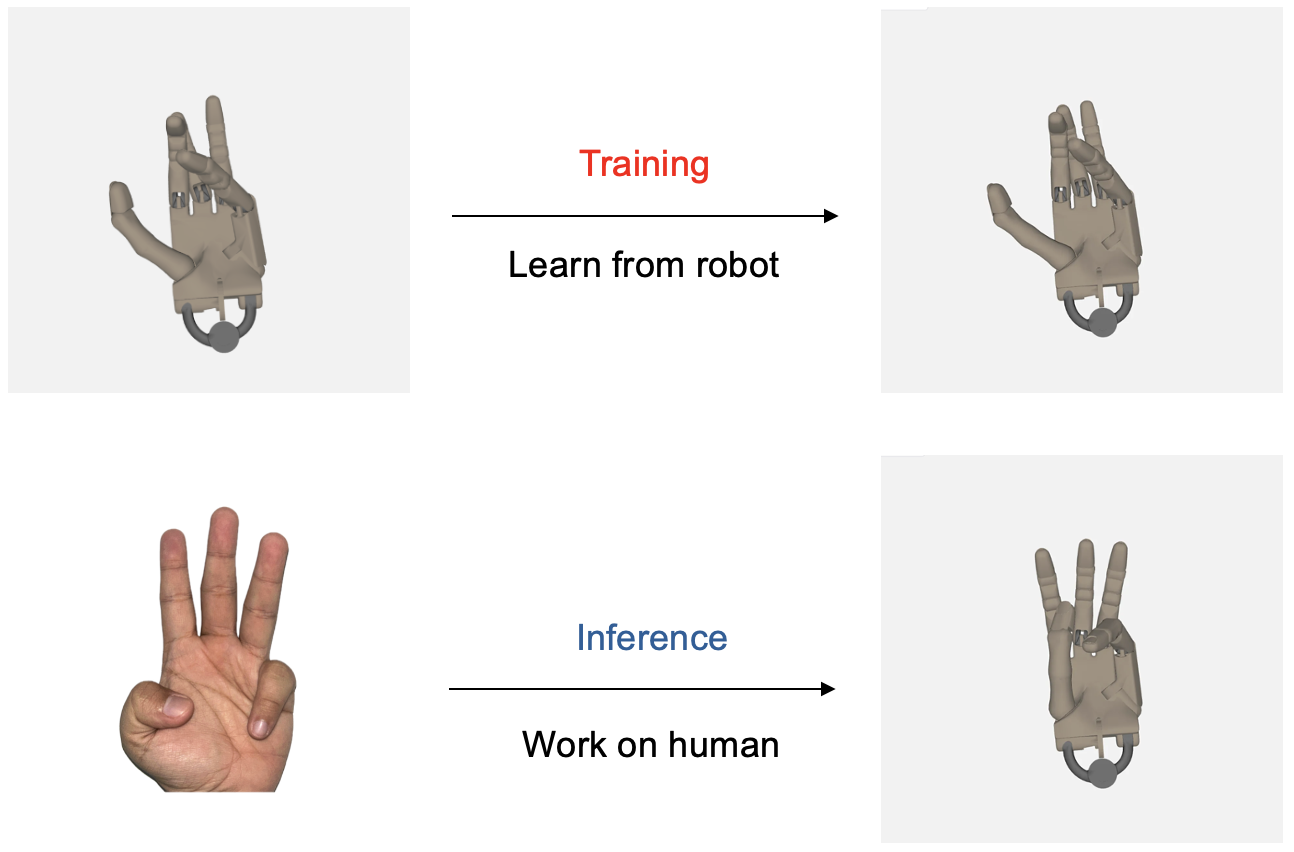
"PoseLess: Depth-Free Vision-to-Joint Control via Direct Image Mapping with VLM" (Paper) introduces a novel framework for robot hand control that eliminates the need for explicit pose estimation by directly mapping 2D images to joint angles using projected representations. Our approach leverages synthetic training data generated through randomized joint configurations, enabling zero-shot generalization to real-world scenarios and cross-morphology transfer from robotic to human hands. By projecting visual inputs and employing a transformer-based decoder, PoseLess achieves robust, low-latency control while addressing challenges such as depth ambiguity and data scarcity. Experimental results demonstrate competitive performance in joint angle prediction accuracy without relying on any human-labelled dataset
Our key contributions are as follows:
- We introduce a novel framework that leverages a VLM (e.g., Qwen 2.5 3B Instruct) to directly map monocular images to robot joint angles, bypassing pose estimation entirely. The VLM’s ability to "see" and project images enables robust, morphology-agnostic feature extraction, reducing error propagation inherent in two-stage pipelines.
- We introduce a synthetic data pipeline generates infinite training examples by randomizing joint angles and domain-randomizing visual features (e.g., lighting, textures). This eliminates reliance on costly labeled datasets while ensuring robustness to real-world variations.
- We provide evidence of the model’s cross-morphology generalization, demonstrating its ability to mimic human hand movements despite being trained solely on robot hand data. These findings mark a significant step toward understanding and leveraging such generalization for broader applications.
- We provide evidence that depth-free control is possible paving way for later adoption with camera that is not supporting depth estimation capability that is frequently used in robotics research.
Model Details
- Model architecture: Qwen 2.5 3B Instruct, fine-tuned for hand pose estimation
- Dataset:
- License: Apache-2.0 license
- Developed by: Alan Dao, Dinh Bach Vu, Tuan Le Duc Anh, Bui Quang Huy (Menlo Research)
How to Get Started
import torch
from PIL import Image
from transformers import AutoProcessor, Qwen2_5_VLForConditionalGeneration
from qwen_vl_utils import process_vision_info

# 1. Load model and processor
device = "cuda" if torch.cuda.is_available() else "cpu"
model_path = "homebrewltd/Poseless-3B"

model = Qwen2_5_VLForConditionalGeneration.from_pretrained(
    model_path,
    trust_remote_code=True,
    torch_dtype=torch.bfloat16
).eval().to(device)

processor = AutoProcessor.from_pretrained(
    model_path,
    min_pixels=256*28*28,
    max_pixels=1280*28*28,
    trust_remote_code=True
)

# 2. Prepare your image
image = Image.open("your_hand_image.png").convert("RGB")

# 3. Create messages
SYSTEM_PROMPT = """You are a specialized Vision Language Model designed to accurately estimate joint angles from hand pose images. Your task is to analyze images of a human or robotic hand and output precise angle measurements for each joint. Output joint angles in radians.
Output Format:
<lh_WRJ2>angle</lh_WRJ2><lh_WRJ1>angle</lh_WRJ1><lh_FFJ4>angle</lh_FFJ4><lh_FFJ3>angle</lh_FFJ3><lh_FFJ2>angle</lh_FFJ2><lh_FFJ1>angle</lh_FFJ1><lh_MFJ4>angle</lh_MFJ4><lh_MFJ3>angle</lh_MFJ3><lh_MFJ2>angle</lh_MFJ2><lh_MFJ1>angle</lh_MFJ1><lh_RFJ4>angle</lh_RFJ4><lh_RFJ3>angle</lh_RFJ3><lh_RFJ2>angle</lh_RFJ2><lh_RFJ1>angle</lh_RFJ1><lh_LFJ5>angle</lh_LFJ5><lh_LFJ4>angle</lh_LFJ4><lh_LFJ3>angle</lh_LFJ3><lh_LFJ2>angle</lh_LFJ2><lh_LFJ1>angle</lh_LFJ1><lh_THJ5>angle</lh_THJ5><lh_THJ4>angle</lh_THJ4><lh_THJ3>angle</lh_THJ3><lh_THJ2>angle</lh_THJ2><lh_THJ1>angle</lh_THJ1>
"""

messages = [
    {"role": "system", "content": f"{SYSTEM_PROMPT}"},
    {
        "role": "user",
        "content": [
            {
                "type": "image",
                "image": image,
                "min_pixels": 1003520,
                "max_pixels": 1003520,
            },
            {"type": "text", "text": "<Pose>"},
        ],
    },
]

# 4. Process and get predictions
text = processor.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
image_inputs, video_inputs = process_vision_info(messages)
inputs = processor(text=[text], images=image_inputs, videos=video_inputs, padding=True, return_tensors="pt").to(device)

# 5. Generate output
generated_ids = model.generate(**inputs, max_new_tokens=1024)
generated_ids_trimmed = [out_ids[len(in_ids):] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)]
output_text = processor.batch_decode(generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False)[0]

print(output_text)  # This will show the joint angles in XML format
The output will be joint angles in radians in XML format:
<lh_WRJ2>angle</lh_WRJ2><lh_WRJ1>angle</lh_WRJ1><lh_FFJ4>angle</lh_FFJ4>...
Citation
- arxiv.org/abs/2503.07111
More Information
- Contact the authors at alan@menlo.ai, bach@menlo.ai, charles@menlo.ai, yuuki@menlo.ai for further details.