/ Модель

Характеристики

Контекст
131 072 токена
Параметры
3,2 млрд
Размер весов
6,4 ГБ
Лицензия
Llama 3.2
Архитектура
llama · dense
Базовая модель
Llama-3.2-3B-Instruct
Библиотека
transformers
Опубликована
7 апр 2025

ReZero-v0.1-llama-3.2-3b-it-grpo-250404

Генерация текстаТекст → текст3 профессии

Экспериментальная модель Menlo на базе Llama 3.2 3B Instruct, дообученная для итеративного поиска ответов с уточнением запросов и повторными попытками.

155скачиваний за 30 дней63лайкавеса обновлены17 апр 2025

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

ReZero-v0.1 — экспериментальная языковая модель Menlo на архитектуре LlamaForCausalLM с 3,2 млрд параметров, дообученная на основе meta-llama/Llama-3.2-3B-Instruct методом обучения с подкреплением. Она предназначена для поиска ответов через взаимодействие с поисковыми системами: модель может уточнять запросы и повторять поиск, стремясь находить точные сведения, а не полагаться только на запомненные данные. Карточка описывает эксперименты на отчёте о миссиях Apollo и демонстрационный интерфейс; контекст модели — до 131 072 токенов. Модель принимает текст и генерирует текст, ориентирована на английский язык.

Модель можно применять для исследования стратегий итеративного поиска и создания диалоговых прототипов с поисковыми инструментами. В карточке указана лицензия Llama 3.2. Результаты приведённых экспериментов ограничены одной тематической задачей: лучшая указанная точность составила 46,88%, а в обучающих запусках наблюдалось падение награды и нестабильность потерь.

Сценарии применения

  • исследование стратегий повторного поиска точных ответов
  • уточнение поисковых запросов в диалоговом прототипе
  • проверка взаимодействия языковой модели с поисковыми инструментами
  • эксперименты с обучением с подкреплением для задач поиска

Ограничения

В README приведены эксперименты только на наборе об отчёте о миссиях Apollo; лучший указанный результат — точность 46,88%. В описанных запусках наблюдалось падение награды, а в одном из них также сообщается о нестабильности потерь.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

ReZero: Enhancing LLM search ability by trying one-more-time
rezero.png

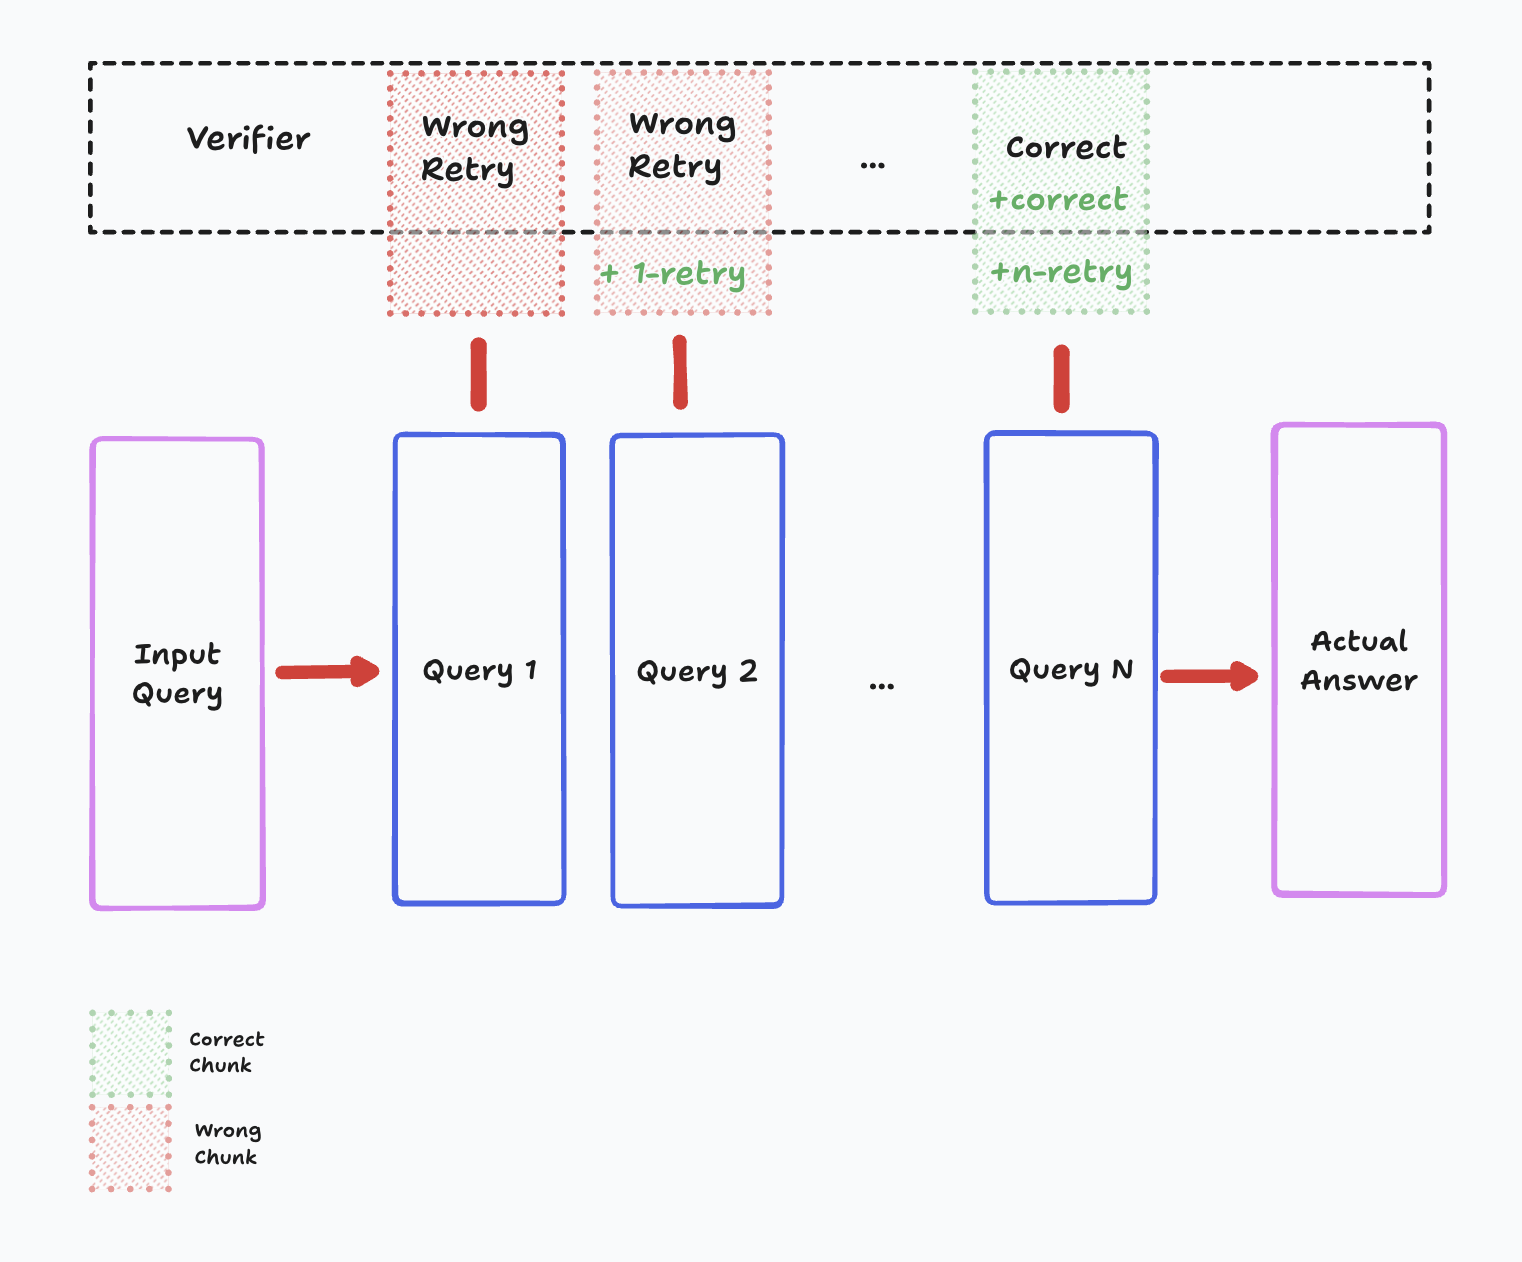
ReZero trains a small language model to develop effective search behaviors instead of memorizing static data. It interacts with multiple synthetic search engines, each with unique retrieval mechanisms, to refine queries and persist in searching until it finds exact answers. The project focuses on reinforcement learning, preventing overfitting, and optimizing for efficiency in real-world search applications.

Quick Demo 🚀

demo.gif

Run the interactive web interface to see ReZero in action:

python app.py

This will launch a Gradio interface where you can interact with the model and test different search behaviors.

Setup 🛠️

# Clone the repository
git clone https://github.com/menloresearch/ReZero
cd ReZero

# Create virtual environment
python -m venv .venv

# Activate the environment
source .venv/bin/activate

# Install dependencies
pip install --upgrade pip
pip install -e .

# Set up environment variables (required for websearch demo)
cp .env.example .env
# Edit .env and add your Tavily API key if you want to use the websearch demo

Data and Training 🧠

All necessary training data is included in the data/ folder. To train:

python train_grpo.py

If you want to regenerate the data, please run:

python scripts/generate_data.py

Models 🤖

You can find our models on Hugging Face 🤗! We're committed to open-source and easy access for the research community.

ModelBackboneSizeLinkGGUF
ReZero-v0.1Llama-3.2-3B3B🤗 Menlo/ReZero-v0.1-llama-3.2-3b-it-grpo-250404🤗 GGUF

Experiments 🧪

Run IDModel ConfigDatasetStepsHardwareTensorBoardDescription
exp-01Llama-3.2-3b-instructApollo Mission Report300~2 hours on 1xH200📊Added reward_search_strategy and reward_search_quality. Reward weights: [4.0, 2.0, 1.0, 1.0, 1.0, 1.0]. Loss crashed after step 400. Best accuracy: 31.25% at step 400. Max agent turns: 10.
exp-02Llama-3.2-3b-instructApollo Mission Report1000~7 hours on 1xH200📊Improved reward_retry logic to only reward search when answers found. Increased max agent turns to 20. Reward weights: [4.0, 2.0, 1.0, 1.0, 1.0, 1.0]. Best accuracy: 46.88% at step 250. Higher early reward_correctness (~0.6 vs 0.4-0.5). Loss stable but reward crashed after step 350.
exp-03Llama-3.2-3b-instructApollo Mission Report1000~7 hours on 1xH200📊Same as exp-02 but without the retry reward function.

References 📖

arxiv.org/abs/2504.11001

Acknowledgements 🤝

  • This project is kickstarted from the source code of AutoDidact

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · transformers

Можно запустить

Подбираем GPU…

Класс архитектуры
LlamaForCausalLM
Ревизия весов
7b5e4f1

0 моделей