/ Модель

Характеристики

Лицензия
Apache 2.0
Архитектура
qwen2 · dense
Базовая модель
Qwen2.5-Coder-32B-abliterated
Опубликована
1 июл 2026

Qwen2.5-Coder-32B-abliterated-GGUF

Генерация текстаТекст → текст8 профессий

TobiasLogic/Qwen2.5-Coder-32B-abliterated-GGUF — это квантованная в формате GGUF Q4_K_M версия модели TobiasLogic/Qwen2.5-Coder-32B-abliterated, созданной на основе Qwen/Qwen2.5-Coder-32B-Instruct.

1 722скачиваний за 30 дней1лайквеса обновлены6 июл 2026

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Модель предназначена прежде всего для генерации, анализа и редактирования программного кода, а также для локального текстового общения. Разработчик удалил из исходной fp16-модели направление отказа, связанное с безопасностными ограничениями, после чего выполнил 4-битную квантование с помощью llama.cpp.

Модель поддерживает запуск на CPU и GPU через Ollama или llama.cpp. Размер файла составляет примерно 19–20 ГБ; модель рассчитана на запуск на одной видеокарте с 24 ГБ VRAM. В README явно указан английский язык, а максимальный контекст для примера запуска составляет 8192 токена, однако полный размер контекстного окна не указан. По результатам EvalPlus модель показывает 89,6% на HumanEval, 84,8% на HumanEval+, 91,3% на MBPP и 77,0% на MBPP+. Эти показатели близки к базовой модели в задачах программирования, но относятся к измерениям, выполненным разработчиком.

Ключевая особенность модели — отсутствие исходного поведения, связанного с отказами: в указанной проверке доля отказов снизилась с 96,9% у базовой Qwen2.5-Coder-32B-Instruct до 0,0% у abliterated-версии. Это может расширять диапазон запросов, но одновременно увеличивает риски генерации вредного или небезопасного содержимого; модель не следует воспринимать как безопасную без дополнительного контроля. Распространяется по лицензии Apache-2.0, унаследованной от базовой модели.

Для каких профессий подходит8

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Qwen2.5-Coder-32B-abliterated — GGUF (Q4_K_M)

Q4_K_M GGUF quantization of TobiasLogic/Qwen2.5-Coder-32B-abliterated, an abliterated (uncensored) build of Qwen/Qwen2.5-Coder-32B-Instruct.

The refusal direction (Arditi et al. 2024, "Refusal in LLMs is mediated by a single direction") was orthogonalized out of every residual-writing weight in the fp16 model, then quantized to GGUF with llama.cpp. Runs on CPU or GPU via Ollama / llama.cpp; ~20 GB, fits comfortably in 24 GB VRAM.

Refusal rate (held-out harmful eval, measured on the fp16 model)

refusal rate
base Qwen2.5-Coder-32B-Instruct96.9%
abliterated0.0%

Benchmarks

Coding capability scored with the official EvalPlus harness — greedy decoding, pass@1, every solution executed against unit tests. Both columns use the same harness, so it's a true apples-to-apples comparison against the full-precision base model.
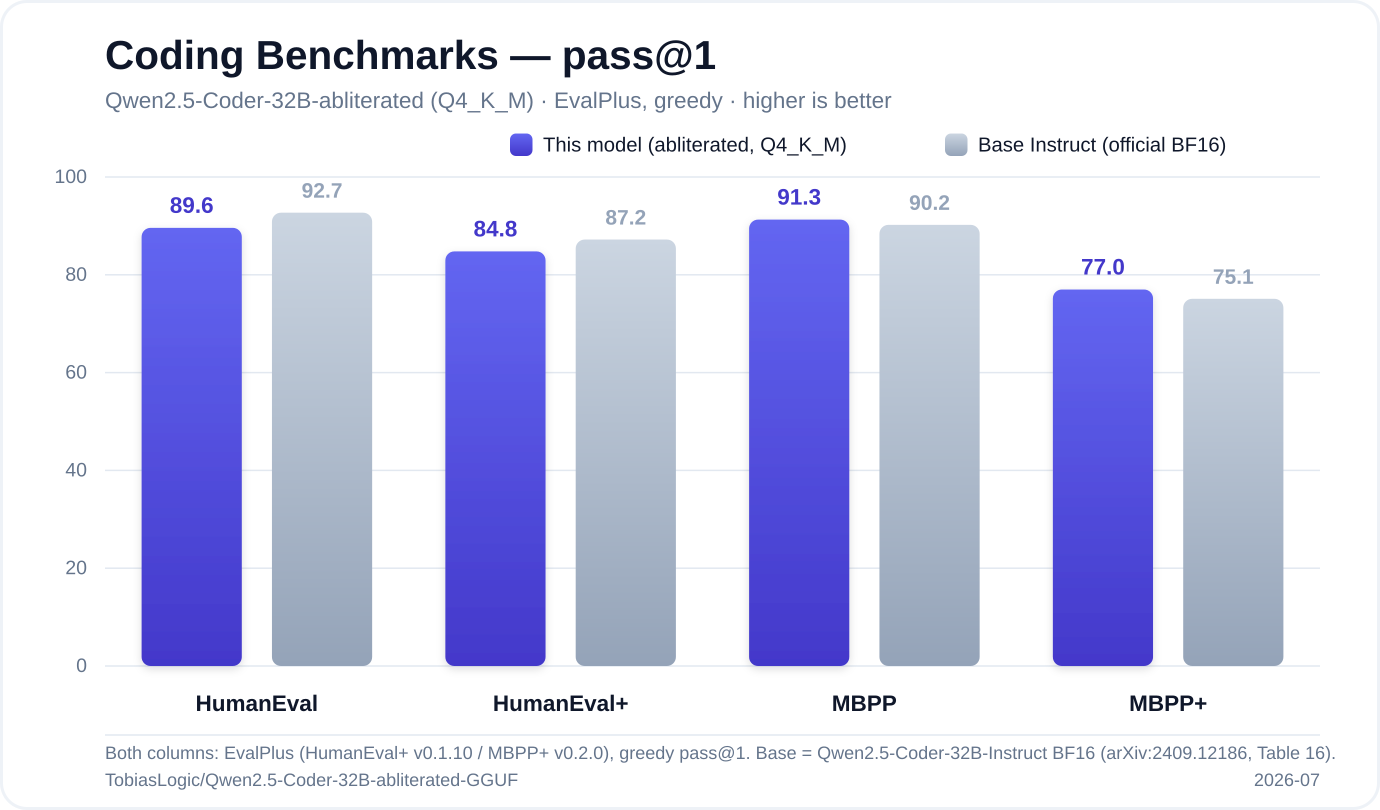
Coding benchmarks: pass@1

BenchmarkThis model (abliterated, Q4_K_M)Base Instruct (official BF16)
HumanEval89.6%92.7%
HumanEval+84.8%87.2%
MBPP91.3%90.2%
MBPP+77.0%75.1%

Abliteration removed refusals without breaking coding ability. The uncensored 4-bit build stays within ~3 points of the base on HumanEval and beats it on both MBPP variants — average delta ≈ −0.6 points across the four benchmarks. Not bad for a 19 GB GGUF you can run on a single 24 GB GPU.

Base numbers: Qwen2.5-Coder-32B-Instruct, tech report Table 16. Measured 2026-07, Q4_K_M via Ollama.

Usage

Ollama (a Modelfile is included in this repo):

# after downloading qwen2.5-coder-32b-abliterated-Q4_K_M.gguf and Modelfile:
ollama create qwen-coder-abliterated -f Modelfile
ollama run qwen-coder-abliterated

llama.cpp:

llama-cli -m qwen2.5-coder-32b-abliterated-Q4_K_M.gguf \
  -p "Write a port scanner in Python." -c 8192

Links

License

Apache-2.0, inherited from the base model. You are responsible for how you use this model and for complying with applicable law.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

llama.cpp

Нельзя запустить

GGUF-модель ждёт проверки: нужно выбрать файл кванта под доступные GPU.

Класс архитектуры
Qwen2ForCausalLM
Ревизия весов
b58cb0c

0 моделей