/ Модель

Характеристики

Контекст
512 токенов
Параметры
152 млн
Архитектура
bert · dense
Опубликована
2 мар 2022

bert-base-finnish-cased-v1

Заполнение пропусковТекст → текст5 профессий

Финская модель BERT для заполнения пропусков и дообучения под задачи анализа финского текста.

8 334скачиваний за 30 дней10лайковвеса обновлены20 фев 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

TurkuNLP/bert-base-finnish-cased-v1 — финская версия BERT, разработанная TurkuNLP и обученная с нуля на финскоязычных текстах. Это модель с архитектурой BERT для заполнения пропусков в тексте; её также можно дообучать для задач обработки финского языка, включая классификацию документов, распознавание именованных сущностей и разметку частей речи.

Модель содержит 151,7 млн параметров, использует словарь из 50 000 WordPiece-токенов с улучшенным покрытием финских слов и поддерживает контекст до 512 токенов. Предобучение включало 1 млн шагов на корпусе более чем из 3 млрд токенов: новостях, интернет-обсуждениях и данных веб-сборов. Доступны веса в форматах PyTorch, TensorFlow, JAX/Flax и Safetensors.

Карточка сообщает о результатах выше multilingual BERT в ряде финских задач, включая классификацию документов, NER и разметку частей речи. Для этих задач требуется дообучение на соответствующих данных; модель ориентирована на финский язык и не предназначена для генерации свободного текста. Лицензия в предоставленных данных не указана.

Сценарии применения

  • предсказание пропущенных слов в финском тексте
  • классификация финских новостных статей
  • классификация сообщений на финском языке
  • распознавание имен и организаций в финских документах
  • разметка частей речи в финских текстах

Ограничения

Модель рассчитана прежде всего на финский язык; для классификации, распознавания сущностей и разметки частей речи её необходимо дообучить на размеченных данных. Контекст ограничен 512 токенами.

Для каких профессий подходит5

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Quickstart

Release 1.0 (November 25, 2019)

We generally recommend the use of the cased model.

Paper presenting Finnish BERT: arXiv:1912.07076

What's this?

A version of Google's BERT deep transfer learning model for Finnish. The model can be fine-tuned to achieve state-of-the-art results for various Finnish natural language processing tasks.

FinBERT features a custom 50,000 wordpiece vocabulary that has much better coverage of Finnish words than e.g. the previously released multilingual BERT models from Google:

VocabularyExample
FinBERTSuomessa vaihtuu kesän aikana sekä pääministeri että valtiovarain ##ministeri .
Multilingual BERTSuomessa vai ##htuu kes ##än aikana sekä p ##ää ##minister ##i että valt ##io ##vara ##in ##minister ##i .

FinBERT has been pre-trained for 1 million steps on over 3 billion tokens (24B characters) of Finnish text drawn from news, online discussion, and internet crawls. By contrast, Multilingual BERT was trained on Wikipedia texts, where the Finnish Wikipedia text is approximately 3% of the amount used to train FinBERT.

These features allow FinBERT to outperform not only Multilingual BERT but also all previously proposed models when fine-tuned for Finnish natural language processing tasks.

Results

Document classification
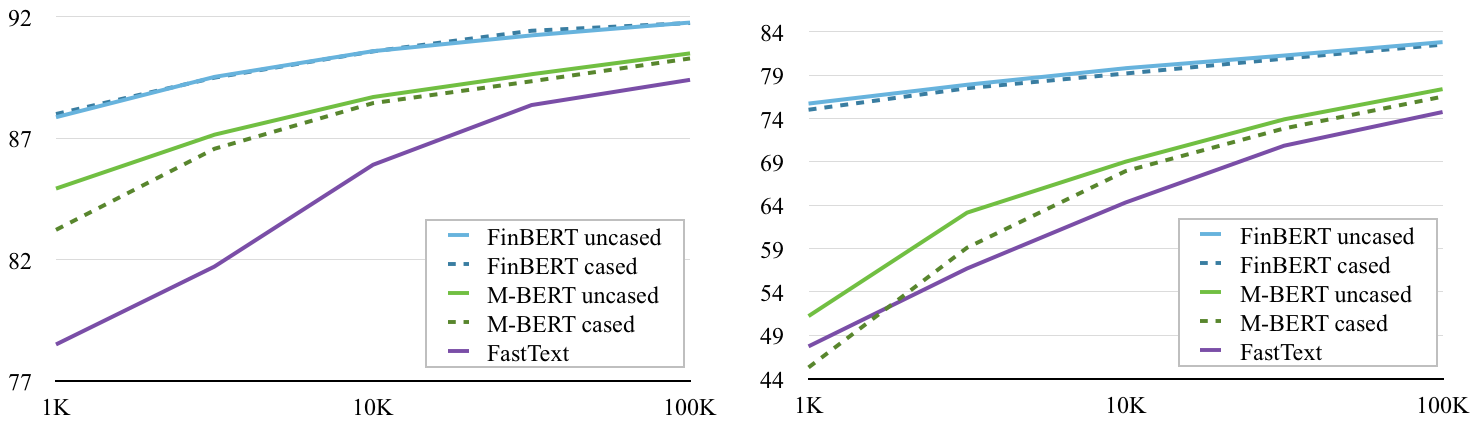
learning curves for Yle and Ylilauta document classification

FinBERT outperforms multilingual BERT (M-BERT) on document classification over a range of training set sizes on the Yle news (left) and Ylilauta online discussion (right) corpora. (Baseline classification performance with FastText included for reference.)

[code][Yle data] [Ylilauta data]

Named Entity Recognition

Evaluation on FiNER corpus (Ruokolainen et al 2019)

ModelAccuracy
FinBERT92.40%
Multilingual BERT90.29%
FiNER-tagger (rule-based)86.82%

(FiNER tagger results from Ruokolainen et al. 2019)

[code][data]

Part of speech tagging

Evaluation on three Finnish corpora annotated with Universal Dependencies part-of-speech tags: the Turku Dependency Treebank (TDT), FinnTreeBank (FTB), and Parallel UD treebank (PUD)

ModelTDTFTBPUD
FinBERT98.23%98.39%98.08%
Multilingual BERT96.97%95.87%97.58%

[code][data]

Previous releases

Release 0.2

October 24, 2019 Beta version of the BERT base uncased model trained from scratch on a corpus of Finnish news, online discussions, and crawled data.

Download the model here: bert-base-finnish-uncased.zip

Release 0.1

September 30, 2019 We release a beta version of the BERT base cased model trained from scratch on a corpus of Finnish news, online discussions, and crawled data.

Download the model here: bert-base-finnish-cased.zip

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · fill-mask

Можно запустить

Подбираем GPU…

Класс архитектуры
BertForMaskedLM
Ревизия весов
87b4eaa

0 моделей