Quickstart
Release 1.0 (November 25, 2019)
Download the models here:
- Cased Finnish BERT Base: bert-base-finnish-cased-v1.zip
- Uncased Finnish BERT Base: bert-base-finnish-uncased-v1.zip
We generally recommend the use of the cased model.
Paper presenting Finnish BERT: arXiv:1912.07076
What's this?
A version of Google's BERT deep transfer learning model for Finnish. The model can be fine-tuned to achieve state-of-the-art results for various Finnish natural language processing tasks.
FinBERT features a custom 50,000 wordpiece vocabulary that has much better coverage of Finnish words than e.g. the previously released multilingual BERT models from Google:
| Vocabulary | Example |
|---|---|
| FinBERT | Suomessa vaihtuu kesän aikana sekä pääministeri että valtiovarain ##ministeri . |
| Multilingual BERT | Suomessa vai ##htuu kes ##än aikana sekä p ##ää ##minister ##i että valt ##io ##vara ##in ##minister ##i . |
FinBERT has been pre-trained for 1 million steps on over 3 billion tokens (24B characters) of Finnish text drawn from news, online discussion, and internet crawls. By contrast, Multilingual BERT was trained on Wikipedia texts, where the Finnish Wikipedia text is approximately 3% of the amount used to train FinBERT.
These features allow FinBERT to outperform not only Multilingual BERT but also all previously proposed models when fine-tuned for Finnish natural language processing tasks.
Results
Document classification
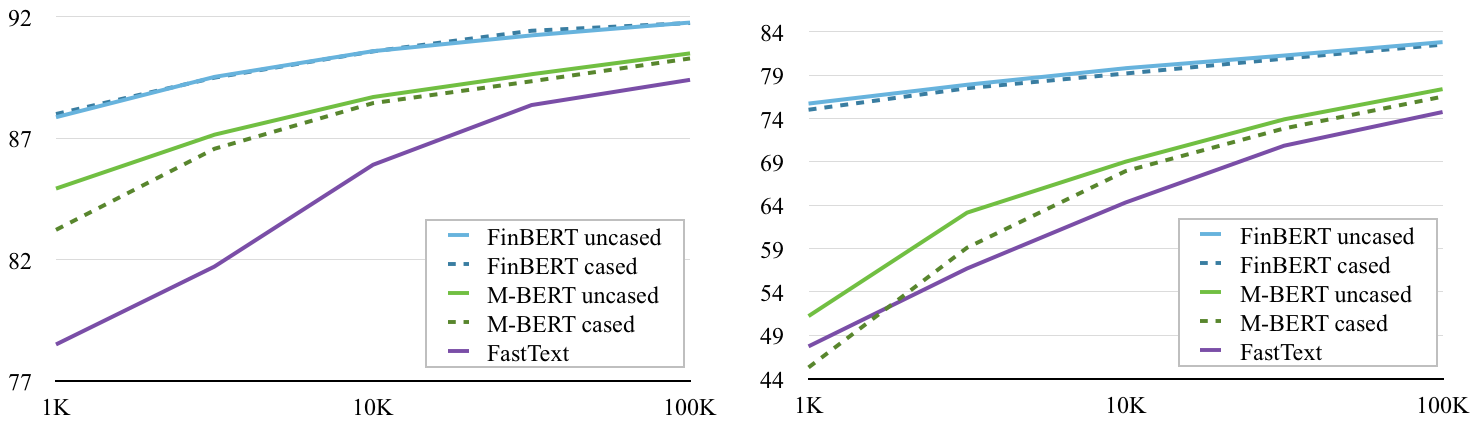
FinBERT outperforms multilingual BERT (M-BERT) on document classification over a range of training set sizes on the Yle news (left) and Ylilauta online discussion (right) corpora. (Baseline classification performance with FastText included for reference.)
[code][Yle data] [Ylilauta data]
Named Entity Recognition
Evaluation on FiNER corpus (Ruokolainen et al 2019)
| Model | Accuracy |
|---|---|
| FinBERT | 92.40% |
| Multilingual BERT | 90.29% |
| FiNER-tagger (rule-based) | 86.82% |
(FiNER tagger results from Ruokolainen et al. 2019)
Part of speech tagging
Evaluation on three Finnish corpora annotated with Universal Dependencies part-of-speech tags: the Turku Dependency Treebank (TDT), FinnTreeBank (FTB), and Parallel UD treebank (PUD)
| Model | TDT | FTB | PUD |
|---|---|---|---|
| FinBERT | 98.23% | 98.39% | 98.08% |
| Multilingual BERT | 96.97% | 95.87% | 97.58% |
Use with PyTorch
If you want to use the model with the huggingface/transformers library, follow the steps in huggingface_transformers.md
Previous releases
Release 0.2
October 24, 2019 Beta version of the BERT base uncased model trained from scratch on a corpus of Finnish news, online discussions, and crawled data.
Download the model here: bert-base-finnish-uncased.zip
Release 0.1
September 30, 2019 We release a beta version of the BERT base cased model trained from scratch on a corpus of Finnish news, online discussions, and crawled data.
Download the model here: bert-base-finnish-cased.zip