Qwen3.6-27B-TQ3_4S

TQ3_4S Release
This repository packages the model as a TurboQuant TQ3_4S GGUF for local deployment.
Runtime Compatibility
This quant requires a TurboQuant-capable runtime. For llama.cpp, use the turbo-tan/llama.cpp-tq3 fork rather than stock upstream llama.cpp if you want native TQ3_4S support.
- TurboQuant runtime fork: turbo-tan/llama.cpp-tq3
- LM Studio setup: docs/backend/LMStudio.md
Files
| File | Quant | Size |
|---|---|---|
Qwen3.6-27B-TQ3_4S.gguf | TQ3_4S | ~13.0 GB |
chat_template.jinja | chat template | text |
thumbnail.png | model card image | png |
Local Validation
Hardware:
- RTX 5060 Ti 16 GB
Prompt processing:
llama-perplexity --chunks 10 -c 2048PPL = 6.2452 +/- 0.16138prompt eval = 712.02 tok/s
16 GB VRAM fit checks on RTX 5060 Ti with the recommended KV settings:
32kcontext fits64kcontext fits128kcontext does not fit
Runtime Notes
- Use a TurboQuant-capable llama.cpp build for best performance.
- For llama.cpp, the intended runtime is the
turbo-tan/llama.cpp-tq3fork. - The upstream family is multimodal-capable, but the public 27B repos used here do not currently expose a separate GGUF
mmprojartifact. - For llama.cpp chat usage, keep
--jinjaenabled so the bundled chat template is honored. - Upstream guidance recommends keeping at least
128Kcontext when possible for reasoning-heavy workloads. On smaller local GPUs, reduce context as needed to fit memory. - Upstream default sampling guidance differs between thinking and non-thinking mode; follow the official Qwen card if you are trying to reproduce base-model behavior.
Recommended llama.cpp Settings
Default prompt-processing settings on 16 GB:
llama-bench \
  -m Qwen3.6-27B-TQ3_4S.gguf \
  -ngl 99 \
  -ctk q4_0 \
  -ctv tq3_0 \
  -fa 1 \
  -p 2048 -n 0 -r 3
Default chat/server settings:
llama-server \
  -m Qwen3.6-27B-TQ3_4S.gguf \
  --host 127.0.0.1 --port 8080 \
  -ngl 99 -c 4096 -np 1 \
  -ctk q4_0 -ctv tq3_0 -fa on \
  --jinja
Example
llama-cli \
  -m Qwen3.6-27B-TQ3_4S.gguf \
  --jinja \
  -ngl 99 \
  -c 4096
Build/runtime:
git clone https://github.com/turbo-tan/llama.cpp-tq3
Qwen3.6 Base Model
[!Note] The upstream Qwen repository contains model weights and configuration files for the post-trained model in the Hugging Face Transformers format.
Those upstream artifacts are compatible with Hugging Face Transformers, vLLM, SGLang, KTransformers, and related runtimes.
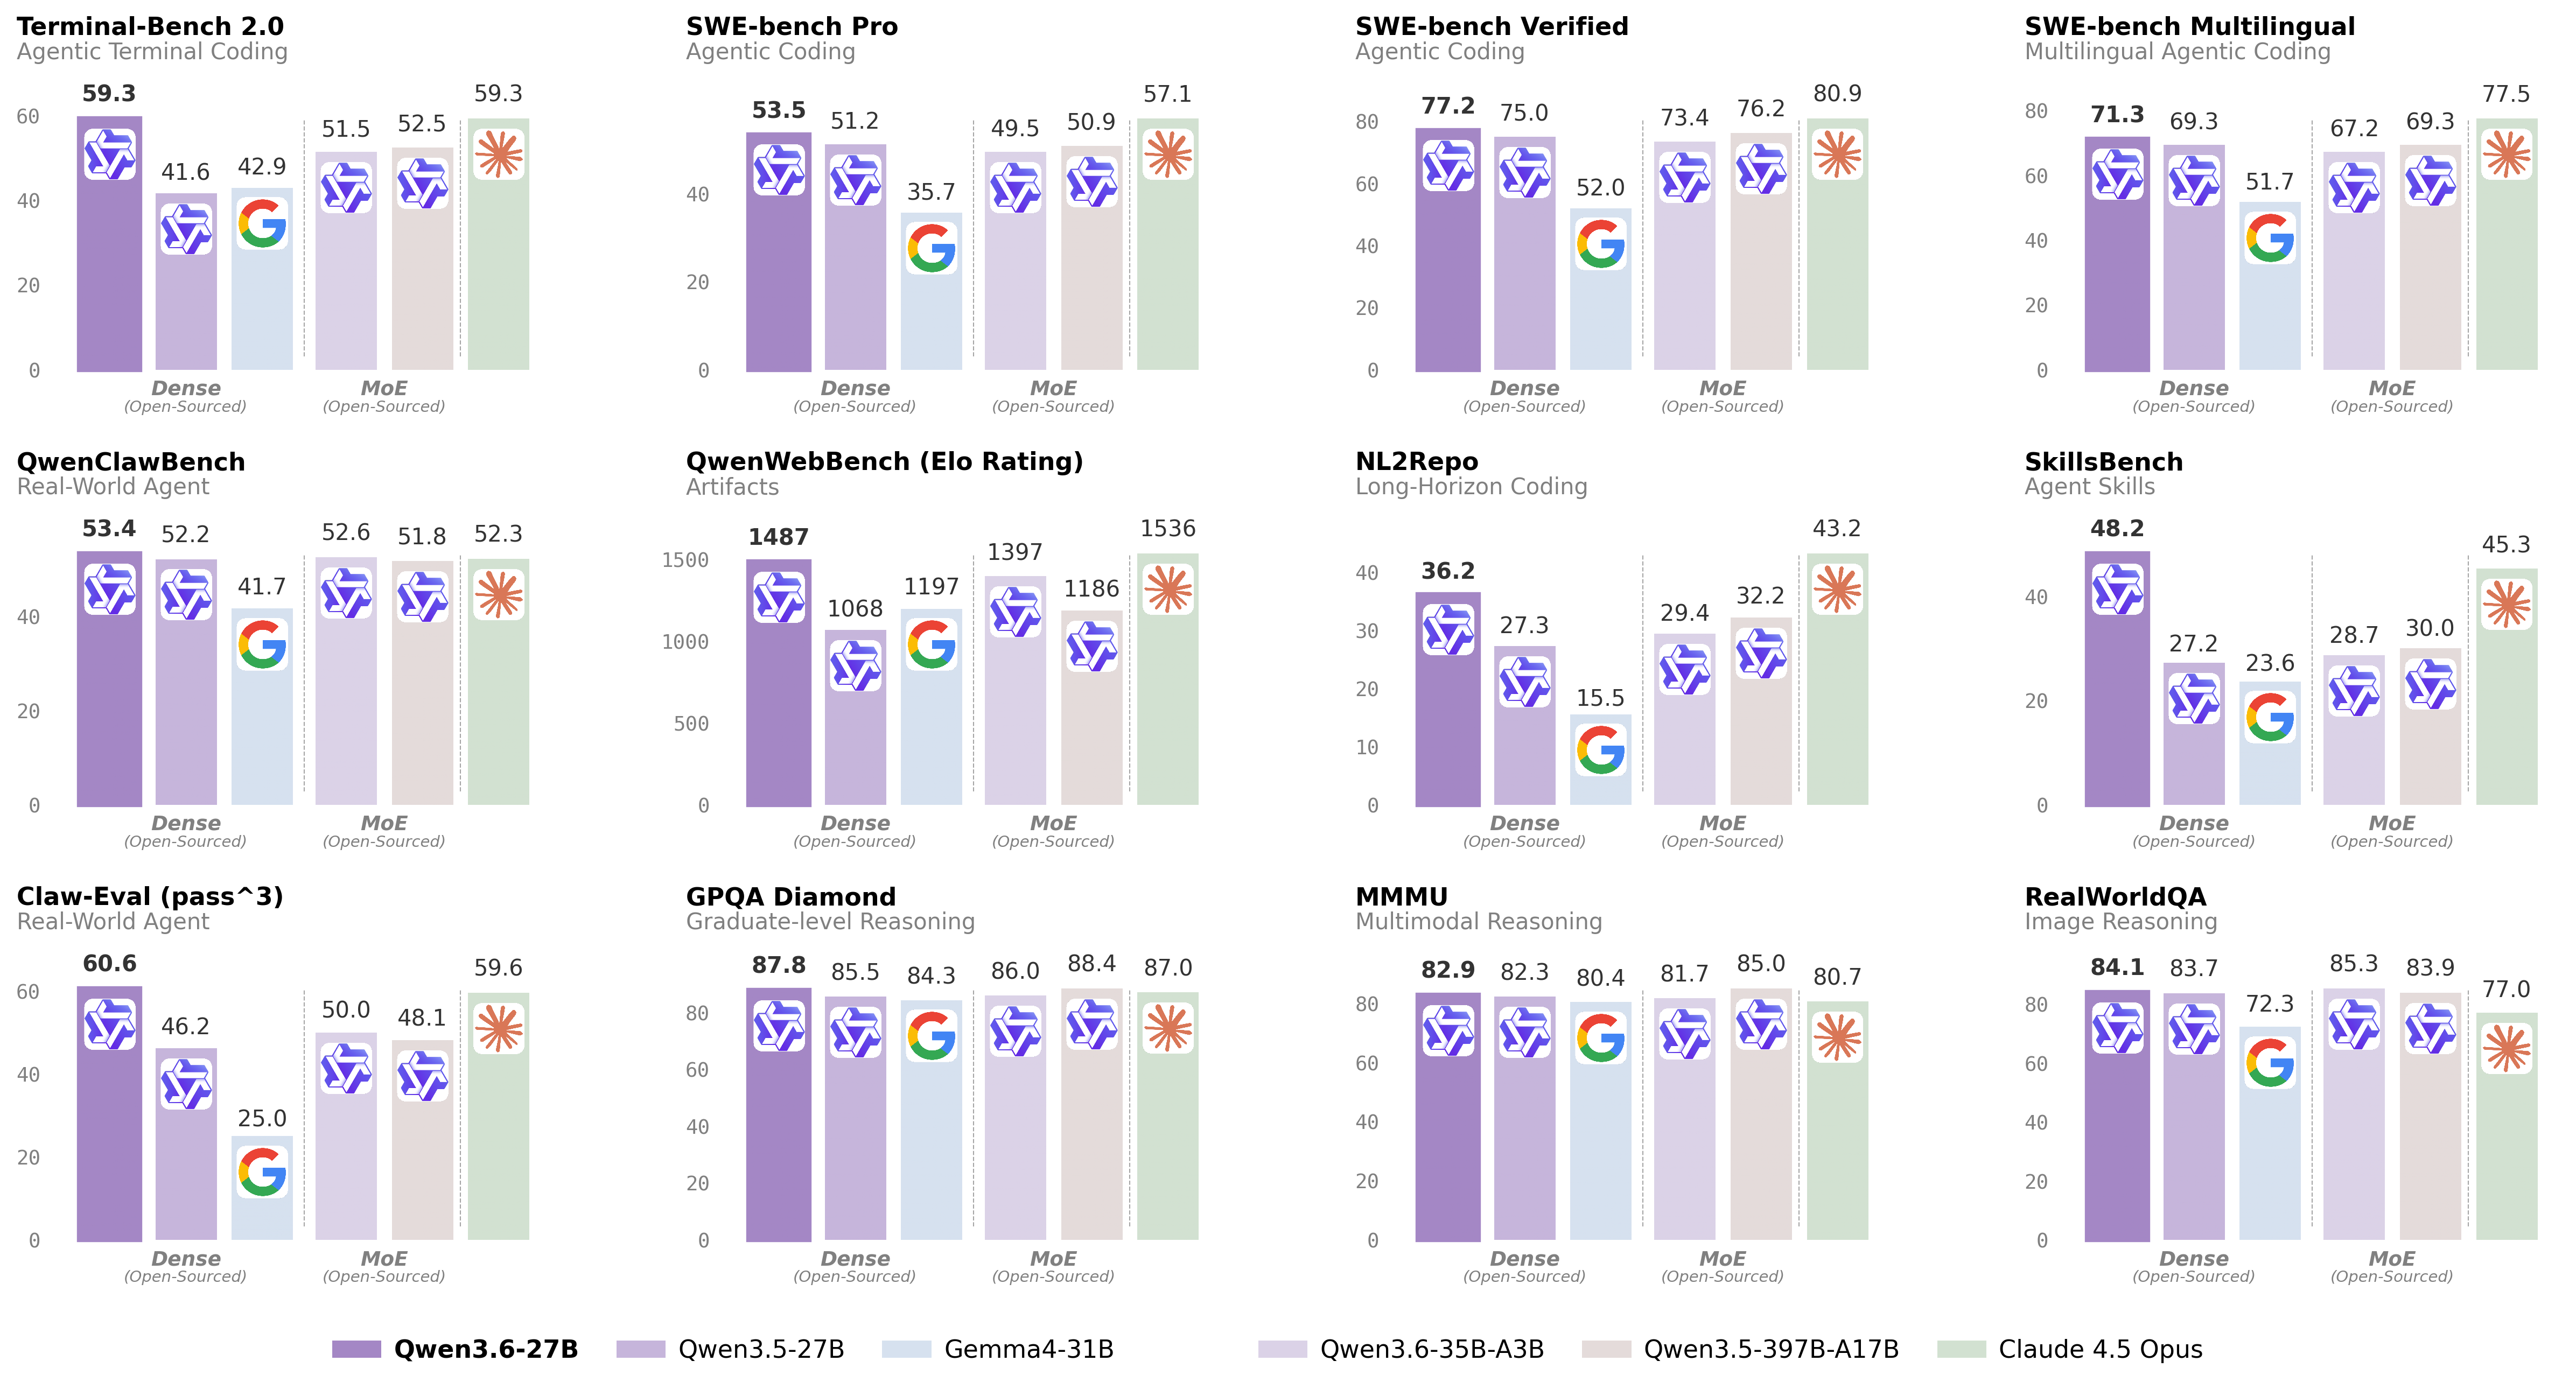
Following the February release of the Qwen3.5 series, Qwen describes Qwen3.6 as the first open-weight Qwen3.6 variant, built for stronger stability and real-world utility.
Qwen3.6 Highlights
- Agentic Coding: the model handles frontend workflows and repository-level reasoning with greater fluency and precision.
- Thinking Preservation: the model family retains reasoning context across historical turns to reduce overhead during iterative work.
Model Overview
- Type: Causal Language Model with Vision Encoder
- Training Stage: Pre-training and Post-training
- Architecture:
qwen35 - Parameters:
27B - Layers:
64 - Embedding dimension:
5120 - FFN dimension:
17408 - Hidden layout:
16 × (3 × (Gated DeltaNet -> FFN) -> 1 × (Gated Attention -> FFN)) - Gated DeltaNet heads:
48forV,16forQK, head dim128 - Gated Attention heads:
24forQ,4forKV, head dim256 - RoPE dim:
64 - Native context:
262,144
Selected Upstream Benchmark Highlights
SWE-bench Verified:77.2Terminal-Bench 2.0:59.3SkillsBench Avg5:48.2GPQA Diamond:87.8AIME26:94.1MMMU:82.9AndroidWorld:70.3
Sources
- Upstream base model: Qwen/Qwen3.6-27B
- Upstream GGUF source used for conversion: unsloth/Qwen3.6-27B-GGUF
- Upstream blog and benchmark context: Qwen3.6-27B model card
- TurboQuant runtime fork: turbo-tan/llama.cpp-tq3