/ Модель

Характеристики

Контекст
2 048 токенов
Лицензия
Apache 2.0
Архитектура
gpt2 · dense
Опубликована
31 авг 2022

mGPT-armenian

Генерация текстаТекст → текст3 профессии

Дообученная на армянских текстах авторегрессионная модель mGPT для генерации и продолжения армянского текста.

168скачиваний за 30 дней8лайковвеса обновлены31 авг 2022

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

ai-forever/mGPT-armenian — авторегрессионная языковая модель семейства mGPT, разработанная AI Forever и дообученная для генерации текста на армянском языке. В основе — mGPT с архитектурой GPT-3, реализованной на базе GPT-2; базовая семья mGPT насчитывает 1,3 млрд параметров и предварительно обучалась на 60 языках. Для этой версии использовали около 170 ГБ армянских текстов из MC4, Archive.org, EANC, OpenSubtitles, OSCAR и блогов.

Модель предназначена для продолжения и генерации армянского текста, а также может применяться в языковых экспериментах и сценариях с малоресурсным армянским. Контекст составляет 2048 токенов. Обучение базовой модели использовало разреженное внимание, а на последних этапах дообучения разреженность отключили для совместимости с классом GPT-2 в Transformers.

Модель подходит для исследовательских и прикладных прототипов генерации текста. В README приведено значение perplexity 2,046 на валидации, но сравнительные условия оценки не описаны. Лицензия репозитория — Apache-2.0.

Сценарии применения

  • генерация текста на армянском языке
  • продолжение армянских текстов
  • создание черновиков и фрагментов на армянском
  • эксперименты с языковыми моделями для армянского языка

Ограничения

Контекст ограничен 2048 токенами; опубликованная perplexity приведена без подробностей о методике оценки. Модель специализирована на армянском языке, поэтому качество для других языков не установлено.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Multilingual GPT model, Armenian language finetune

We introduce a monolingual GPT-3-based model for Armenian language

The model is based on mGPT, a family of autoregressive GPT-like models with 1.3 billion parameters trained on 60 languages from 25 language families using Wikipedia and Colossal Clean Crawled Corpus.

We reproduce the GPT-3 architecture using GPT-2 sources and the sparse attention mechanism, Deepspeed and Megatron frameworks allows us to effectively parallelize the training and inference steps. The resulting models show performance on par with the recently released XGLM models at the same time covering more languages and enhancing NLP possibilities for low resource languages.

Code

The source code for the mGPT XL model is available on Github

Paper

mGPT: Few-Shot Learners Go Multilingual
Abstract PDF

@misc{https://doi.org/10.48550/arxiv.2204.07580,
 doi = {10.48550/ARXIV.2204.07580},
 url = {https://arxiv.org/abs/2204.07580},
 author = {Shliazhko, Oleh and Fenogenova, Alena and Tikhonova, Maria and Mikhailov, Vladislav and Kozlova, Anastasia and Shavrina, Tatiana},
 keywords = {Computation and Language (cs.CL), Artificial Intelligence (cs.AI), FOS: Computer and information sciences, FOS: Computer and information sciences, I.2; I.2.7, 68-06, 68-04, 68T50, 68T01},
 title = {mGPT: Few-Shot Learners Go Multilingual},
 publisher = {arXiv},
 year = {2022},
 copyright = {Creative Commons Attribution 4.0 International}
}

Training

The model was fine-tuned on 170GB of Armenian texts, including MC4, Archive.org fiction, EANC public data, OpenSubtitles, OSCAR corpus and blog texts.

Val perplexity is 2.046.

The mGPT model was pre-trained for 12 days x 256 GPU (Tesla NVidia V100), 4 epochs, then 9 days x 64 GPU, 1 epoch

The Armenian finetune was around 7 days with 4 Tesla NVidia V100 and has made 160k steps.
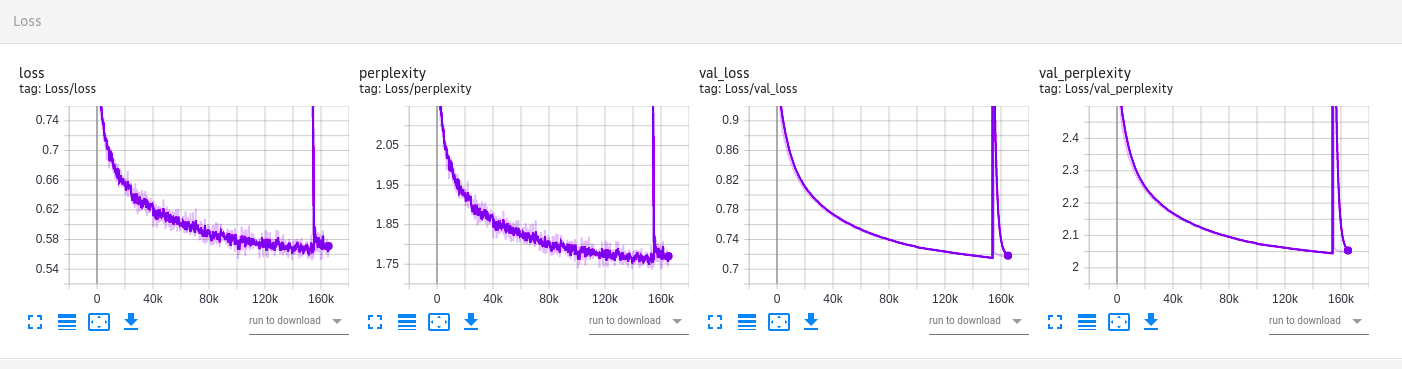
What happens on this image? The model is originally trained with sparse attention masks, then fine-tuned with no sparsity on the last steps (perplexity and loss peak). Getting rid of the sparsity in the end of the training helps to integrate the model into the GPT2 HF class.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
GPT2LMHeadModel
Ревизия весов
9dd04b6

0 моделей