/ Модель

Характеристики

Контекст
2 048 токенов
Размер весов
52,5 ГБ
Лицензия
MIT
Архитектура
gpt2 · dense
Опубликована
2 мая 2023

ruGPT-3.5-13B

Генерация текстаТекст → текст6 профессий

Русскоязычная модель GPT-2 с 13 млрд параметров для генерации текста, кода и юридических документов.

749скачиваний за 30 дней297лайковвеса обновлены5 дек 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

ruGPT-3.5 13B — русскоязычная языковая модель авторства AI-Forever на архитектуре GPT-2 с 13 млрд параметров. Она обучена генерировать продолжение текста и предназначена для создания текстов на русском языке.

Модель предварительно обучена на корпусе из разных областей объёмом около 300 ГБ, а затем дообучена на дополнительных 100 ГБ кода и юридических документов. В README указано обучение примерно на 300 млрд токенов и контекст длиной 2048 токенов. Авторы сообщают, что модель использовалась при обучении GigaChat.

Модель может применяться для генерации текстов, кода и юридических документов на русском языке. Карточка предлагает экспериментировать со стратегиями генерации; в ней не приведены оценки качества по отдельным задачам. Лицензия — MIT.

Сценарии применения

  • продолжение текста на русском языке
  • создание черновиков русскоязычных документов
  • генерация фрагментов кода
  • составление текстов на юридическую тематику
  • генерация стихотворений и творческих текстов

Ограничения

Качество по отдельным задачам в карточке не оценено; авторы рекомендуют подбирать стратегию генерации. Контекст ограничен 2048 токенами.

Для каких профессий подходит6

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

🗿 ruGPT-3.5 13B

Language model for Russian. Model has 13B parameters as you can guess from it's name. This is our biggest model so far and it was used for trainig GigaChat (read more about it in the article).

Dataset

Model was pretrained on a 300Gb of various domains, than additionaly trained on the 100 Gb of code and legal documets. Here is the dataset structure:
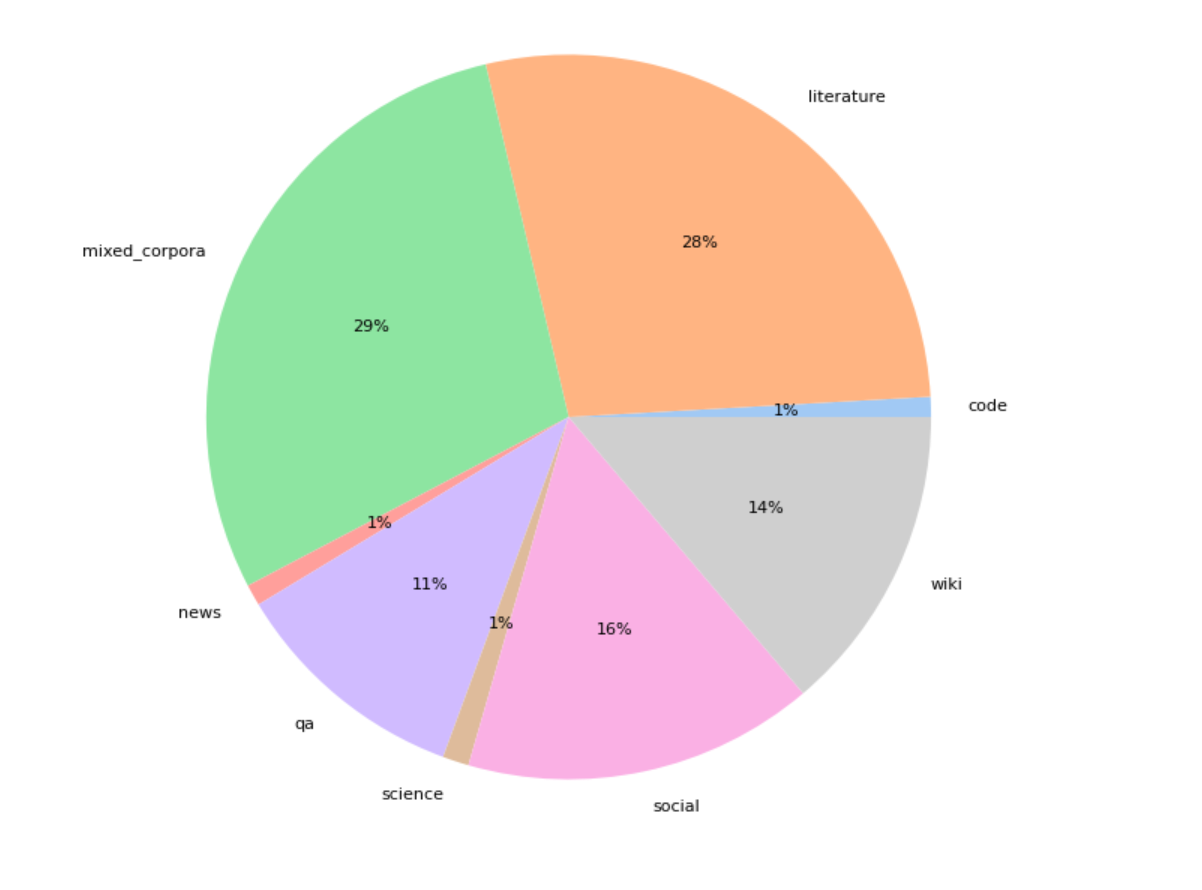
Training data was deduplicated, the text deduplication includes 64-bit hashing of each text in the corpus for keeping texts with a unique hash. We also filter the documents based on their text compression rate using zlib4. The most strongly and weakly compressing deduplicated texts are discarded.

Technical details

Model was trained using Deepspeed and Megatron libraries, on 300B tokens dataset for 3 epochs, around 45 days on 512 V100. After that model was finetuned 1 epoch with sequence length 2048 around 20 days on 200 GPU A100 on additional data (see above).

After the final training perplexity for this model was around 8.8 for Russian.

Examples of usage

Try different generation strategies to reach better results.

request = "Стих про программиста может быть таким:"

encoded_input = tokenizer(request, return_tensors='pt', \
                          add_special_tokens=False).to('cuda:0')
output = model.generate(
    **encoded_input,
    num_beams=2,
    do_sample=True,
    max_new_tokens=100
)

print(tokenizer.decode(output[0], skip_special_tokens=True))
>>> Стих про программиста может быть таким:

    Программист сидит в кресле,
    Стих сочиняет он про любовь,
    Он пишет, пишет, пишет, пишет...
    И не выходит ни черта!
request = "Нейронная сеть — это"

encoded_input = tokenizer(request, return_tensors='pt', \
                          add_special_tokens=False).to('cuda:0')
output = model.generate(
    **encoded_input,
    num_beams=4,
    do_sample=True,
    max_new_tokens=100
)

print(tokenizer.decode(output[0], skip_special_tokens=True))
>>> Нейронная сеть — это математическая модель, состоящая из большого
    количества нейронов, соединенных между собой электрическими связями.
    Нейронная сеть может быть смоделирована на компьютере, и с ее помощью
    можно решать задачи, которые не поддаются решению с помощью традиционных
    математических методов.
request = "Гагарин полетел в космос в"

encoded_input = tokenizer(request, return_tensors='pt', \
                          add_special_tokens=False).to('cuda:0')
output = model.generate(
    **encoded_input,
    num_beams=2,
    do_sample=True,
    max_new_tokens=100
)

print(tokenizer.decode(output[0], skip_special_tokens=True))
>>> Гагарин полетел в космос в 1961 году. Это было первое в истории
    человечества космическое путешествие. Юрий Гагарин совершил его
    на космическом корабле Восток-1. Корабль был запущен с космодрома
    Байконур.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
GPT2LMHeadModel
Ревизия весов
64b1153

0 моделей