gelectra-large for Extractive QA
Overview
Language model: gelectra-large-germanquad
Language: German
Training data: GermanQuAD train set (~ 12MB)
Eval data: GermanQuAD test set (~ 5MB)
Code: See an example extractive QA pipeline built with Haystack
Infrastructure: 1x V100 GPU
Published: Apr 21st, 2021
Details
- We trained a German question answering model with a gelectra-large model as its basis.
- The dataset is GermanQuAD, a new, German language dataset, which we hand-annotated and published online.
- The training dataset is one-way annotated and contains 11518 questions and 11518 answers, while the test dataset is three-way annotated so that there are 2204 questions and with 2204·3−76 = 6536 answers, because we removed 76 wrong answers.
See https://deepset.ai/germanquad for more details and dataset download in SQuAD format.
Hyperparameters
batch_size = 24
n_epochs = 2
max_seq_len = 384
learning_rate = 3e-5
lr_schedule = LinearWarmup
embeds_dropout_prob = 0.1
Usage
In Haystack
Haystack is an AI orchestration framework to build customizable, production-ready LLM applications. You can use this model in Haystack to do extractive question answering on documents. To load and run the model with Haystack:
# After running pip install haystack-ai "transformers[torch,sentencepiece]"

from haystack import Document
from haystack.components.readers import ExtractiveReader

docs = [
    Document(content="Python is a popular programming language"),
    Document(content="python ist eine beliebte Programmiersprache"),
]

reader = ExtractiveReader(model="deepset/gelectra-large-germanquad")
reader.warm_up()

question = "What is a popular programming language?"
result = reader.run(query=question, documents=docs)
# {'answers': [ExtractedAnswer(query='What is a popular programming language?', score=0.5740374326705933, data='python', document=Document(id=..., content: '...'), context=None, document_offset=ExtractedAnswer.Span(start=0, end=6),...)]}
For a complete example with an extractive question answering pipeline that scales over many documents, check out the corresponding Haystack tutorial.
In Transformers
from transformers import AutoModelForQuestionAnswering, AutoTokenizer, pipeline

model_name = "deepset/gelectra-large-germanquad"

# a) Get predictions
nlp = pipeline('question-answering', model=model_name, tokenizer=model_name)
QA_input = {
    'question': 'Why is model conversion important?',
    'context': 'The option to convert models between FARM and transformers gives freedom to the user and let people easily switch between frameworks.'
}
res = nlp(QA_input)

# b) Load model & tokenizer
model = AutoModelForQuestionAnswering.from_pretrained(model_name)
tokenizer = AutoTokenizer.from_pretrained(model_name)
Performance
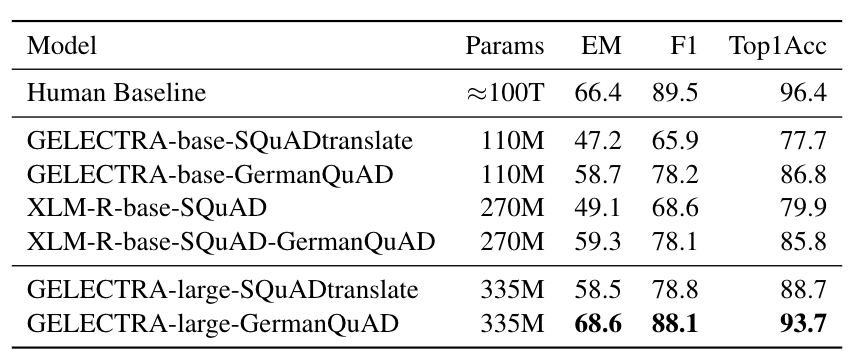
We evaluated the extractive question answering performance on our GermanQuAD test set.
Model types and training data are included in the model name.
For finetuning XLM-Roberta, we use the English SQuAD v2.0 dataset.
The GELECTRA models are warm started on the German translation of SQuAD v1.1 and finetuned on GermanQuAD.
The human baseline was computed for the 3-way test set by taking one answer as prediction and the other two as ground truth.
Authors
Timo Möller: timo.moeller@deepset.ai
Julian Risch: julian.risch@deepset.ai
Malte Pietsch: malte.pietsch@deepset.ai
About us
deepset is the company behind the production-ready open-source AI framework Haystack.
Some of our other work:
- Distilled roberta-base-squad2 (aka "tinyroberta-squad2")
- German BERT, GermanQuAD and GermanDPR, German embedding model
- deepset Cloud, deepset Studio
Get in touch and join the Haystack community
We also have a Discord community open to everyone!
Twitter | LinkedIn | Discord | GitHub Discussions | Website | YouTube
By the way: we're hiring!