/ Модель

Характеристики

Лицензия
OpenRAIL++
Базовая модель
stable-diffusion-xl-base-1.0
Опубликована
23 авг 2023

sdxl-instructpix2pix-768

Генерация изображенийТекст → изображение3 профессии

Модель на основе SDXL, которая редактирует изображения по текстовым инструкциям.

4 042скачиваний за 30 дней56лайковвеса обновлены30 авг 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Изображения» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели сгенерируют результат по каждой задаче. Опубликованный тест появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

SDXL InstructPix2Pix — модель редактирования изображений по текстовым инструкциям, созданная на основе Stable Diffusion XL с помощью дообучения по методике InstructPix2Pix. Она предназначена для преобразования загруженного изображения по запросу: например, изменения погоды, художественного стиля или возраста человека. Обучение выполнено на разрешении 768×768 в течение 15 000 шагов на наборе timbrooks/instructpix2pix-clip-filtered.

Модель распространяется в формате Diffusers и Safetensors и использует базовую модель stabilityai/stable-diffusion-xl-base-1.0. Для работы требуются изображение и текстовая инструкция; результатом служит отредактированное изображение. Лицензия — OpenRAIL++.

Сценарии применения

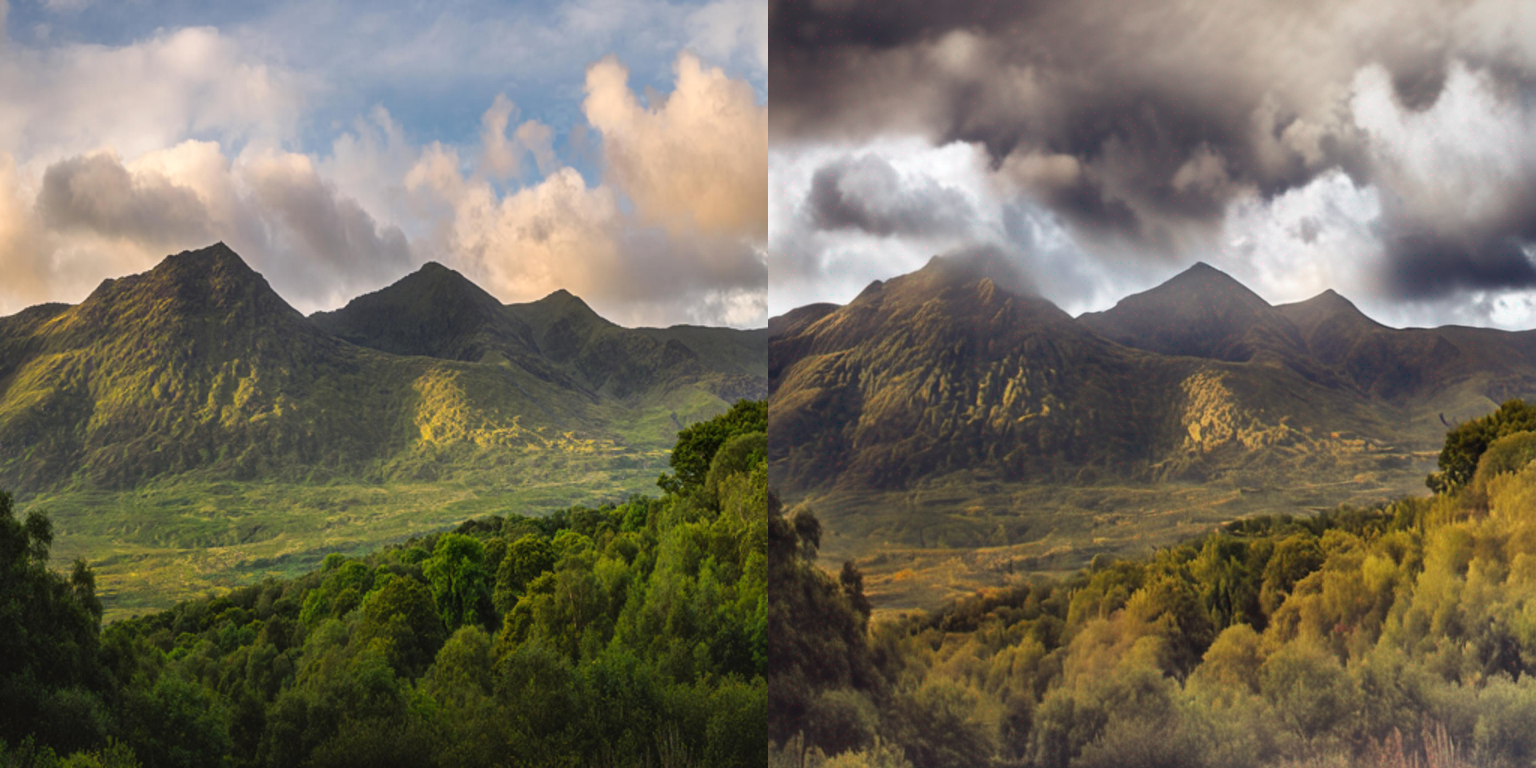
  • Изменение погоды или неба на фотографии по запросу
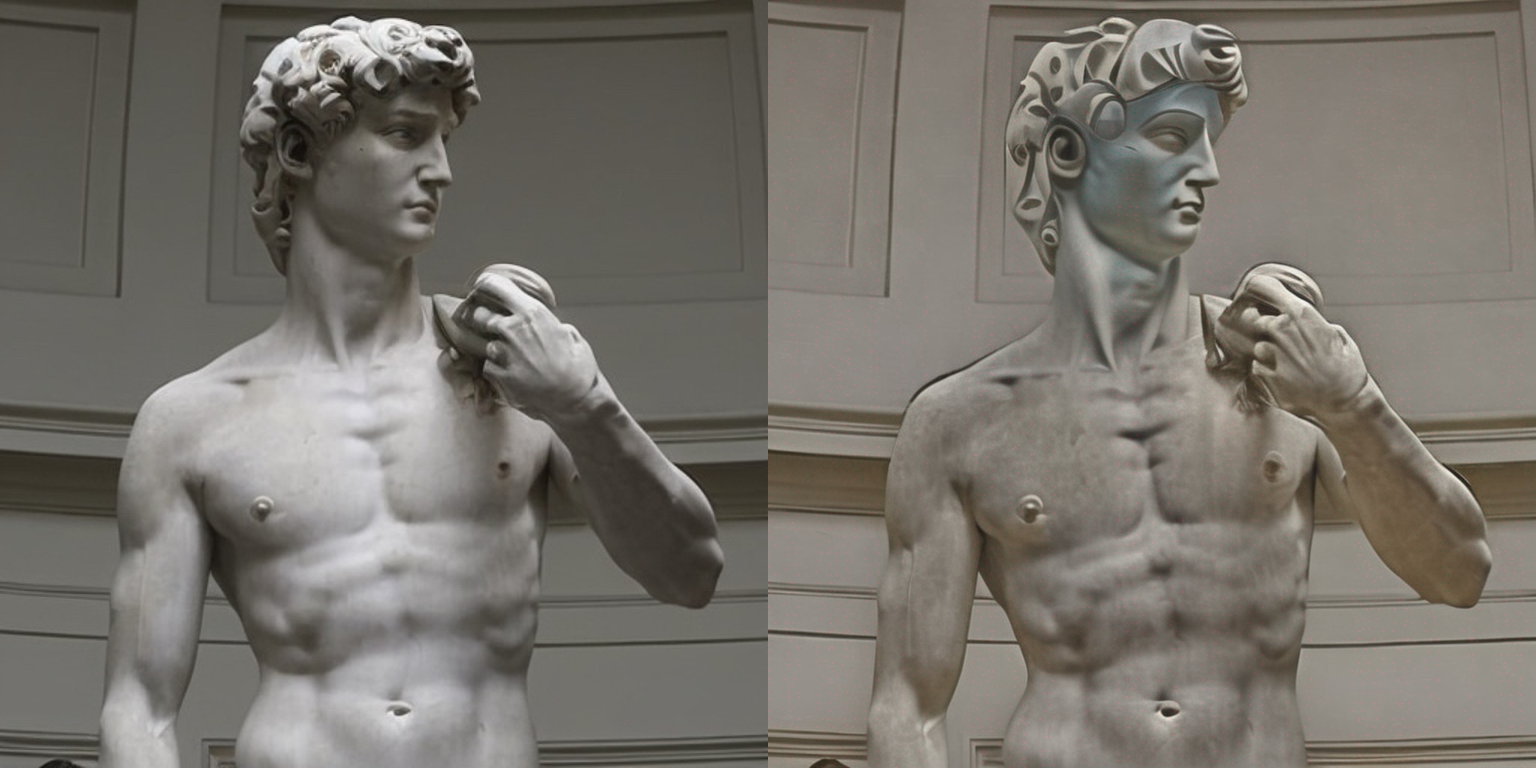
  • Преобразование изображения в заданный художественный стиль
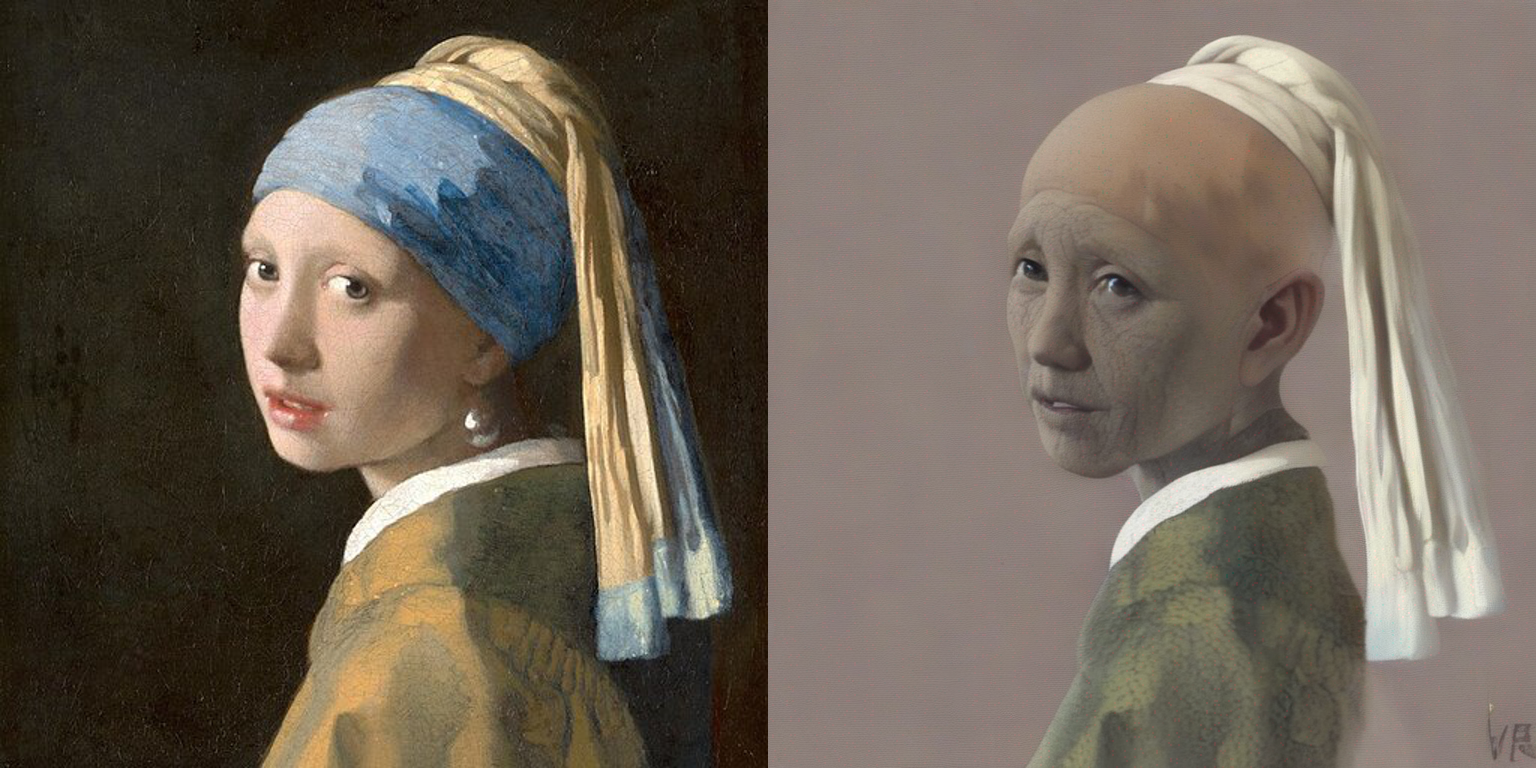
  • Изменение видимого возраста персонажа на изображении

Ограничения

Модель обучалась на разрешении 768×768; качество результатов может зависеть от формулировки инструкции и содержания исходного изображения.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

SDXL InstructPix2Pix (768768)

Instruction fine-tuning of Stable Diffusion XL (SDXL) à la InstructPix2Pix. Some results below:

Edit instruction: "Turn sky into a cloudy one"
Edit instruction: "Make it a picasso painting"
Edit instruction: "make the person older"
Usage in 🧨 diffusers

Make sure to install the libraries first:

pip install accelerate transformers
pip install git+https://github.com/huggingface/diffusers
import torch
from diffusers import StableDiffusionXLInstructPix2PixPipeline
from diffusers.utils import load_image

resolution = 768
image = load_image(
    "https://hf.co/datasets/diffusers/diffusers-images-docs/resolve/main/mountain.png"
).resize((resolution, resolution))
edit_instruction = "Turn sky into a cloudy one"

pipe = StableDiffusionXLInstructPix2PixPipeline.from_pretrained(
    "diffusers/sdxl-instructpix2pix-768", torch_dtype=torch.float16
).to("cuda")

edited_image = pipe(
    prompt=edit_instruction,
    image=image,
    height=resolution,
    width=resolution,
    guidance_scale=3.0,
    image_guidance_scale=1.5,
    num_inference_steps=30,
).images[0]
edited_image.save("edited_image.png")

To know more, refer to the documentation.

🚨 Note that this checkpoint is experimental in nature and there's a lot of room for improvements. Please use the "Discussions" tab of this repository to open issues and discuss. 🚨

Training

We fine-tuned SDXL using the InstructPix2Pix training methodology for 15000 steps using a fixed learning rate of 5e-6 on an image resolution of 768x768.

Our training scripts and other utilities can be found here and they were built on top of our official training script.

Our training logs are available on Weights and Biases here. Refer to this link for details on all the hyperparameters.

Training data

We used this dataset: timbrooks/instructpix2pix-clip-filtered.

Compute

one 8xA100 machine

Batch size

Data parallel with a single gpu batch size of 8 for a total batch size of 32.

Mixed precision

FP16

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Ревизия весов
06653d4

0 моделей