/ Модель

Характеристики

Опубликована
19 дек 2022

dreambooth-avatar

Генерация изображенийТекст → изображение3 профессии

Дообученная Stable Diffusion v1.5 генерирует изображения в стиле мультфильма «Аватар» по текстовым запросам.

22скачиваний за 30 дней48лайковвеса обновлены20 дек 2022

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Изображения» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели сгенерируют результат по каждой задаче. Опубликованный тест появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Модель lambda/dreambooth-avatar разработана Eole Cervenka в Lambda Labs: это Stable Diffusion v1.5, дообученная методом DreamBooth на изображениях в стиле мультфильма «Аватар». Она принимает текстовый запрос и генерирует изображения; для воспроизведения стиля в запросе используется токен «avatarart style». Обучение проводилось на 60 изображениях персонажей «Аватара» размером 512×512 пикселей с сохранением класса Person для снижения влияния дообучения на обычные изображения людей. Модель предназначена для создания иллюстраций в этом стиле. Лицензия в предоставленных данных не указана.

Сценарии применения

  • создание иллюстраций в стиле «Аватара» по текстовому описанию
  • генерация персонажей в художественном стиле «Аватара»
  • создание концепт-арта по мотивам «Аватара»

Ограничения

Обучение проводилось на 60 изображениях персонажей «Аватара», поэтому модель ориентирована на воспроизведение этого стиля. Сведения о лицензии в предоставленных данных отсутствуют.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Dreambooth style: Avatar

Dreambooth finetuning of Stable Diffusion (v1.5.1) on Avatar art style by Lambda Labs.

About

This text-to-image stable diffusion model was trained with dreambooth.
Put in a text prompt and generate your own Avatar style image!
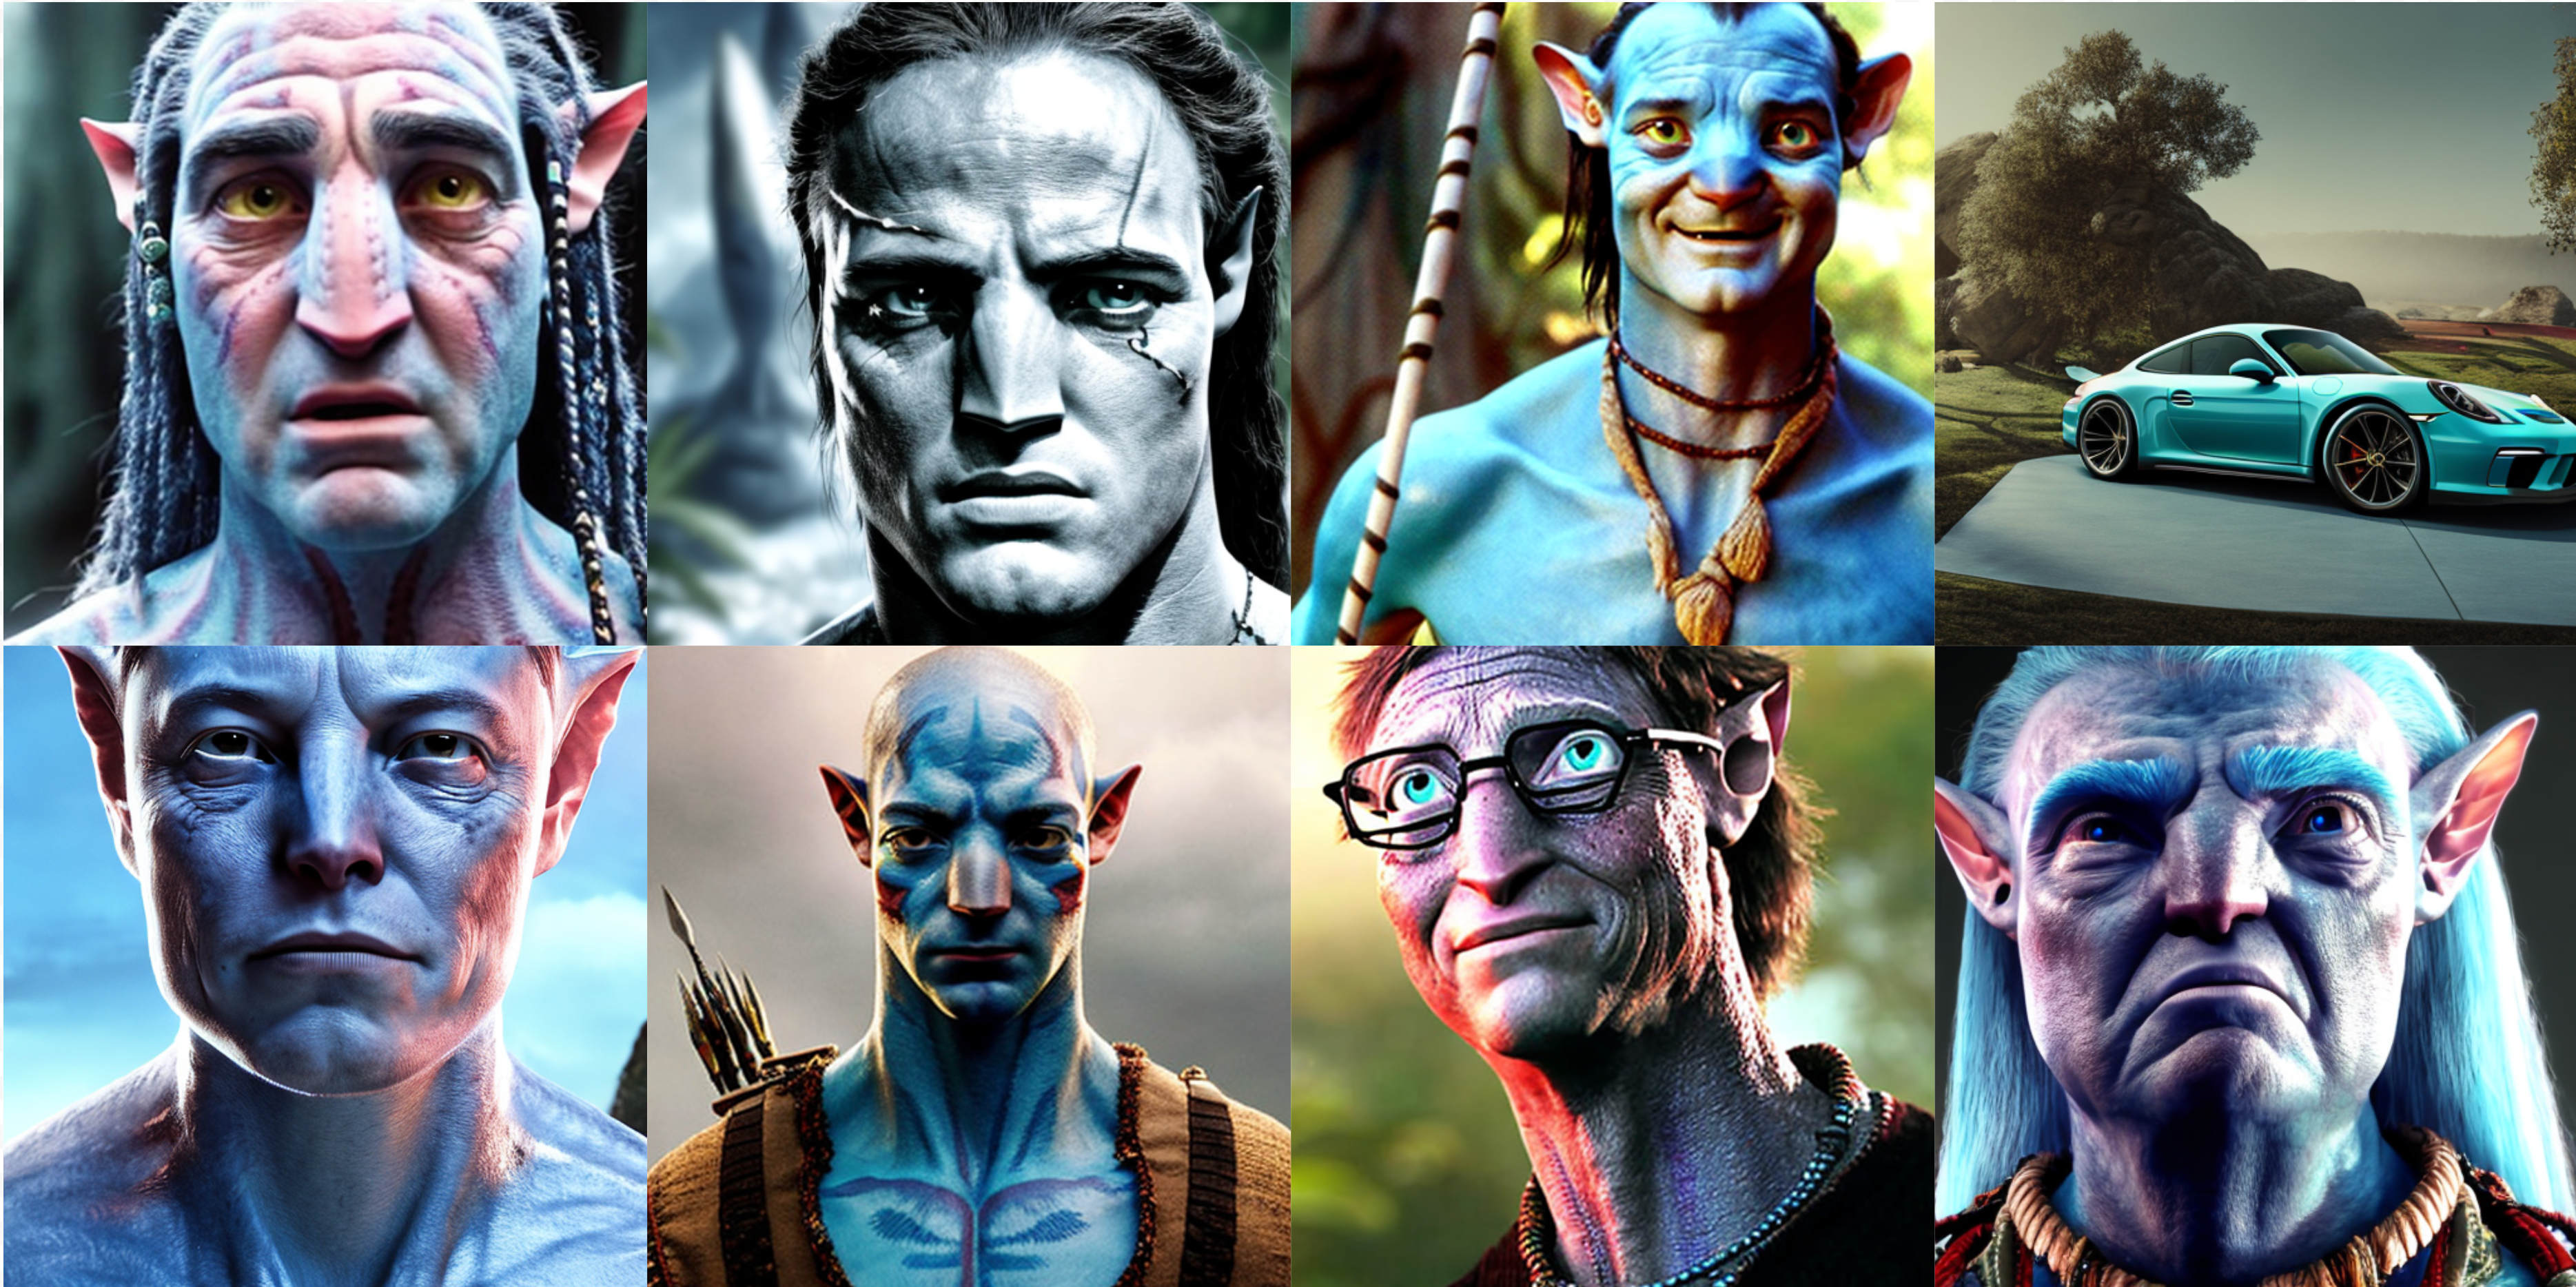
pk1.jpg

Usage

To run model locally:

pip install accelerate torchvision transformers>=4.21.0 ftfy tensorboard modelcards
import torch
from diffusers import StableDiffusionPipeline
from torch import autocast

pipe = StableDiffusionPipeline.from_pretrained("lambdalabs/dreambooth-avatar", torch_dtype=torch.float16)  
pipe = pipe.to("cuda")

prompt = "Yoda, avatarart style"
scale = 7.5
n_samples = 4

with autocast("cuda"):
  images = pipe(n_samples*[prompt], guidance_scale=scale).images

for idx, im in enumerate(images):
  im.save(f"{idx:06}.png")

Model description

Base model is Stable Diffusion v1.5 and was trained using Dreambooth with 60 input images sized 512x512 displaying Avatar character images. The model is learning to associate Avatar images with the style tokenized as 'avatarart style'. Prior preservation was used during training using the class 'Person' to avoid training bleeding into the representations for that class. Training ran on 2xA6000 GPUs on Lambda GPU Cloud for 700 steps, batch size 4 (a couple hours, at a cost of about $4).

Author: Eole Cervenka

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Ревизия весов
b737195

0 моделей