/ Модель

Характеристики

Контекст
8 192 токена
Параметры
7,5 млрд
Размер весов
16,1 ГБ
Лицензия
Своя лицензия
Архитектура
llama · dense
Опубликована
26 мая 2024

NeuralLlama-3-8B-Instruct-abliterated

Генерация текстаТекст → текст4 профессии

Экспериментальная DPO-версия Llama 3 Instruct для диалогов и генерации текста с ослабленными ограничениями отказа.

55скачиваний за 30 дней9лайковвеса обновлены27 мая 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

NeuralLlama-3-8B-Instruct-abliterated — экспериментальная DPO-модель mlabonne на архитектуре Llama 3 Instruct с 7,5 млрд параметров. Она дообучена на полном наборе mlabonne/orpo-dpo-mix-40k и предназначена для диалогов и генерации текста, в том числе ролевых сценариев. Автор сообщает, что дообучение повышает результаты исходной модели и восстанавливает часть показателя MMLU, утраченного после abliteration.

Модель принимает текст и выдаёт текст; контекст — до 8192 токенов. В README лицензия не описана, а в метаданных указано значение «other», поэтому конкретные условия использования по этим данным определить нельзя.

Сценарии применения

  • ведение диалогов с моделью
  • ролевая игра и генерация реплик персонажей
  • генерация текста по запросу
  • эксперименты с uncensored-моделями

Ограничения

Автор характеризует модель как экспериментальную; отдельные заявления о повышении качества приведены в README без подробностей методики оценки. Конкретные условия лицензии из доступных данных неясны.

Для каких профессий подходит4

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Llama-3-8B-Instruct-abliterated-dpomix

This model is an experimental DPO fine-tune of an abliterated Llama 3 8B Instruct model on the full mlabonne/orpo-dpo-mix-40k dataset. It improves Llama 3 8B Instruct's performance while being uncensored.

🔎 Applications

This is an uncensored model. You can use it for any application that doesn't require alignment, like role-playing.

Tested on LM Studio using the "Llama 3" preset.

⚡ Quantization

🏆 Evaluation

Open LLM Leaderboard

This model improves the performance of the abliterated source model and recovers the MMLU that was lost in the abliteration process.
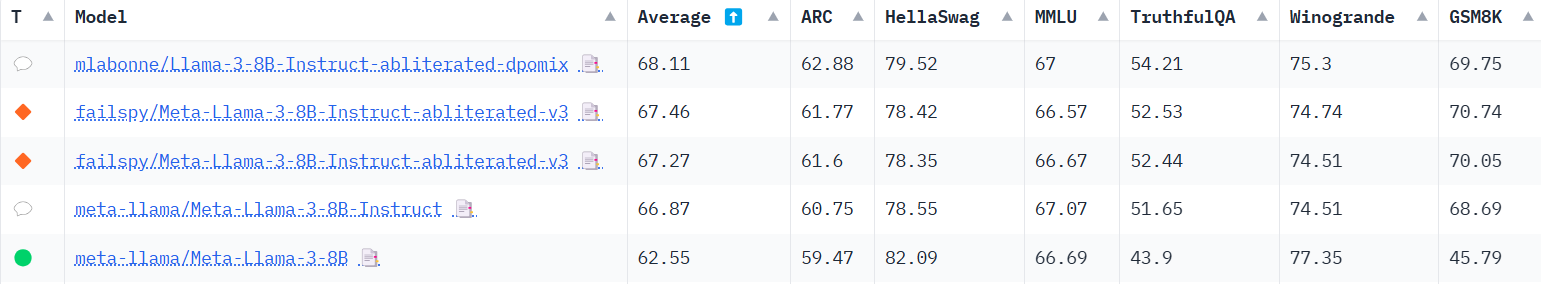
image/png

Nous

ModelAverageAGIEvalGPT4AllTruthfulQABigbench
mlabonne/Llama-3-8B-Instruct-abliterated-dpomix 📄52.2641.669.9554.2243.26
meta-llama/Meta-Llama-3-8B-Instruct 📄51.3441.2269.8651.6542.64
failspy/Meta-Llama-3-8B-Instruct-abliterated-v3 📄51.2140.2369.552.4442.69
abacusai/Llama-3-Smaug-8B 📄49.6537.1569.1251.6640.67
mlabonne/OrpoLlama-3-8B 📄48.6334.1770.5952.3937.36
meta-llama/Meta-Llama-3-8B 📄45.4231.169.9543.9136.7

💻 Usage

!pip install -qU transformers accelerate

from transformers import AutoTokenizer
import transformers
import torch

model = "mlabonne/Llama-3-8B-Instruct-abliterated-dpomix"
messages = [{"role": "user", "content": "What is a large language model?"}]

tokenizer = AutoTokenizer.from_pretrained(model)
prompt = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    torch_dtype=torch.float16,
    device_map="auto",
)

outputs = pipeline(prompt, max_new_tokens=256, do_sample=True, temperature=0.7, top_k=50, top_p=0.95)
print(outputs[0]["generated_text"])

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
LlamaForCausalLM
Ревизия весов
09c9096

0 моделей