/ Модель

Характеристики

Лицензия
MIT
Архитектура
vision-encoder-decoder · dense
Опубликована
19 июл 2022

donut-base-finetuned-docvqa

Вопросы по документамИзображение, файл, текст → текст10 профессий

Donut — дообученная на DocVQA модель, которая отвечает на вопросы по изображениям документов, напрямую преобразуя их в текст.

12 032скачиваний за 30 дней282лайкавеса обновлены9 мар 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Распознавание текста» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Donut — модель для ответов на вопросы по изображениям документов, разработанная командой NAVER CLOVA и дообученная на наборе DocVQA. Она принимает изображение документа и текстовый вопрос, затем генерирует ответ на естественном языке.

Архитектура сочетает визуальный энкодер Swin Transformer и текстовый декодер BART; модель работает по схеме vision-encoder-decoder. В отличие от OCR-конвейера, Donut напрямую преобразует изображение в текст, не требуя отдельного этапа распознавания текста. Модель рассчитана на визуальный вопросно-ответный анализ документов.

Репозиторий содержит веса PyTorch, лицензия — MIT. Модель специализирована на DocVQA; точность может снижаться на документах, отличающихся от обучающих данных, и при вопросах, требующих информации, отсутствующей или плохо читаемой на изображении.

Сценарии применения

  • ответы на вопросы по сканам и фотографиям документов
  • извлечение значений из счетов и форм по запросу
  • поиск реквизитов в изображениях деловых документов

Ограничения

Модель дообучена на DocVQA и может хуже работать с типами документов и формулировками вопросов, отличающимися от обучающих данных. Ответы зависят от читаемости изображения и могут быть ненадёжными, если нужная информация отсутствует или плохо различима.

Для каких профессий подходит10

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Donut (base-sized model, fine-tuned on DocVQA)

Donut model fine-tuned on DocVQA. It was introduced in the paper OCR-free Document Understanding Transformer by Geewok et al. and first released in this repository.

Disclaimer: The team releasing Donut did not write a model card for this model so this model card has been written by the Hugging Face team.

Model description

Donut consists of a vision encoder (Swin Transformer) and a text decoder (BART). Given an image, the encoder first encodes the image into a tensor of embeddings (of shape batch_size, seq_len, hidden_size), after which the decoder autoregressively generates text, conditioned on the encoding of the encoder.
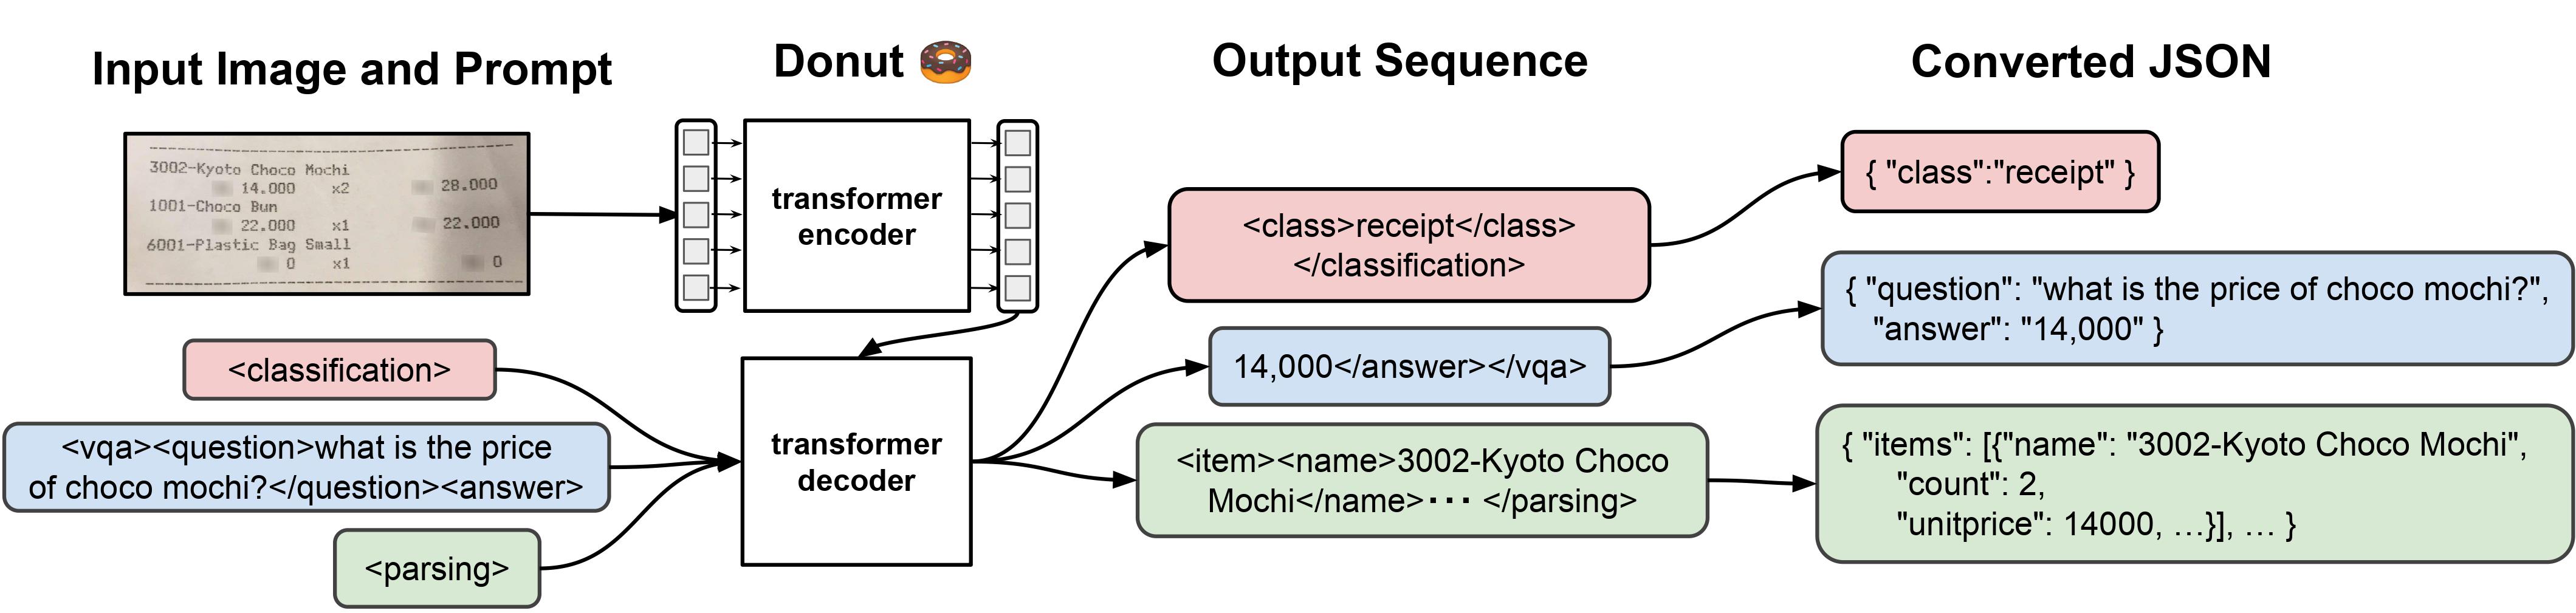
model image

Intended uses & limitations

This model is fine-tuned on DocVQA, a document visual question answering dataset.

We refer to the documentation which includes code examples.

BibTeX entry and citation info

@article{DBLP:journals/corr/abs-2111-15664,
  author    = {Geewook Kim and
               Teakgyu Hong and
               Moonbin Yim and
               Jinyoung Park and
               Jinyeong Yim and
               Wonseok Hwang and
               Sangdoo Yun and
               Dongyoon Han and
               Seunghyun Park},
  title     = {Donut: Document Understanding Transformer without {OCR}},
  journal   = {CoRR},
  volume    = {abs/2111.15664},
  year      = {2021},
  url       = {https://arxiv.org/abs/2111.15664},
  eprinttype = {arXiv},
  eprint    = {2111.15664},
  timestamp = {Thu, 02 Dec 2021 10:50:44 +0100},
  biburl    = {https://dblp.org/rec/journals/corr/abs-2111-15664.bib},
  bibsource = {dblp computer science bibliography, https://dblp.org}
}

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
VisionEncoderDecoderModel
Ревизия весов
b19d2e3

0 моделей