/ Модель

Характеристики

Контекст
2 048 токенов
Параметры
6,6 млрд
Размер весов
16,4 ГБ
Лицензия
MIT
Архитектура
mplug_owl2 · dense
Опубликована
22 дек 2023

one-align

Генерация текстаТекст → текст3 профессии

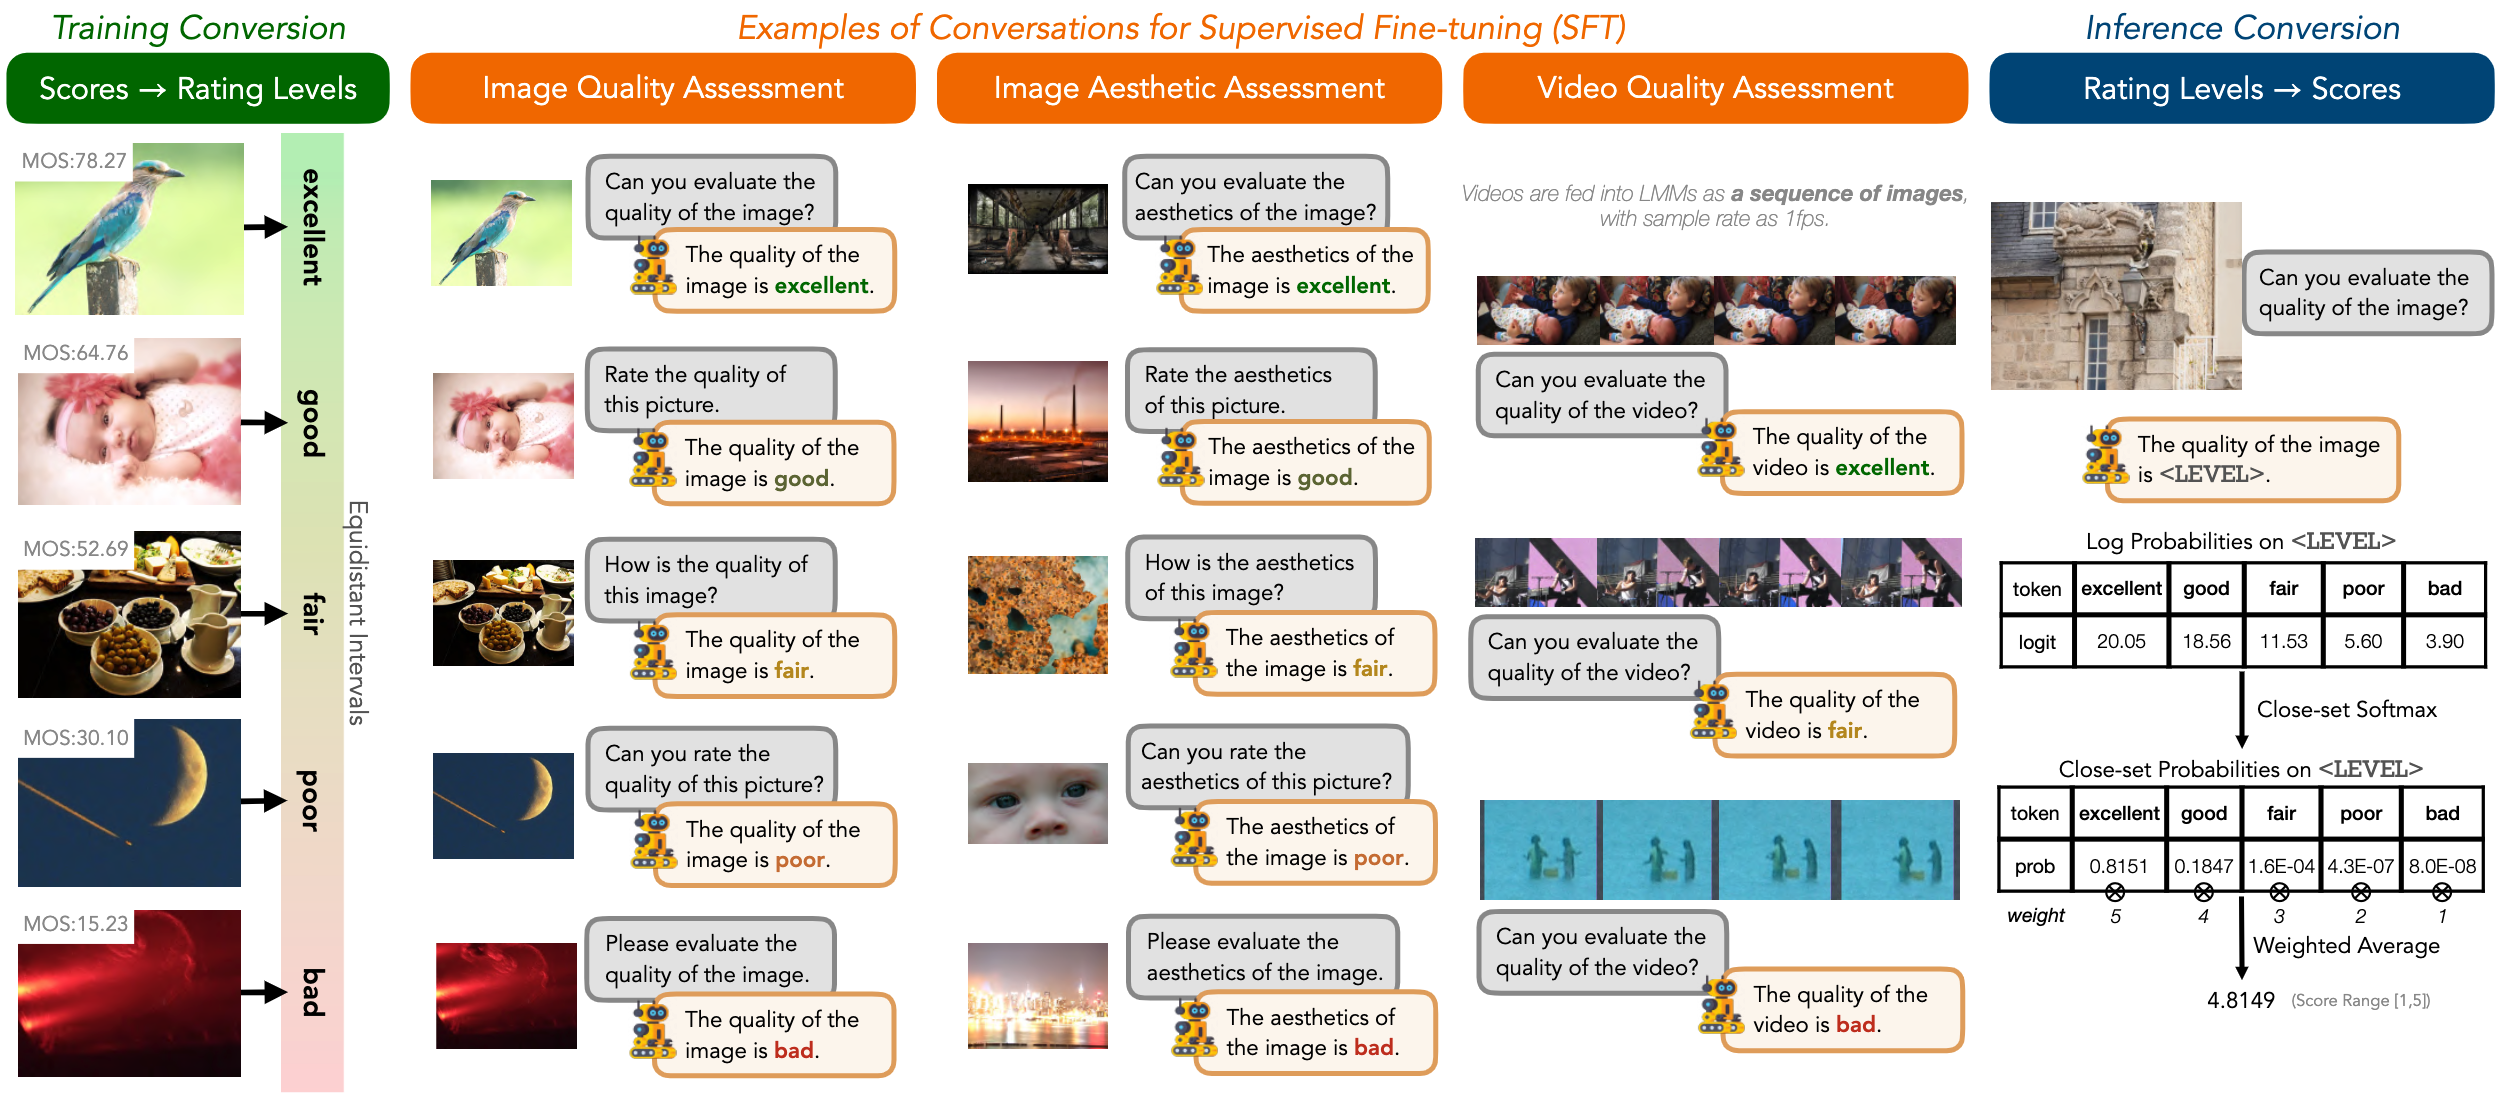
Q-Align — мультимодальная модель Q-Future для оценки качества и эстетики изображений, а также качества видео.

26 097скачиваний за 30 дней46лайковвеса обновлены14 мая 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Q-Align — модель компании Q-Future для оценки визуального качества изображений и видео. Она основана на архитектуре mPLUG-Owl2 и имеет 6,6 млрд параметров; репозиторий содержит веса PyTorch, а лицензия — MIT.

Модель предназначена для оценки качества изображений без эталона и с эталоном, эстетической оценки изображений и оценки качества видео. В карточке приведены результаты на наборах KonIQ, SPAQ, KADID, LIVE-C, LIVE, CSIQ, AGIQA, AVA и наборах видео, включая тестирование на некоторых данных, не встречавшихся при обучении. Метаданные также указывают поддержку классификации изображений с нулевым обучением и генерации текста; README описывает запуск модели как оценщика, а не подробные сценарии этих задач.

Модель принимает изображения и видео и выдаёт текстовые оценки или ответы о качестве; встроенный контекст составляет 2048 токенов. README рекомендует для запуска transformers версии 4.36.1. Языки карточки не указаны. Результаты зависят от набора данных и не гарантируют одинакового качества для любых типов изображений и видео.

Сценарии применения

  • оценка качества фотографии без эталонного изображения
  • сравнение изображения с эталоном по качеству
  • оценка эстетической привлекательности изображения
  • оценка воспринимаемого качества видеоролика
  • классификация изображения по текстовым описаниям без дообучения

Ограничения

Показатели качества приведены для конкретных наборов данных и не гарантируют аналогичных результатов на других типах контента. В карточке не описаны поддерживаемые естественные языки.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

The model that corresponds to Q-Align (ICML2024).

Quick Start with AutoModel

For this image, start an AutoModel scorer with transformers==4.36.1:
import requests
import torch
from transformers import AutoModelForCausalLM

model = AutoModelForCausalLM.from_pretrained("q-future/one-align", trust_remote_code=True, attn_implementation="eager", 
                                             torch_dtype=torch.float16, device_map="auto")

from PIL import Image
url = "https://raw.githubusercontent.com/Q-Future/Q-Align/main/fig/singapore_flyer.jpg"
image = Image.open(requests.get(url,stream=True).raw)
model.score([image], task_="quality", input_="image")
# task_ : quality | aesthetics; # input_: image | video

Result should be 1.911 (in range [1,5], higher is better).

From paper: arxiv.org/abs/2312.17090.

Syllabus
IQA Results (Spearman/Pearson/Kendall)

DatasetsKonIQ (NR-IQA, seen)SPAQ (NR-IQA, Seen)KADID (FR-IQA, Seen)LIVE-C (NR-IQA, Unseen)LIVE (FR-IQA, Unseen)CSIQ (FR-IQA, Unseen)AGIQA (AIGC, Unseen)
Previous SOTA0.916/0.928 (MUSIQ, ICCV2021)0.922/0.919 (LIQE, CVPR2023)0.934/0.937 (CONTRIQUE, TIP2022)NANANANA
Q-Align (IQA)0.937/0.945/0.7850.931/0.933/0.7630.934/0.934/0.7770.887/0.896/0.7060.874/0.840/0.6820.845/0.876/0.6540.731/0.791/0.529
Q-Align (IQA+VQA)0.944/0.949/0.7970.931/0.934/0.7640.952/0.953/0.8090.892/0.899/0.7150.874/0.846/0.6840.852/0.876/0.6630.739/0.782/0.526
OneAlign (IQA+IAA+VQA)0.941/0.950/0.7910.932/0.935/0.7660.941/0.942/0.7910.881/0.894/0.6990.887/0.856/0.6990.881/0.906/0.6990.801/0.838/0.602

IAA Results (Spearman/Pearson)

DatasetAVA_test
VILA (CVPR, 2023)0.774/0.774
LIQE (CVPR, 2023)0.776/0.763
Aesthetic Predictor (retrained on AVA_train)0.721/0.723
Q-Align (IAA)0.822/0.817
OneAlign (IQA+IAA+VQA)0.823/0.819

VQA Results (Spearman/Pearson)

DatasetsLSVQ_testLSVQ_1080pKoNViD-1kMaxWell_test
SimpleVQA (ACMMM, 2022)0.867/0.8610.764/0.8030.840/0.8340.720/0.715
FAST-VQA (ECCV 2022)0.876/0.8770.779/0.8140.859/0.8550.721/0.724
Q-Align (VQA)0.883/0.8820.797/0.8300.865/0.8770.780/0.782
Q-Align (IQA+VQA)0.885/0.8830.802/0.8290.867/0.8800.781/0.787
OneAlign (IQA+IAA+VQA)0.886/0.8860.803/0.8370.876/0.8880.781/0.786

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Нельзя запустить

Модели нужен код из репозитория; автор пока не в списке доверенных организаций.

Класс архитектуры
MPLUGOwl2LlamaForCausalLM
Ревизия весов
dcc603b

0 моделей