/ Модель

Характеристики

Контекст
131 072 токена
Параметры
3,2 млрд
Размер весов
12,1 ГБ
Лицензия
Llama 3.2
Архитектура
llama · dense
Базовая модель
LLaMa-3.2-Instruct-JankMix-v0.2-SFT-3B
Опубликована
28 окт 2024

LLaMa-3.2-Instruct-JankMix-v0.2-SFT-HailMary-v0.1-KTO-3B

Генерация текстаТекст → текст3 профессии

Экспериментально дообученная методом KTO модель LLaMA на 3,2 млрд параметров для диалогов, ролевых сценариев и генерации историй.

23скачиваний за 30 дней2лайкавеса обновлены28 окт 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки6

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

  • MMLU-PRO

    MMLU-PRO Raw · выше — лучше

    Результат

    0,3108

    Open LLM v2 · архив

    Публичная таблицадругая ревизия

  • GPQA

    GPQA Raw · выше — лучше

    Результат

    0,2718

    Open LLM v2 · архив

    Публичная таблицадругая ревизия

  • BBH

    BBH Raw · выше — лучше

    Результат

    0,4511

    Open LLM v2 · архив

    Публичная таблицадругая ревизия

  • MATH Lvl 5

    MATH Lvl 5 Raw · выше — лучше

    Результат

    0,1261

    Open LLM v2 · архив

    Публичная таблицадругая ревизия

  • IFEval

    IFEval Raw · выше — лучше

    Результат

    0,6504

    Open LLM v2 · архив

    Публичная таблицадругая ревизия

  • MUSR

    MUSR Raw · выше — лучше

    Результат

    0,3687

    Open LLM v2 · архив

    Публичная таблицадругая ревизия

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

PJMixers-Dev дообучила эту плотную авторегрессионную модель семейства LLaMA с 3,2 млрд параметров методом KTO с функцией потерь apo_zero_unpaired на базе PJMixers-Dev/LLaMa-3.2-Instruct-JankMix-v0.2-SFT-3B. В обучающую смесь вошли наборы инструкций, ролевых диалогов и генерации историй; отклонённые примеры создавались из ответов базовой SFT-модели с намеренно ухудшенными настройками.

Модель предназначена для генерации текста и диалогового взаимодействия, включая ответы на инструкции, ролевые диалоги и написание историй. В метаданных заявлено контекстное окно 131 072 токена, однако при обучении использовалась максимальная длина 6 144 токена. Карточка описывает эксперимент как тест теста: обучение завершилось сбоем и не достигло полного цикла, поэтому качество и устойчивость модели могут быть ограничены. Лицензия — Llama 3.2.

Сценарии применения

  • ответы на инструкции в диалоге
  • ролевые диалоги и отыгрыш персонажей
  • написание коротких историй
  • эксперименты с выравниванием ответов методом KTO

Ограничения

Обучение завершилось сбоем и не достигло полного цикла; автор характеризует модель как тест эксперимента. Обучение проводилось с максимальной длиной 6 144 токена, что заметно меньше заявленного в метаданных контекстного окна.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

PJMixers-Dev/LLaMa-3.2-Instruct-JankMix-v0.2-SFT-3B was further trained using KTO (with apo_zero_unpaired loss type) using a mix of instruct, RP, and storygen datasets. I created rejected samples by using the SFT with bad settings (including logit bias) for every model turn.

The model was only trained at max_length=6144, and is nowhere near a full epoch as it eventually crashed. So think of this like a test of a test.

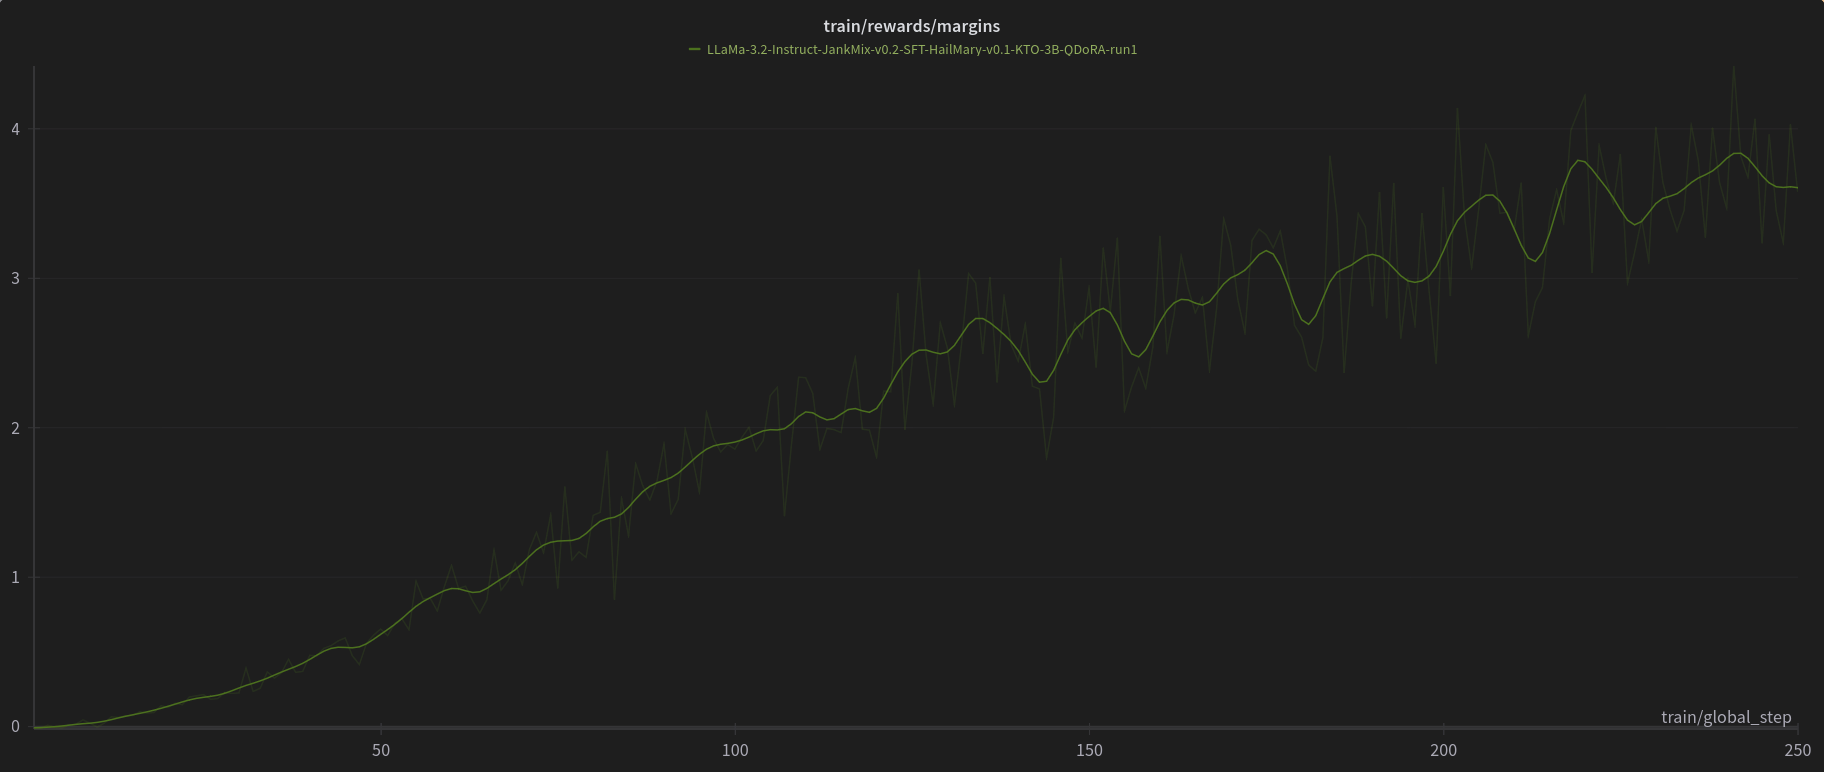
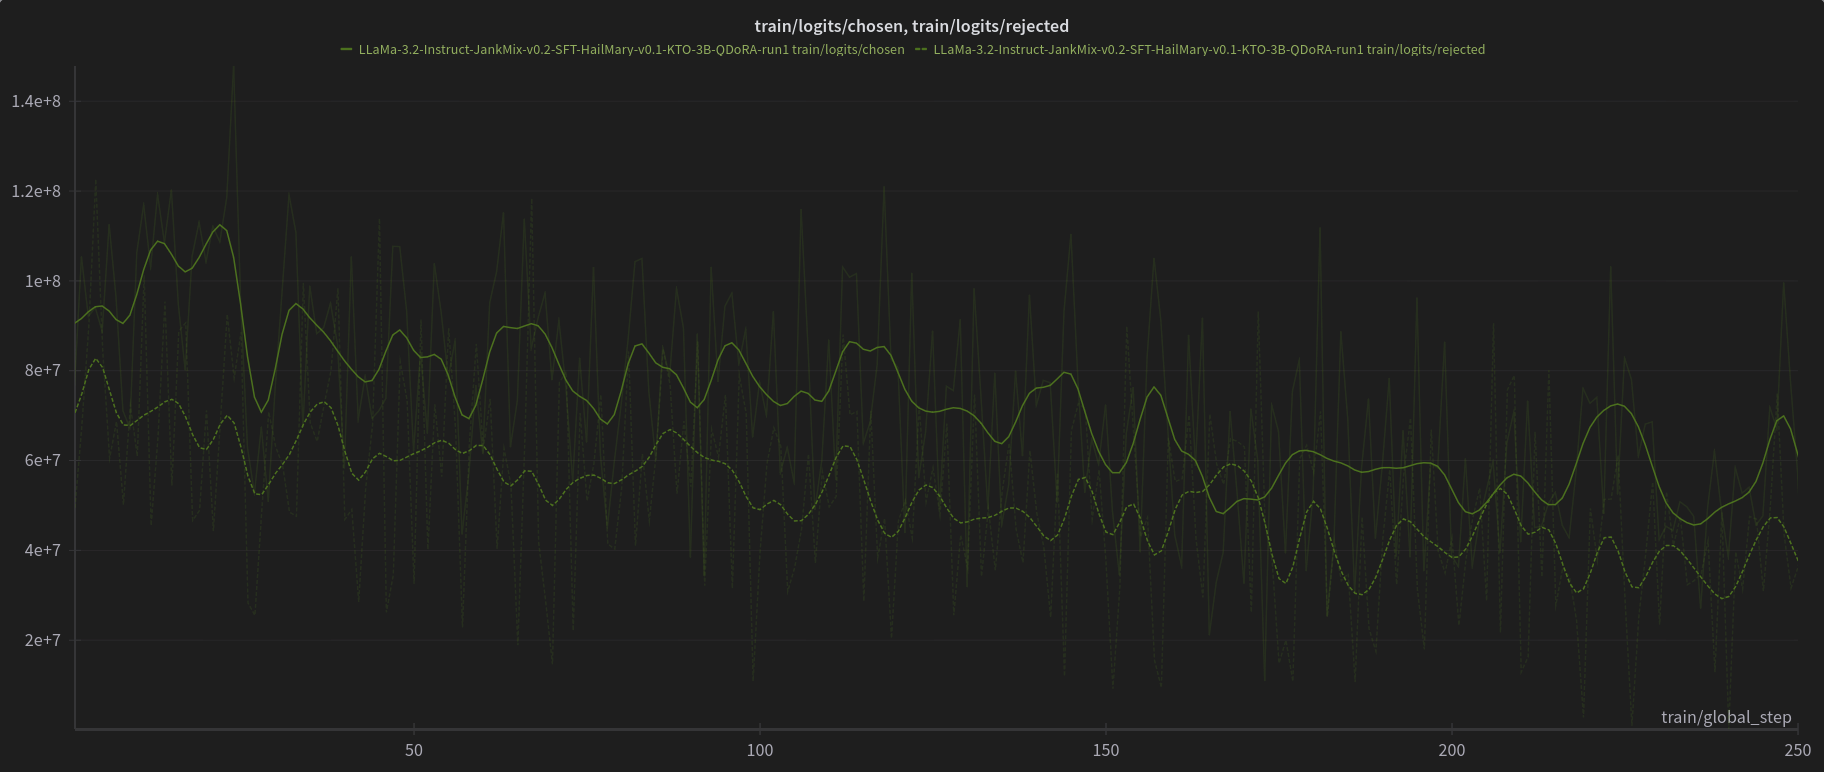
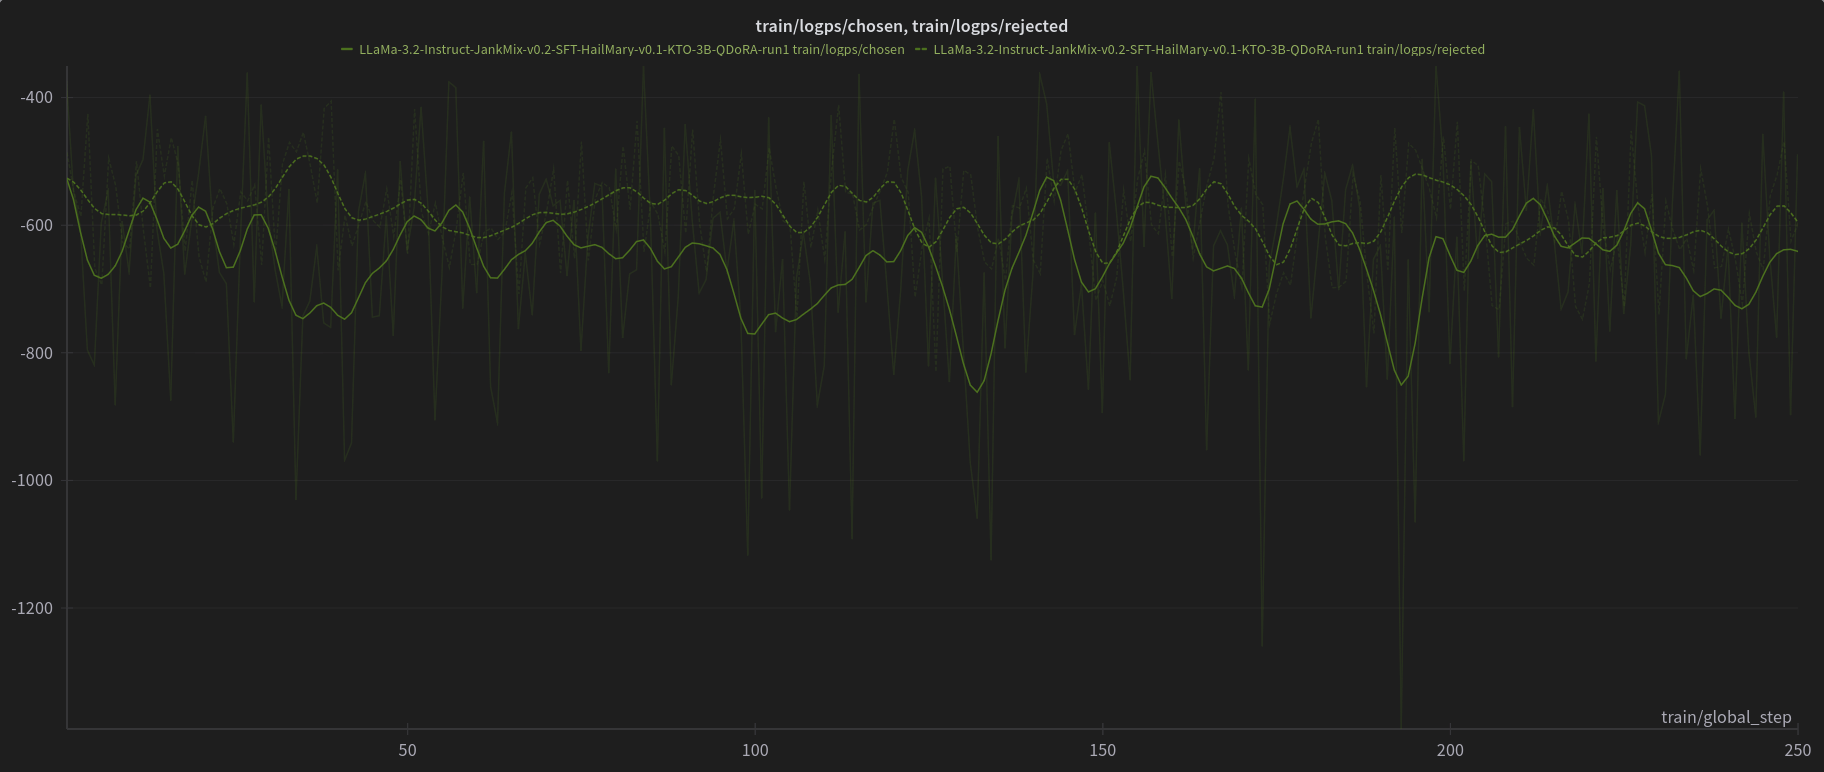
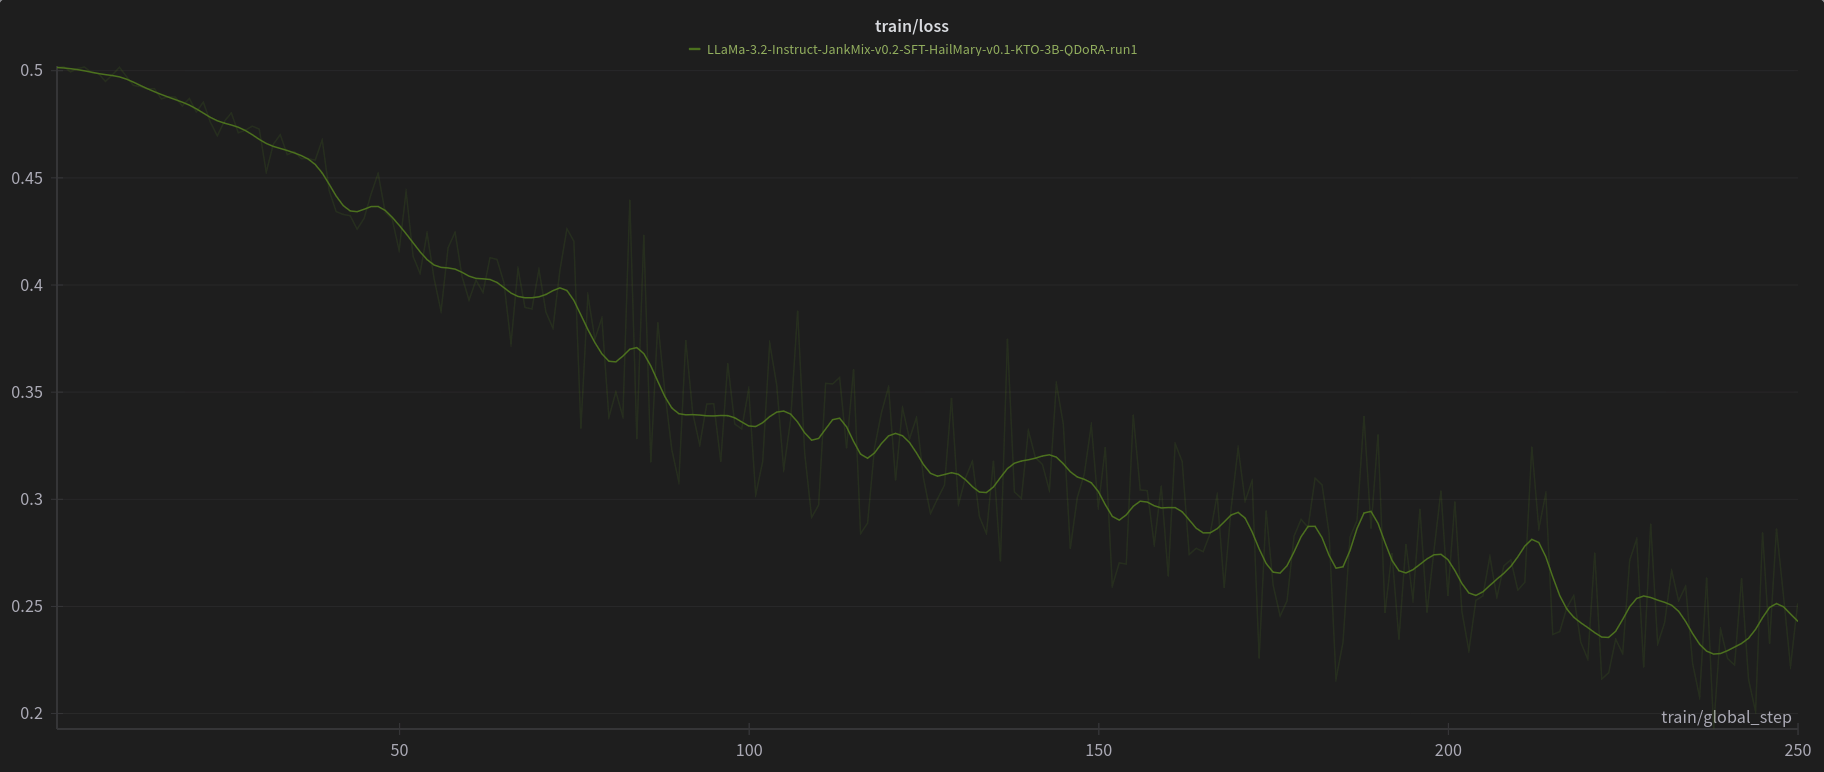
W&B Training Logs
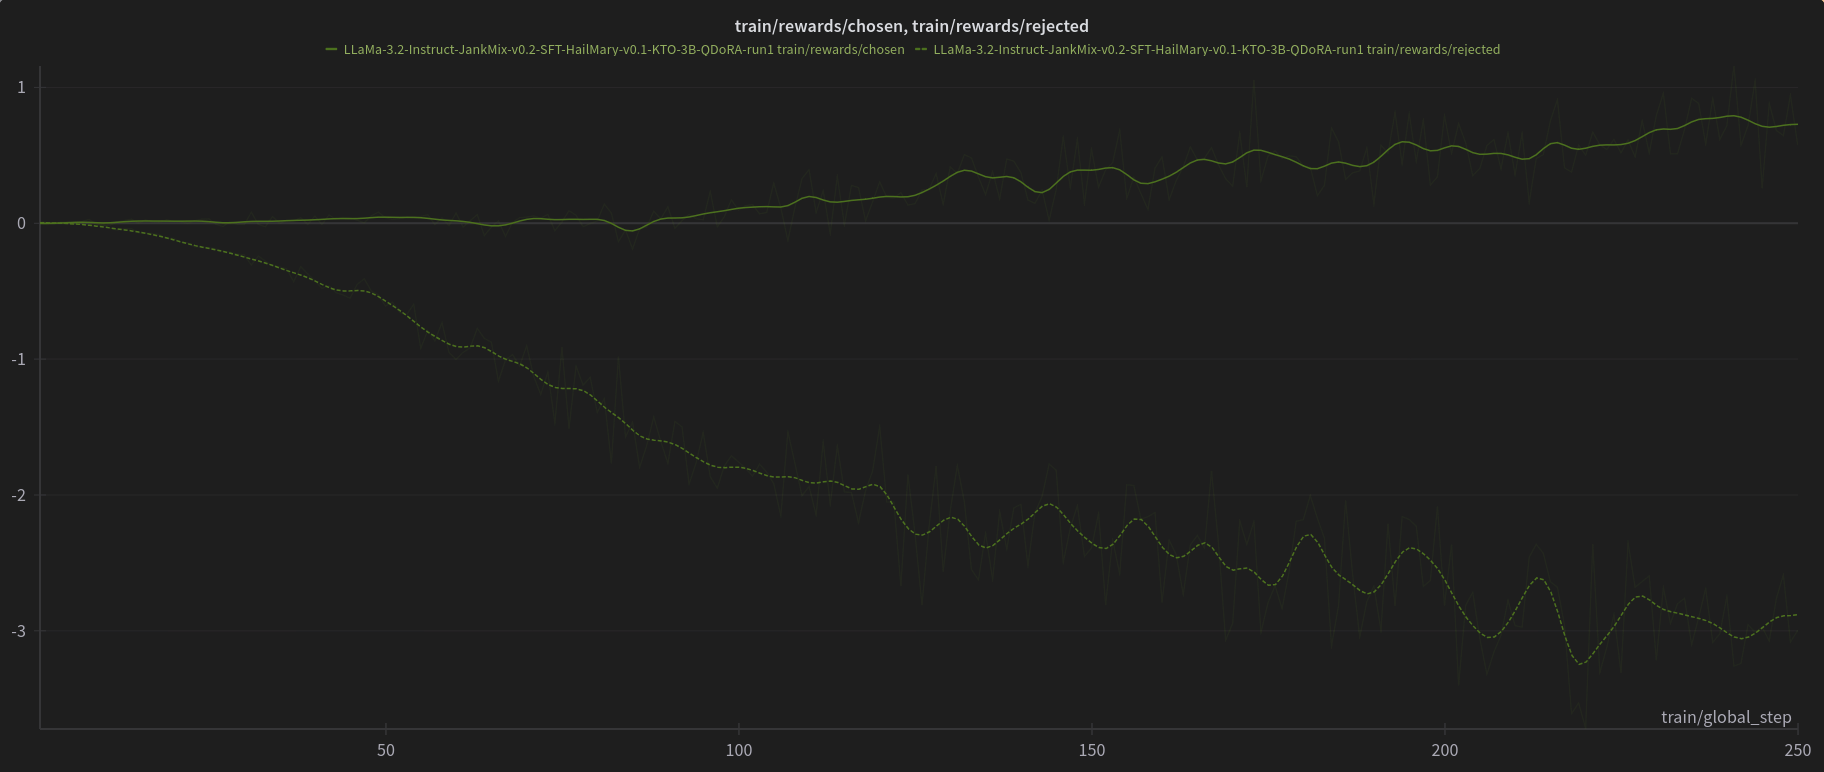
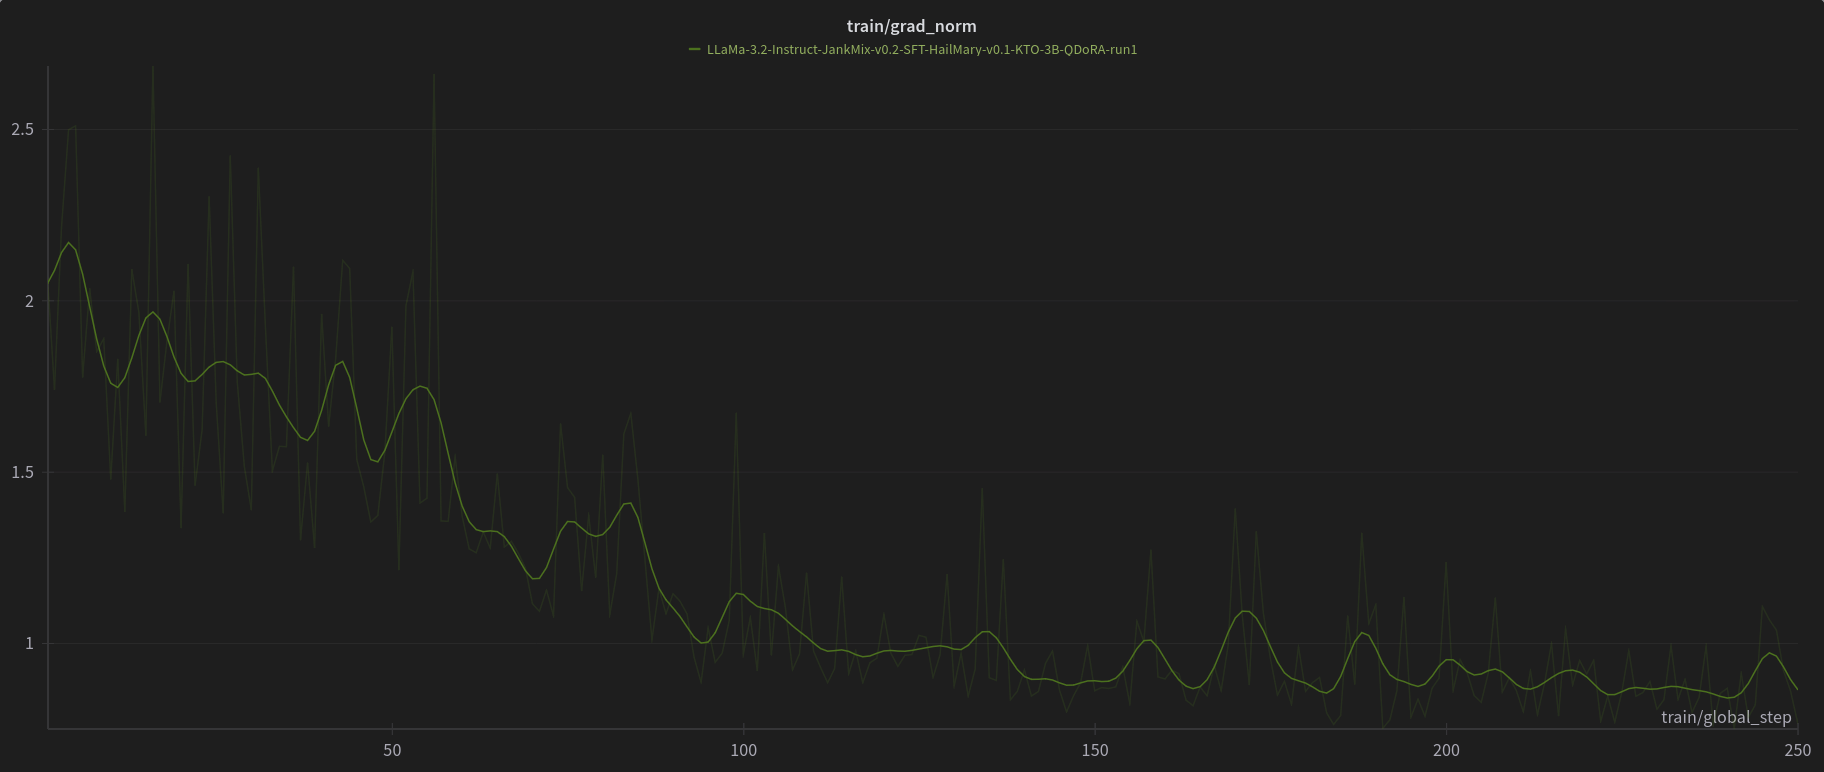
train/rewards/chosen/rejected train/rewards/margins train/logits/chosen/rejected train/logps/chosen/rejected train/loss train/grad_norm

Open LLM Leaderboard Evaluation Results

Detailed results can be found here

MetricValue
Avg.21.69
IFEval (0-Shot)65.04
BBH (3-Shot)22.29
MATH Lvl 5 (4-Shot)11.78
GPQA (0-shot)2.91
MuSR (0-shot)4.69
MMLU-PRO (5-shot)23.42

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
LlamaForCausalLM
Ревизия весов
31d3aa0

0 моделей